HelloWorld 开发者社区
科技资讯

Qwen4-Max 发布:百万 Token 上下文、多模态与长任务如何落地
Jync 2.2.1 发布:完善告警通知,修复 CDC 与 ETL 可靠性问题
phimint 0.10.0 发布:终端智能体加入交互输入处理
Cursor 更新安全事件调查:扩展分发、历史凭据与团队排查
SoduWork 开源,尝试用独立审查与插件治理组织智能体交付
百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
开源项目
全部项目推荐好文
爬虫进阶 - 前后端分离有什么了不起,过程超详细
这是一个详细的爬虫进阶教程,里面包含了很详细的思考和试错过程,如果你对学爬虫是认真的,建议认真看。我们要抓取下面这个网站上的所有图书列表:https://www.epubit.com/books1)探索研究创建一个新的python文件,写入如下代码:import requestsurl 'https://www.epubit.com/boo
程序员35岁就会被淘汰?看我如何击碎这个互联网最大的谣言!(深度好文,建议收藏!)
前言大家好,我是秃顶的码哥!前几天和同事聊到一个比较尴尬的话题,程序员该如何面对35岁的这道坎?(之所以感到尴尬,是因为码哥也即将35岁了)!!11.png(https://imghelloworld.osscnbeijing.aliyuncs.com/img
反爬虫策略手把手教你使用FastAPI来限制接口的访问速率
在网络爬虫的过程中,我们都会遇到各种各样的反爬虫,封禁IP和账号,设置验证码,前端加密,浏览器指纹,甚至输出假数据来等等都是可能出现的反爬手段,这些我们今天一个也不会谈及,而是谈谈一种叫访问速率限制的手段。对于服务端而言,有时候会碰到这么一个场景:某个接口需要在某个时间段内设置最高的访问次数来降低服务器的压力,比如之前用的某度的一些接口,一分钟内访问
使用Scrapy网络爬虫框架小试牛刀
前言这次咱们来玩一个在Python中很牛叉的爬虫框架——Scrapy。scrapy介绍标准介绍Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍。所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等)的具有很强通用性的项目模板。对于框架的学习,重点是要学习其框架的特性、各个功能的
Python爬虫小白教学篇:豆瓣9.3超高评分《觉醒年代》热评爬取生成精美词云!!!
精美词云!在这里插入图片描述(https://imghelloworld.osscnbeijing.aliyuncs.com/imgs/0a512b857ad6557cb69d0edbcebeecab.png)!在这里插入图片描述(https://im
纯干货:手把手教你用Python做数据可视化(附代码)
前言Hi,大家好,又见面了,我是Python进阶者,废话不多说,直接开始肝吧,奥里给!爬虫管理效果图依赖包文件:requirements.txt文件的内容这里直接贴出来了:appdirs1.4.4APScheduler3.5.1attrs20.1.0Automat20.2.0beautifulsoup44.9.1certifi202
为什么隧道代理没有更换IP?
转载:为什么你的隧道代理没有更换IP(https://link.segmentfault.com/?enchoUiaNqN%2Fl3wlz%2B2S8PRvA%3D%3D.cz%2FfjD62Bs7l1O3hia1qAOinrYh5vyMVlM3SweY%2ByELLcZWjgI
Python爬虫 | Selenium爬取当当畅销图书排行
01前言上篇文章我们爬取了,心情相当愉悦,今天这篇文章我们使用Selenium来爬取当当网的畅销图书排行。正所谓书中自有黄金屋,书中自有颜如玉,我们通过读书学习来提高自身的才华,自然能有荣华富贵,也自然少不了漂亮小姐姐。02准备工作在爬取数据前,我们需要安装Selenium库以及Chrome浏览器,并配置好Chro
Python爬虫 | 批量爬取今日头条街拍美图
专栏作者:霖hero,在职爬虫工程师,熟悉JS逆向与分布式爬虫。喜欢钻研,热爱学习,乐于分享。公众号后台回复入群,拉你进技术群与大佬们近距离交流。01前言大家好,我是J哥🚀在以前的文章中我们学了Ajax数据爬取,这篇文章我们以今日头条为例,通过分析Ajax请求来抓取今日头条的街拍美图,并将图片下载到本地保存下来。准备好没,我们现在开始!0

Python爬虫定时计划任务的几种常见方法
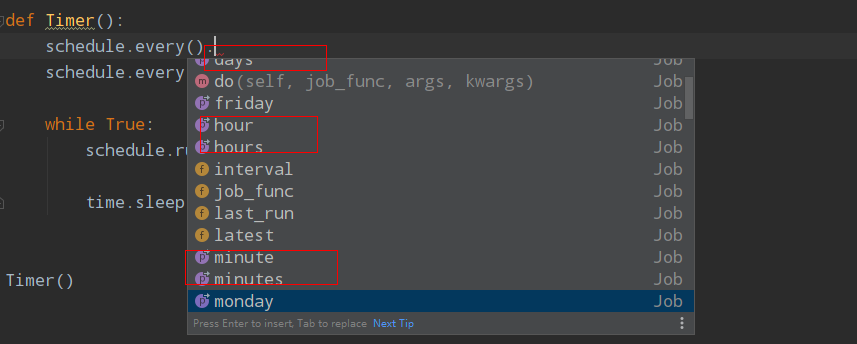
记得以前的Windows任务定时是可以正常使用的,今天试了下,发现不能正常使用了,任务计划总是挂起。接下来记录下Python爬虫定时任务的几种解决方法。1方法一、while True首先最容易的是whiletrue死循环挂起,不废话,直接上代码:import osimport timeimport sys from dateti
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。