HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
Scrapy框架中如何更改下载中间件里的headers?
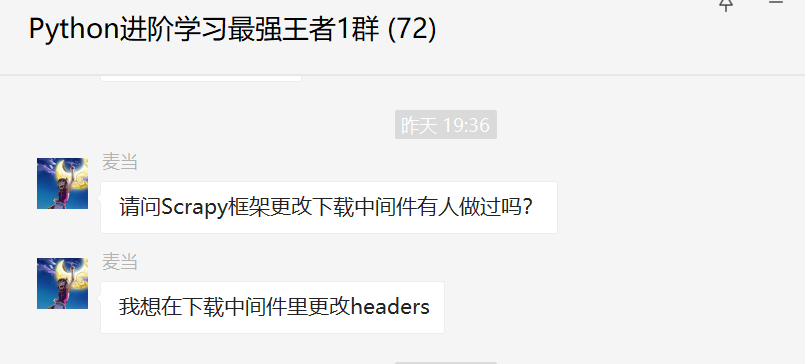
大家好,我是我是皮皮。一、前言前几天在Python最强王者交流群有个叫【麦当】的粉丝问了一个关于Scrapy框架中如何更改下载中间件里的headers问题,这里拿出来给大家分享下,一起学习。二、解决过程如果只是单纯的一次性添加,那么可以使用下面这个方式,直接在settings.py文件中设置:但是他想动态的修改,这样的话,单纯的修改就有点力不从心了。不过
scrapy 框架中用ssh连接远程服务器
前段时间用scrapy尝试抓取一些数据,~~写的时候真的很酸爽,眼睛要花掉了~~但是!我没有存到数据库中,也就是说我只是确认了爬虫的代码没问题(草)为什么我要用服务器的mysql,本地的不好吗?其实是我没有在本地装MySQL,但是我有服务器,再加上有phpmyadmin这么友好的we
Scrapy项目之User timeout caused connection failure(异常记录)
Windows10家庭中文版,Python3.6.4,Scrapy1.5.0,提示:此文存在问题,真正测试, 请勿阅读,_071414:26更新:_经过两个多小时的测试,发现此问题的原因是 昨天编写爬虫程序后,给爬虫程序添加了下面的属性:download\_timeout20此属性的解释:The
Scrapy笔记(1)
Scrapy笔记01入门篇 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。其最初是为了页面抓取(更确切来说,网络抓取)所设计的,也可以应用在获取API所返回的数据(比如WebServices)或者通用的网络爬虫。 Scr
Scrapy的架构介绍
Scrapy的架构介绍原始英文页面:http://doc.scrapy.org/en/latest/topics/architecture.html(https://www.oschina.net/action/GoToLink?urlhttp%3A%2F%2Fdoc.scrapy.org%2Fen%2Flatest%2Ft
Scrapy爬虫框架下执行爬虫的方法
在使用Scrapy框架进行爬虫时,执行爬虫文件的方法是scrapycrawlxxx,其中xxx是爬虫文件名。 但是,当我们在建立了多个文件时,使用上面的命令时会比较繁琐麻烦,我们就可以使用下述方法同时完成爬虫文件的执行。 第一种,在scrapy框架下建立一个运行文件,如run.py,在文件中建立一个列表,列表为爬虫的执行命令,
Scrapy爬虫框架
(1)、简介在糗事百科爬虫中我们的爬虫是继承scrapy.Spider类的,这也是基本的scrapy框架爬虫,在这个爬虫中我们自己在解析完整个页面后再获取下一页的url,然后重新发送了一个请求,而使用CrawlsSpider类可以帮助我们对url提出条件,只要满足这个条件,都进行爬取,CrawlSpider类继承自Spider,它比之前的Spid
Scrapy爬虫及案例剖析
!(https://oscimg.oschina.net/oscnet/upede1a7a938f161dbdaf6489a266e85e0347.JPEG)由于互联网的极速发展,所有现在的信息处于大量堆积的状态,我们既要向外界获取大量数据,又要在大量数据中过滤无用的数据。针对我们有益的数据需要我们进行指定抓取,从而出现了现在的爬虫技术,通过爬
Scrapy爬取遇到的一点点问题
学了大概一个月Scrapy,自己写了些东东,遇到很多问题,这几天心情也不大好,小媳妇人也不舒服,休假了,自己研究了很久,有些眉目了利用scrapy框架爬取慕课网的一些信息步骤一:新建项目 scrapystartprojectmuke 进入muke scrapygenspidermukewangimooc.co
Scrapy框架全
架构介绍Engine:引擎,处理整个系统的数据流处理,触发事物,是整个框架的核心Item:项目,他定义了爬取结果的数据结构,爬取的数据会被赋值成该Item对象Scheduler:调度器,接受引擎发过来的请求并将其加入到队列中,在引擎再次请求的时候将请求提供给引擎Downloader:下载器,下载网页内容,并将网页内容返回给spider
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。