HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
Katalon系列十九:元素相同或无法定位时的定位技巧
经常看到有人问元素属性都相同,怎么定位,这里总结一下。下面以Xpath为例讲解,CSS其实也是一样的,只是语法不一样罢了。网上说CSS会比Xpath快一些,但在Katalon主用Xpath,感觉也还行。另外Katalon做为一个产品,他们选择主打Xpath,相信也是有原因的。当然了,也有极小可能他们的骨干对Xpath比较熟。Katalon也支持CSS,
PO设计模式
开发环境:python3.6.5selenium2.48.0pytest框架Android5.1工具:pycharmAppiumGenymotion测试机型:SamsungGalaxyS6需求:设计3个测试用例1.实现点击设置显示放大镜(查找)输入内容点击返回按钮2.实现点击设置
🔥《手把手教你》系列基础篇之3
1\.简介上一篇中,只是简单地一带而过的说了一些驱动浏览器,这一篇继续说说驱动浏览器,然后再说一说元素定位的方法。完成环境的安装并测试之后,我们对Selenium有了一定的了解了,接下来我们继续驱动浏览器做一些基本操作:窗口尺寸设置、网页截图、刷新、前进和后退2\.窗口尺寸设置在测试过程中,我们可能会要求打开浏览器的窗
java程序实现JSON格式的报文转换成XPATH格式
注意:需要引入额外的jar包来支持这个程序“fastjson”。importcom.alibaba.fastjson.JSON;importcom.alibaba.fastjson.JSONObject;importjava.io.;publicclassTest{publicstaticvoidmain(String
Java根据XPath提取HTML
有这样一段HTML: <div<table<tdid'1234foo5678'Hello</td希望通过这个XPath提取出Hello://div//tdcontains(@id,'foo')/text()先导入maven依赖:<!https://mvnrepository.com/ar
Java&Selenium自动化测试调用JS实现单击
Java&Selenium自动化测试调用JS实现单击/themethodofinvokingjstodosomething@authordavieyang@create201808051:37
lxml简明教程
from:https://www.cnblogs.com/ospider/p/5911339.html最近要做下微信爬虫,之前写个小东西都是直接用正则提取数据就算了,如果需要更稳定的提取数据,还是使用xpath定位元素比较可靠。周末没事,从爬虫的角度研究了一下pythonxml相关的库。Python标准库中自带了xml模块,但是性能不
Python爬虫教程(二)
!开发者社区.png(https://imghelloworld.osscnbeijing.aliyuncs.com/imgs/7e33665384122d5ac72c674f5f4da06b.png)一、bs4解析介绍 1.bs4解析:BS4全称是B
使用Scrapy网络爬虫框架小试牛刀
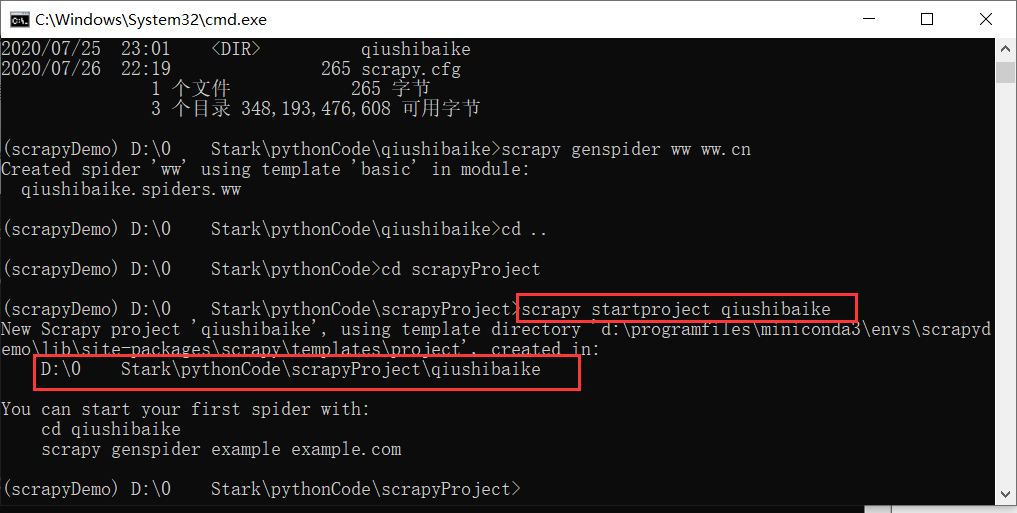
前言这次咱们来玩一个在Python中很牛叉的爬虫框架——Scrapy。scrapy介绍标准介绍Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍。所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等)的具有很强通用性的项目模板。对于框架的学习,重点是要学习其框架的特性、各个功能的
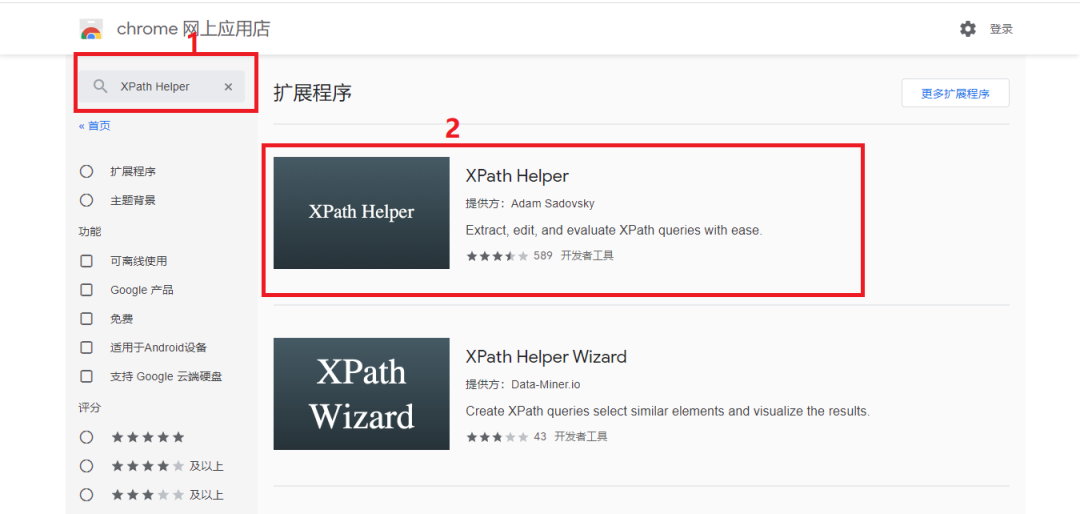
手把手教你使用XPath爬取免费代理IP
大家好,我是霖hero。前言可能有人说,初学者Python爬虫爬数据太难啦,构造正则表达式的时候,太烦琐了,眼睛都看花了,而且前一秒还可以愉快地爬取,下一秒IP就被封了,这还爬个屁啊,不爬了。哎,不要着急,这篇文章我们教你如何使用XPath来爬取快代理中的免费代理IP,告别眼花,告别IP被封的烦恼。XPath首先我们来简单了解一下XPath,想要了解更多
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。