HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
架构师必备:HBase行键设计与应用
首先要回答一个问题,为何要使用HBase?随着业务不断发展、数据量不断增大,MySQL数据库存在这些问题:MySQL支持的数据量为TB级,不能一直保留历史数据。而HBase支持的数据量为PB级,适合存储久远的历史冷数据新增列的代价较高,数据量越大耗费时间越长。而HBase可以随意增加
墨天轮访谈 | 京东云曲艺伟:京东零售核心业务背后的数据库实践
<blockquote<strong分享嘉宾</strong:<strong曲艺伟</strong京东云数据库产品经理<br/<strong整理</strong:<ahref"https://link.segmentfault.com/?encTLx6BN1dHtv8aZp
MaxCompute湖仓一体介绍
简介:本篇内容分享了MaxCompute湖仓一体介绍。分享人:孟硕阿里云MaxCompute产品专家视频链接:https://developer.aliyun.com/...(https://link.segmentfault.com/?encbDhshRDAWzwKBBQxqliE
为什么说 MongoDB 和 HBase 不适用于汽车行业的时序数据处理?
近年来,在能源和环保的压力下,新能源汽车成为了未来汽车发展的新方向。为支持其快速发展,我国出台了一系列扶持政策,在《新能源汽车产业发展规划(20212035年)》中就有提出,到2025年新能源汽车新车销售量要达到汽车新车销售总量的20%左右,其市场广阔程度可见一斑。现在火热的自动驾驶技术,
万字长文详解HBase读写性能优化
一、HBase读优化1.HBase客户端优化和大多数系统一样,客户端作为业务读写的入口,姿势使用不正确通常会导致本业务读延迟较高实际上存在一些使用姿势的推荐用法,这里一般需要关注四个问题:1)scan缓存是否设置合理?优化原理:在解释这
大数据培训HBase读写性能优化的详解
一、HBase读优化HBase客户端优化和大多数系统一样,客户端作为业务读写的入口,姿势使用不正确通常会导致本业务读延迟较高实际上存在一些使用姿势的推荐用法,这里一般需要关注四个问题:1)scan缓存是否设置合理?优化原理:在解释这个问题之前,首先需要解释什么是scan缓存,通
眼见不一定为实:调用链HBase倾斜修复
hello,大家好,我是小楼。今天给大家分享一个关于HBase数据倾斜的排查案例,不懂调用链?不懂HBase?没关系,看完包懂背景最近HBase负责人反馈HBase存储的调用链数据偶尔出现极其严重的倾斜情况,并且日常的倾斜情况也比较大,讲的通俗点就是出现了热点机器。举个例子,有三台HBase机器存储调用链数据,其中大部分数据读写都在一台机器上,导致机器负载
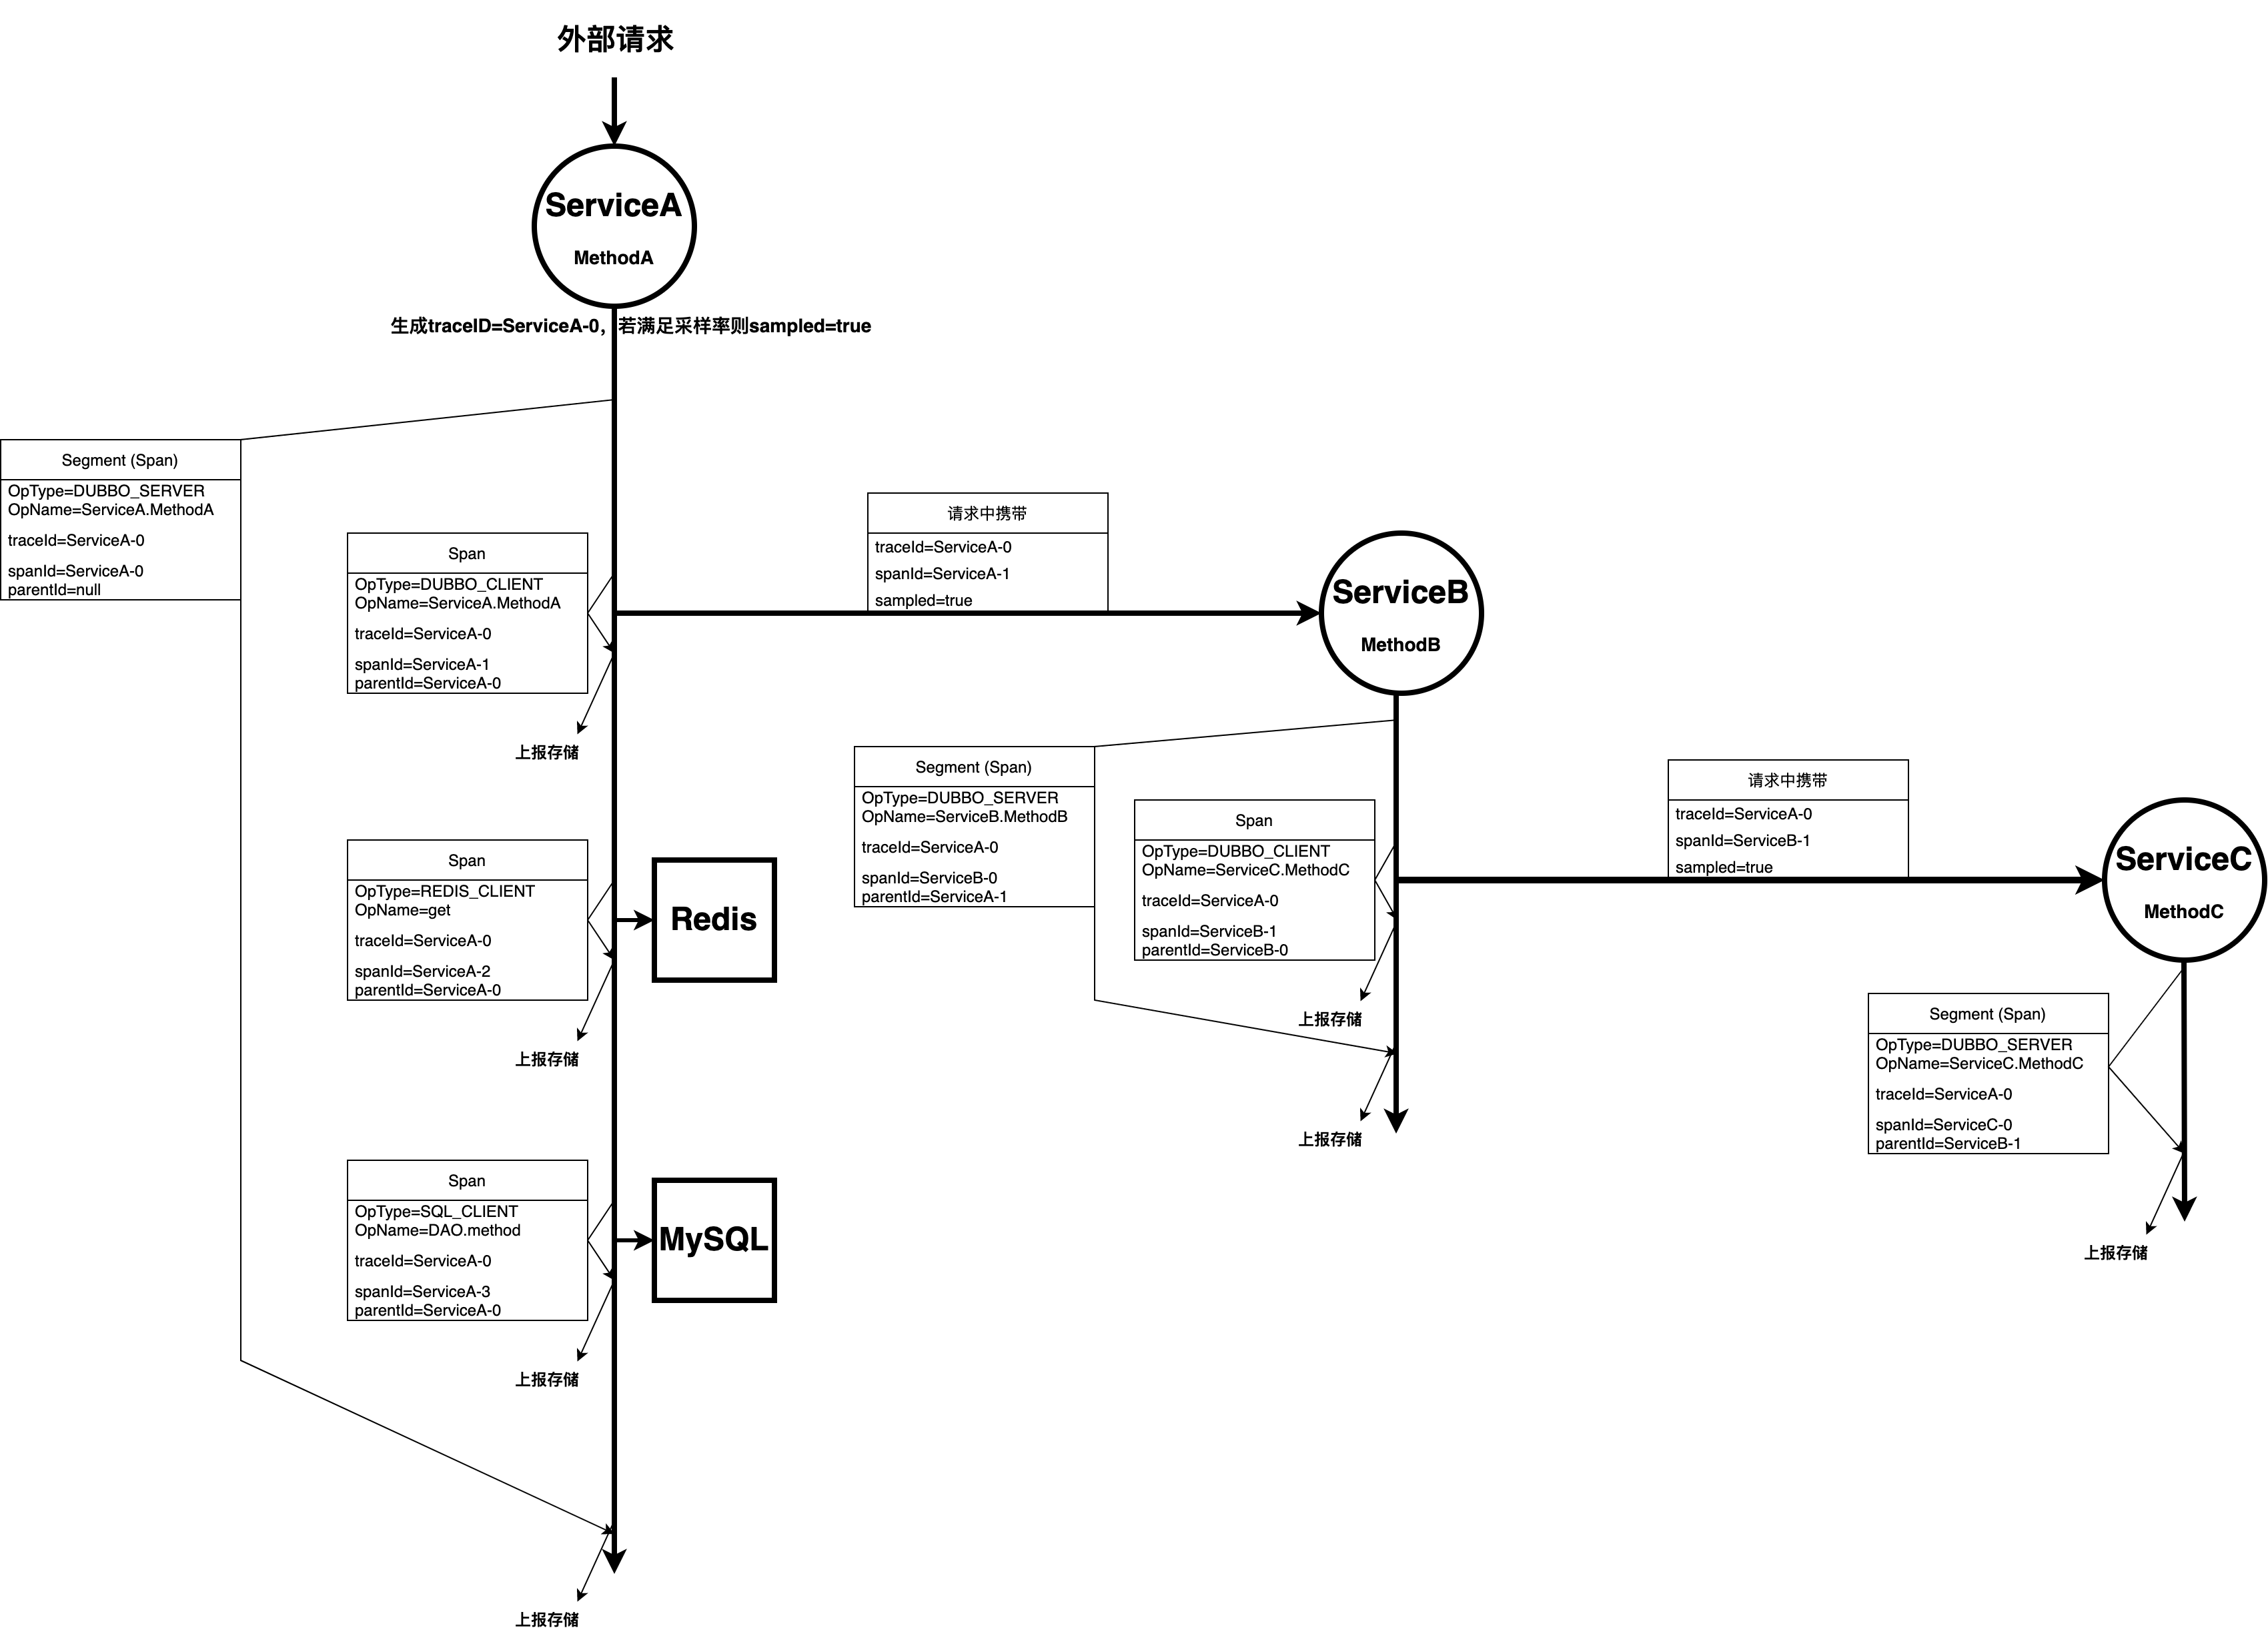
HBase集群部署
<pre<code1.搭建hbase需要依赖与zookeeper进行进程之间的通信,所以需要先部署zookeeper2.解压zookeeper,在/etc/profile.d/hadoopetc.sh中添加环境变量,并将环境变量同步到其他两台服务器中。3.复制一个文件zoo_sample.
全量、增量数据在HBase迁移的多种技巧实践
作者经历了多次基于HBase实现全量与增量数据的迁移测试,总结了在使用HBase进行数据迁移的多种实践,本文针对全量与增量数据迁移的场景不同,提供了12的技巧分享。HBase全量与增量数据迁移的方法1.背景在HBase使用过程中,使用的HBase集群经常会因为某些原因
HBase海量数据高效入仓解决方案
一、方案背景现阶段部分业务数据存储在HBase中,这部分数据体量较大,达到数十亿。大数据需要增量同步这部分业务数据到数据仓库中,进行离线分析,目前主要的同步方式是通过HBase的hive映射表来实现的。该种方式具有以下痛点:需要对HBase表进行全表扫描,对HBase库有一定压
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。