HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
4.Grafana展示监控数据
Grafana是什么?我们知道Node\_export监控服务器状态,但是没有具体的展示,简单来说,Grafana的主要作用就是对监控的数据进行图形化展示。docker部署grafana我们这里采用docker方式部署,Docker安装,可参考Centos7下实现dockerwordpress安装(https://
Understand教程
许多团队希望在常规构建过程中快速生成Understand的HTML报告和指标,或者以其他方式自动创建项目。命令行工具“und”提供了许多用于执行此操作的选项。在本演练中,我将使用最新版本的源代码创建一个Understand项目,并为该版本的代码生成html报告和指标。由于und有几种不同的模式,因此我将说明如何在每种模式下完成此操作。!(http
Flink 源码解析 —— 深度解析 Flink 序列化机制
Flink序列化机制<!morehttps://t.zsxq.com/JaQfeMf(https://www.oschina.net/action/GoToLink?urlhttps%3A%2F%2Ft.zsxq.com%2FJaQfeMf)博客1、Flink从0到1学习——ApacheFlink介绍(
java kubernetes client 获取 集群 metrics信息
K8Sclient获取资源利用率和metrics信息获取与展示POD级甚至Container级的资源利用率是很常见的发布系统需求,然而网上并没有什么资料告诉大家怎么做,本文将告诉大家原理以及java代码实践。命令行获取其实kubectl是可以获取到
【万字干货】OpenMetric与时序数据库存储模型分析
<blockquote<strong摘要:</strong解读OpenMetric规范和指标的模型定义基础上,结合当下主流的时序数据库核心存储及处理技术,尝试让用户(架构师、开发者或使用者)结合自身业务场景选择合适的产品,消除技术选型的困惑。</blockquote本文分享自华为云社区《
分类模型性能指标
准确率、错误率1.测试准确率$$r_{\text{test}}\frac{1}{N^{\prime}}\sum_{i1}^{N^{\prime}}num\left(\tilde{y}_{i}^{\prime}\hat{y}_{i}^{\prime}\right)$$2.测试
Prometheus学习系列(二)之Prometheus first steps
欢迎来到Prometheus!Prometheus是一个监控平台,通过在监控目标上的HTTP端点来收集受监控目标的指标。本指南将向您展示如何使用Prometheus安装,配置和监控我们的第一个资源。您将下载,安装并运行Prometheus。您还将下载并安装exporter,这些工具可在主机和服务上公开时间序列数据。我们的第一个exporter将是Prome
Kubernetes Pod 自动扩容 — HPA
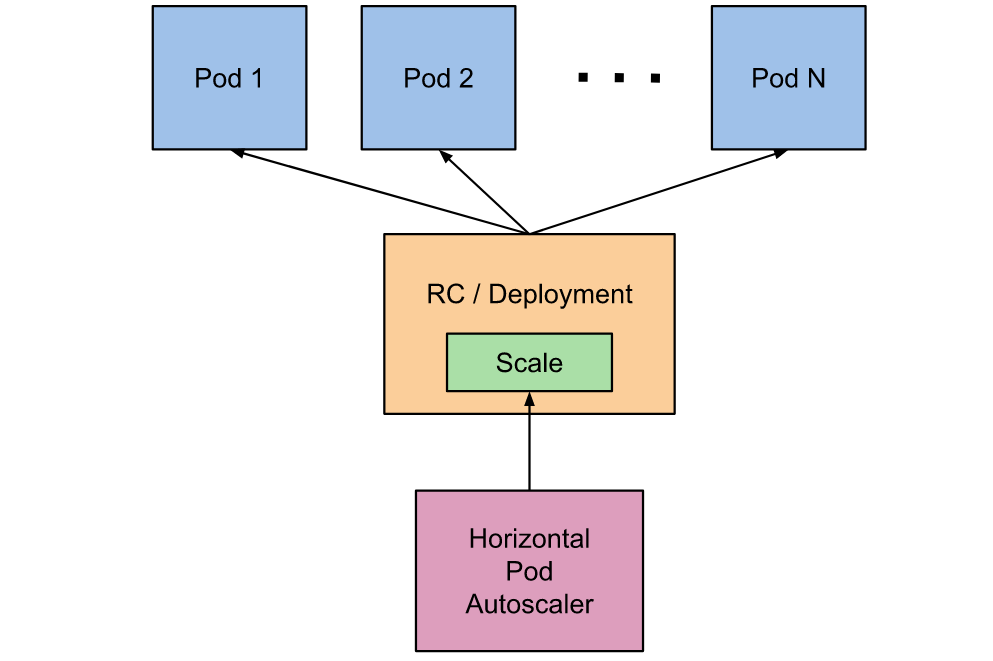
Kubernetes增强了应用服务的横向扩容能力,在应对线上应用服务的资源使用率在高峰和低谷的时候,我们需要能够自动去感知应用的负载变化去调整Pod的副本数量,削峰填谷,提高集群的整体资源利用率和应用的服务质量。为此,Kubernetes1.2版本中引入HorizontalPodAutoscaling(HPA),它与kubectlsc
spring boot metrics使用指南
springbootmetrics是什么?针对应用监控指标暴露,springboot有一套完整的解决方案,并且内置了好很多的指标收集器,如tomcat、jvm、cpu、kafka、DataSource、springmvc(缺少直方图的数据)等。基于micrometer技术,几乎支
Prometheus Metrics 设计的最佳实践和应用实例,看这篇够了!
Prometheus是一个开源的监控解决方案,部署简单易使用,难点在于如何设计符合特定需求的Metrics去全面高效地反映系统实时状态,以助力故障问题的发现与定位。本文即基于最佳实践的Metrics设计方法,结合具体的场景实例——TKE的网络组件IPAMD的内部监控,以个人实践经验谈
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。