HelloWorld 开发者社区
科技资讯

Qwen4-Max 发布:百万 Token 上下文、多模态与长任务如何落地
Jync 2.2.1 发布:完善告警通知,修复 CDC 与 ETL 可靠性问题
phimint 0.10.0 发布:终端智能体加入交互输入处理
Cursor 更新安全事件调查:扩展分发、历史凭据与团队排查
SoduWork 开源,尝试用独立审查与插件治理组织智能体交付
百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
开源项目
全部项目推荐好文
python爬虫采集今日头条实践
Python怎样爬取今日头条数据?针对这个问题,今天我们就详细的介绍了相对应的分析和解答,希望可以帮助更多想解决这个问题的小伙伴找到更简单易行的方法。今日头条近几年做的很强大,自上线以来,围绕内容载体和分发方式两个维度不断丰富,如今包含图文、视频、微头条、专栏、搜索、直播等多种内容形式。根据最新中国联通发布的App排行榜,今日头条稳居新闻资讯行业NO.1。面
如何把多个py文件打包成一个在pycharm直接运行
如果是想同时打包多个py文件在pycharm中,通常做法是将它转化为exe文件。因此,首先,我们需要安装pyinstaller。第一步,安装pyinstaller您可以在下面这个官网中完成安装http://www.pyinstaller.org/(https://link.
240个Python练习案例附源码(百看不如一练)
今天给大家整理了247个经典实用有趣的Python实例,185页代码齐全可复制pdf,几乎涵盖了Python各个方面的知识点,即可以帮助小白快速全面的学习Python,也可以让老手通过实战练习来查缺补漏。实例目录:Python基础(90个案例)Pyt
用Python实现公众号文章原汁原味剪藏
用Python实现公众号文章原汁原味剪藏!图片(https://imghelloworld.osscnbeijing.aliyuncs.com/imgs/36410582ed99de8a316aea05ed8935ac.png)每当我们看到不错的公众号文章是不是都忍不住想
爬虫数据采集
经常有小伙伴需要将互联网上的数据保存的本地,而又不想自己一篇一篇的复制,我们第一个想到的就是爬虫,爬虫可以说是组成了我们精彩的互联网世界。网络搜索引擎和其他一些网站使用网络爬虫或蜘蛛软件来更新他们的网络内容或其他网站的网络内容索引。网络爬虫复制页面以供搜索引擎处理,搜索引擎对下载的页面进行索引,以便用户可以更有效地搜索。这都是爬虫数据采集的功劳。这篇文章我总
Python 懂车帝口碑分爬虫
Python懂车帝口碑分爬虫需求懂车帝全系车型懂车分(口碑)页面中的详细车系评分数据!请添加图片描述(https://imghelloworld.osscnbeijing.aliyuncs.com/imgs/5138eb658d5e7489fcfad0e
2022春节贺岁档电影开分,水门桥不理想,四海崩了!用Python一探究竟
尽管受到疫情影响,部分地区被迫关闭了电影院,但从大年初一中国影史第二单日总票房的数据来看,2022年春节期间大家的观影热情还是十分高涨的。大年初一上映当天,从票房数据来看,《长津湖之水门桥》一马当先,《四海》《这个杀手不太冷静》《奇迹·笨小孩》你追我赶,动画片《熊出没》表现强势,《狙击手》令人
西瓜视频url地址解码
https://blog.csdn.net/leacas/...(https://link.segmentfault.com/?encPm1HAfvcn4OeuI6nQIMjGA%3D%3D.BTfhgdMmgij%2FeGT1VL2DIyPqjObWmRPPiawjAFrT619E7M%2B
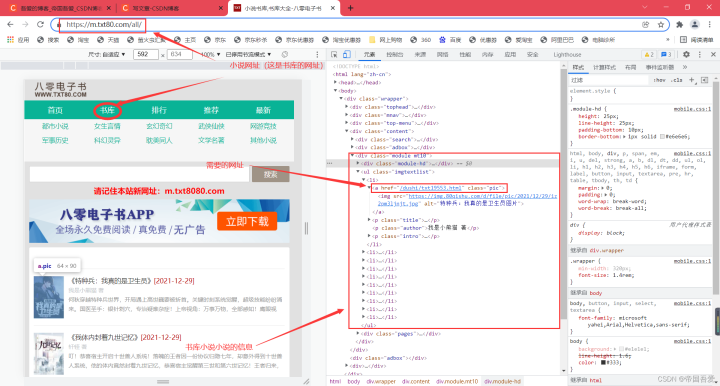
Python爬虫-爬取小说-下载小说
一、创建文件夹(1)、创建指定文件夹判断文件夹是否存在,不存在则创建defJudgefolder():folder"novel"ifnotos.path.exists(folder):print("文件不存在,已创建!")os.mkdir(folder)else:prin
Python爬虫-爬取图片并且存储到MySQL数据库中
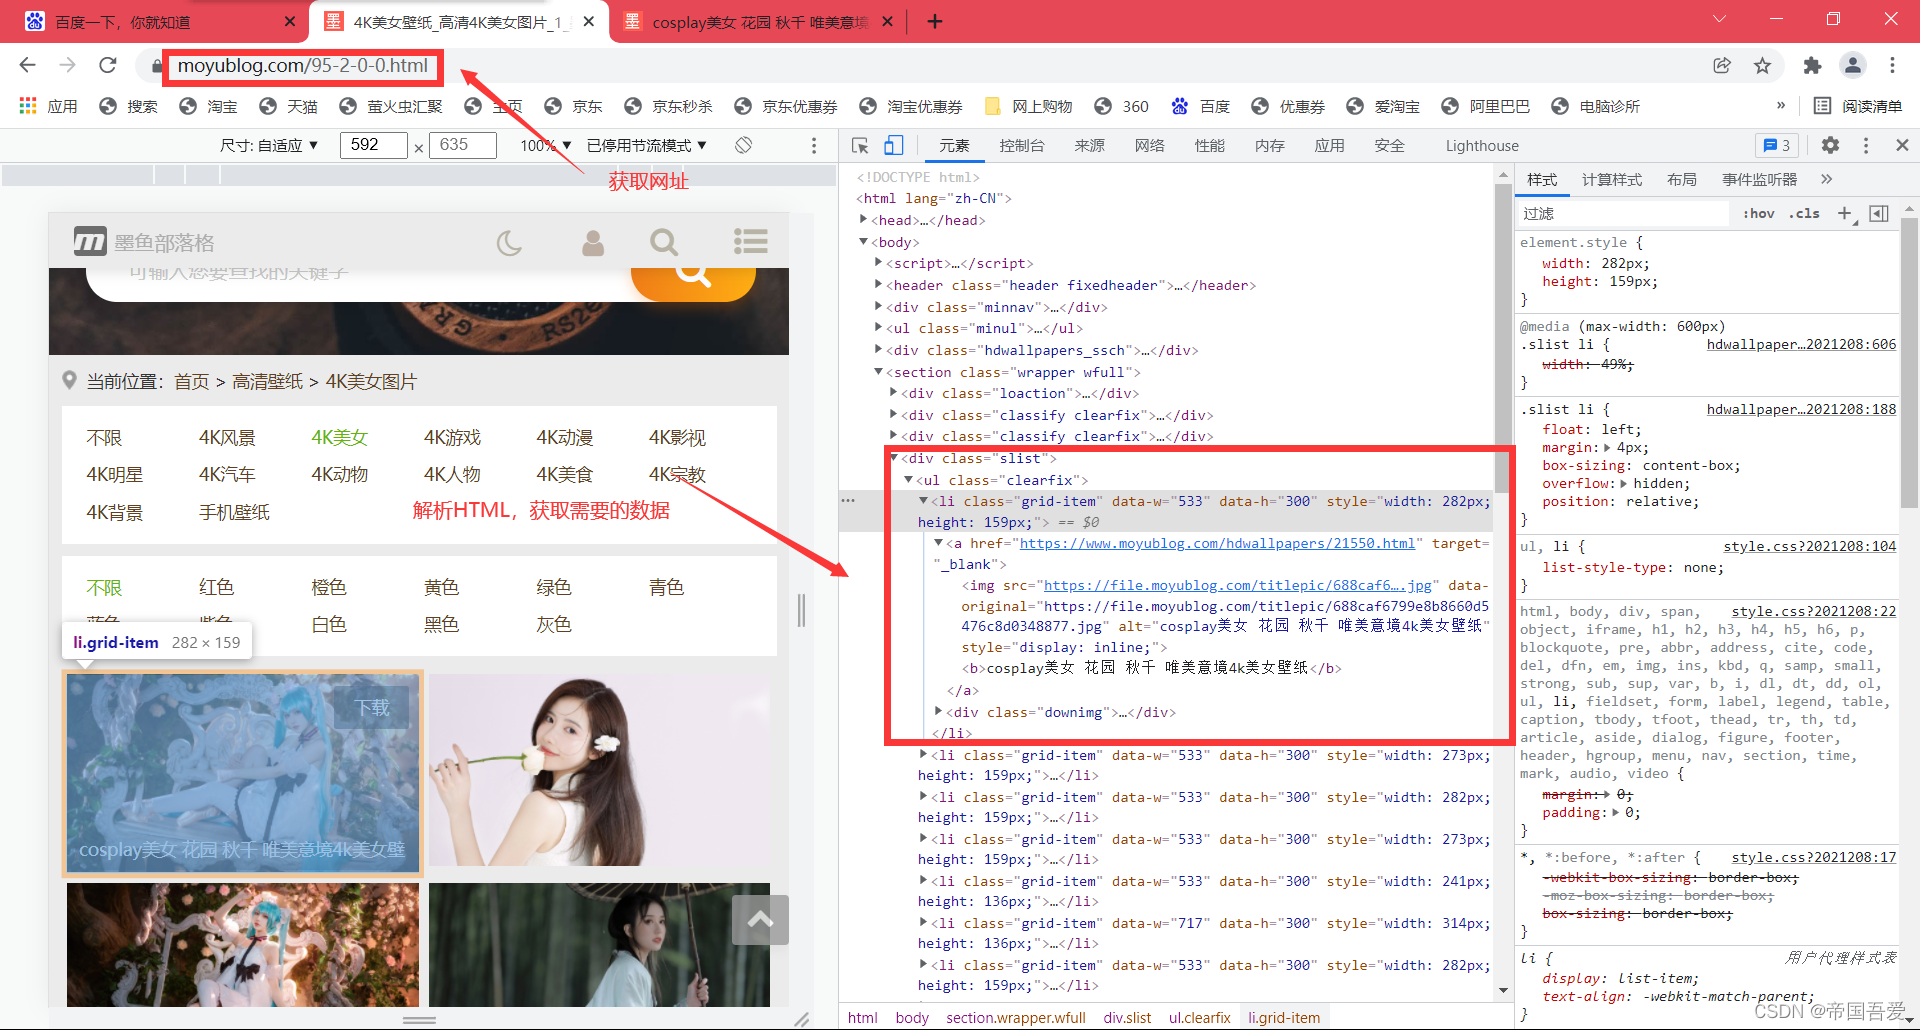
一、获取网址,解析网址(1)、for循环获取不同页的数据(2)、获取a标签中的网址(原因:外面图片分辨率太小,进入图片对应的网址寻找分辨率大点的图片)url网址https://www.moyublog.com/95200.htmlforiinrange(1):strvaluestr(i)页数url"htt
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。