HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
【JS 逆向百例】无限debugger绕过,某政民互动数据逆向
声明本文章中所有内容仅供学习交流,抓包内容、敏感网址、数据接口均已做脱敏处理,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关,若有侵权,请联系我立即删除!逆向目标目标:某政务服务网—>政民互动—>我要咨询主页:aH
【JS 逆向百例】复杂的登录过程,最新微博逆向
<blockquote关注微信公众号:K哥爬虫,QQ交流群:808574309,持续分享爬虫进阶、JS/安卓逆向等技术干货!</blockquote声明本文章中所有内容仅供学习交流,抓包内容、敏感网址、数据接口均已做脱敏处理,严禁用于商业用途和非法用途,否则由此产生的一切后
爬虫
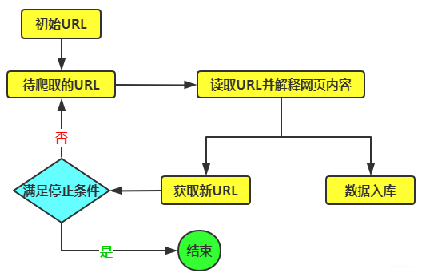
爬虫什么是爬虫使用编程语言所编写的一个用于爬取web或app数据的应用程序怎么爬取数据1.找到要爬取的目标网站、发起请求2.分析URL是如何变化的和提取有用的URL3.提取有用的数据爬虫数据能随便爬取吗?遵守robots.txt协议爬虫的分类通用网络爬虫百度,Google等搜索引擎,从一些初识的URL扩展到整个网站,主要为门户站点搜索引擎和大型网站服务采
【JS 逆向百例】层层嵌套!某加速商城 RSA 加密
声明本文章中所有内容仅供学习交流,敏感网址、数据接口均已做脱敏处理,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关,若有侵权,请联系我立即删除!逆向目标目标:某加速商城登录接口主页:aHR0cDovL3d3dy4xNXl1bm1hbG
【JS 逆向百例】当乐网登录接口参数逆向
声明本文章中所有内容仅供学习交流,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关,若有侵权,请联系我立即删除!逆向目标目标:当乐网登录主页:https://oauth.d.cn/auth/goLog...(https://link.seg
【JS 逆向百例】建筑市场监管平台企业数据
声明本文章中所有内容仅供学习交流,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关。逆向目标目标:住房和城乡建设部&全国建筑市场监管公共服务平台的企业数据主页:http://jzsc.mohurd.gov.cn/dat...(htt
一篇文章教会你利用Python网络爬虫获取电影天堂视频下载链接
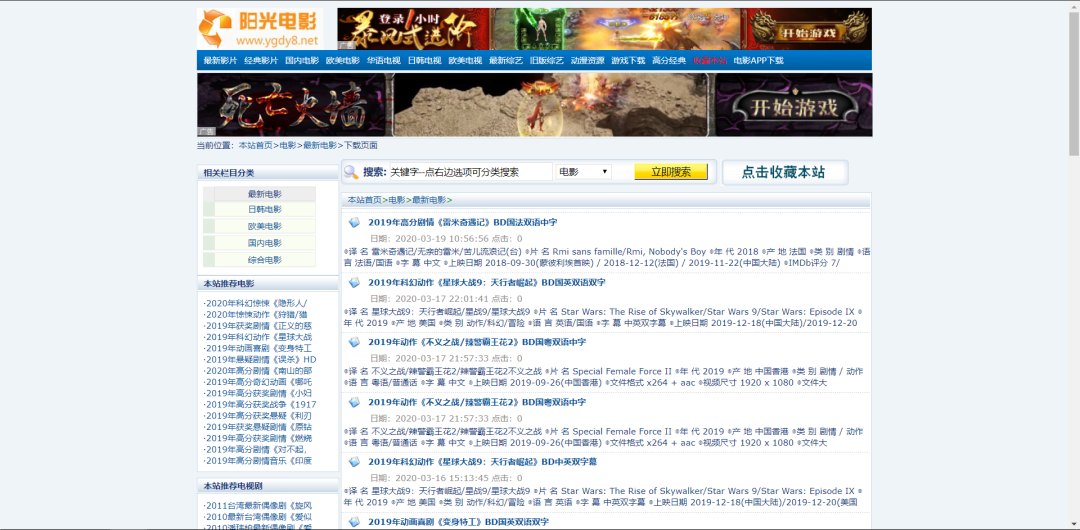
【一、项目背景】相信大家都有一种头疼的体验,要下载电影特别费劲,对吧?要一部一部的下载,而且不能直观的知道最近电影更新的状态。今天小编以电影天堂为例,带大家更直观的去看自己喜欢的电影,并且下载下来。【二、项目准备】首先我们第一步我们要安装一个Pycharm的软件。Pycharm软件安装可以看这篇教程:。电影天堂网的网址:https://ww
一篇文章教会你利用Python网络爬虫抓取百度贴吧评论区图片和视频
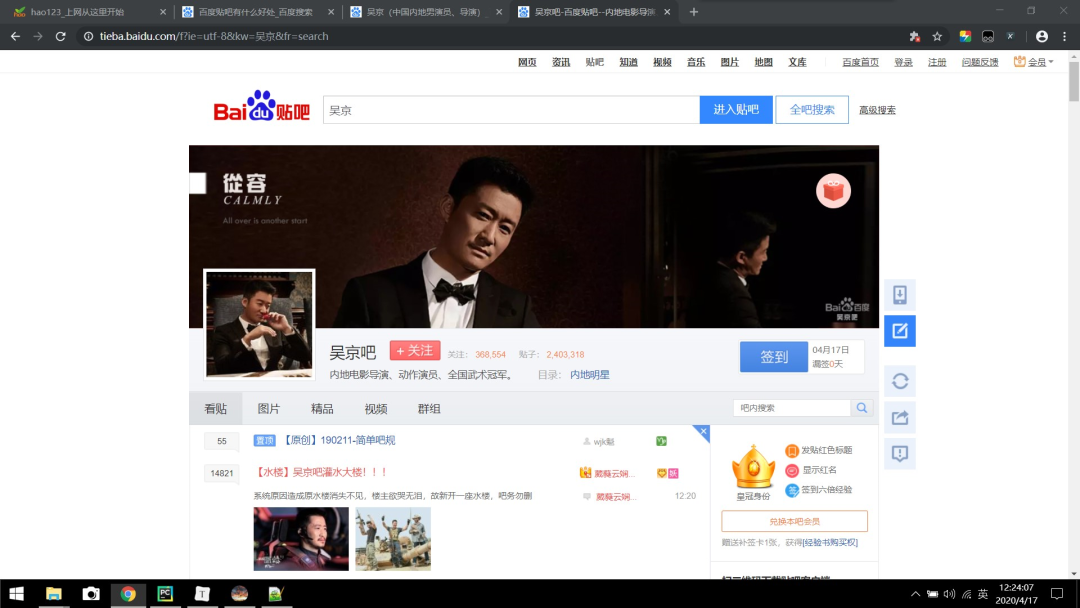
【一、项目背景】 百度贴吧是全球最大的中文交流平台,你是否跟我一样,有时候看到评论区的图片想下载呢?或者看到一段视频想进行下载呢?今天,小编带大家通过搜索关键字来获取评论区的图片和视频。【二、项目目标】 实现把贴吧获取的图片或视频保存在一个文件。【三、涉及的库和网站】1、网址如下:https://tieba.baidu.com/f?ie
手把手教你用Python网络爬虫爬取新房数据
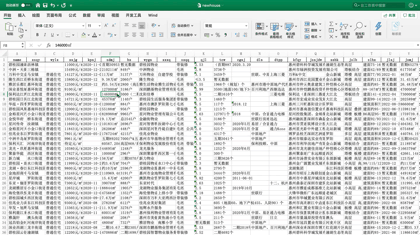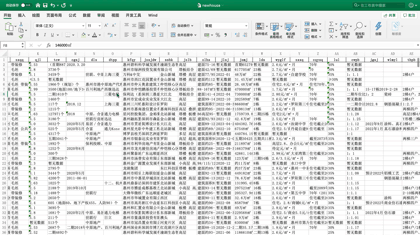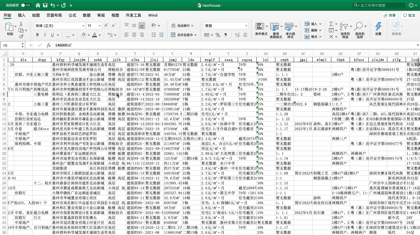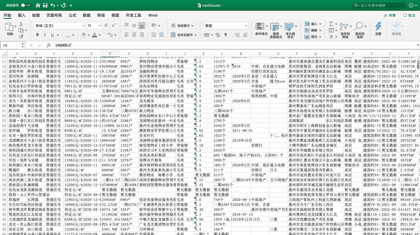
项目背景大家好,我是J哥。新房数据,对于房地产置业者来说是买房的重要参考依据,对于房地产开发商来说,也是分析竞争对手项目的绝佳途径,对于房地产代理来说,是踩盘前的重要准备。今天J哥以「惠民之家」为例,手把手教你利用Python将惠州市新房数据批量抓取下来,共采集到近千个楼盘,包含楼盘名称、销售价格、主力户型、开盘时间、容积率、绿化率等「41个字段」。数
使用Scrapy网络爬虫框架小试牛刀
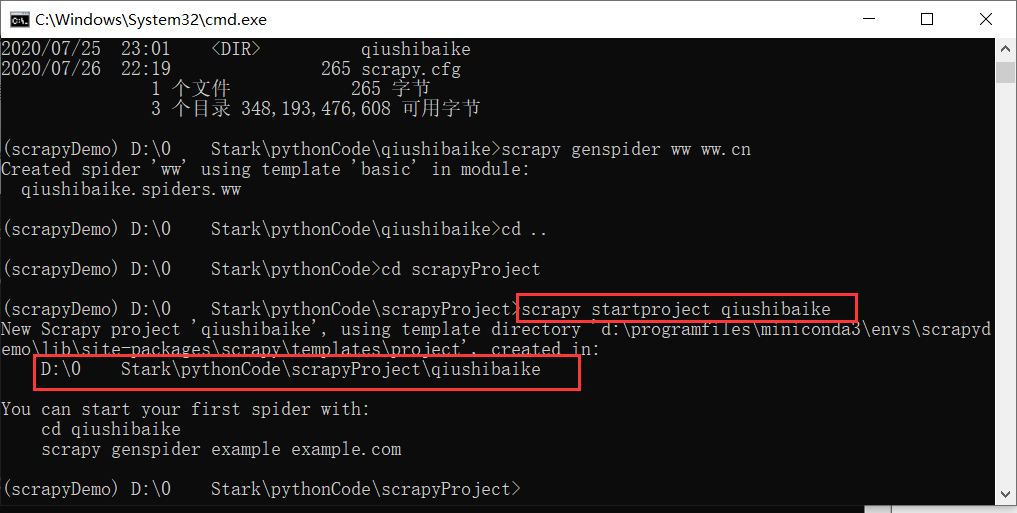
前言这次咱们来玩一个在Python中很牛叉的爬虫框架——Scrapy。scrapy介绍标准介绍Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍。所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等)的具有很强通用性的项目模板。对于框架的学习,重点是要学习其框架的特性、各个功能的
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。