HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
详解4种类型的爬虫技术
导读:网络爬虫是一种很好的自动采集数据的通用手段。本文将会对爬虫的类型进行介绍。作者:赵国生王健来源:大数据DT(ID:hzdashuju)聚焦网络爬虫是“面向特定主题需求”的一种爬虫程序,而通用网络爬虫则是捜索引擎抓取系统(Baidu、Google、Yahoo等)的重要组成部分,主要目的是将互联网上的网页下载到本地,形成一个互联网内
手把手教你用Python网络爬虫实现起点小说下载
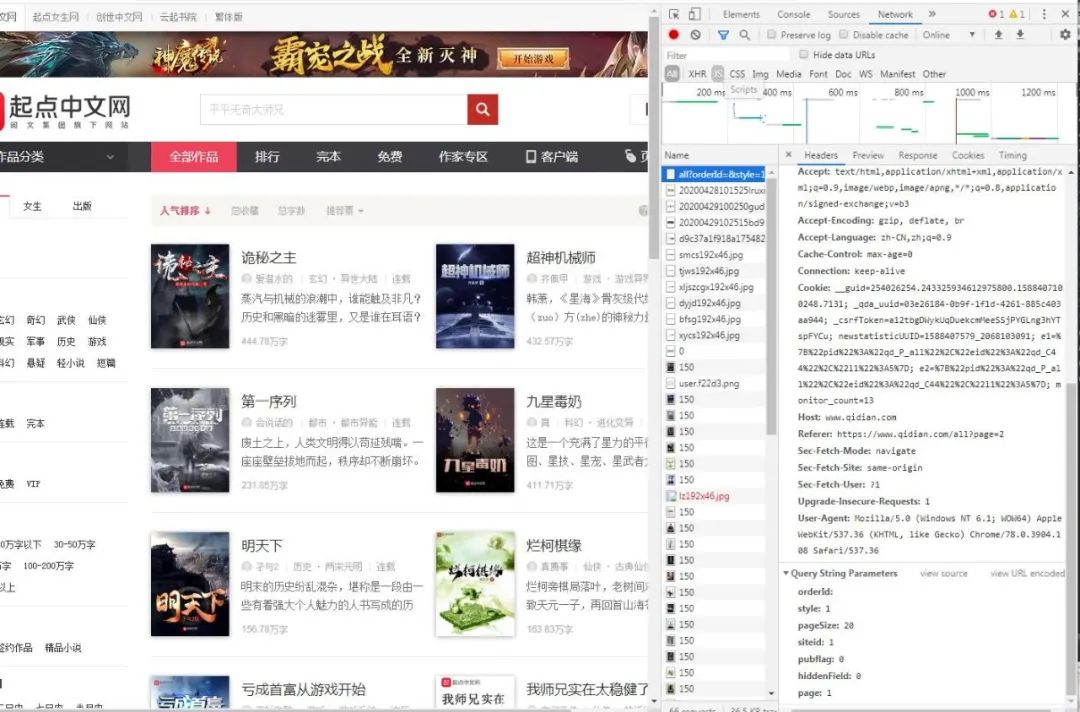
今天要跟大家分享一个小说爬取案例起点小说的小说下载。在做这个案例之前,我们需要对其进行分析,1.界面分析,如图:通过分析很容易就找到了我们的get请求参数,然后获取相应页面的小说名和链接:获取到数据之后,我们就随机挑选一篇小说来进行下载,我们选第一篇,然后打开它的文章目录,可以看到是这样的,如图:基本上这篇小说很长,可以看到它卷一和卷二是免费的,后面的收费,
手把手教你用Python网络爬虫获取头条所有好友信息
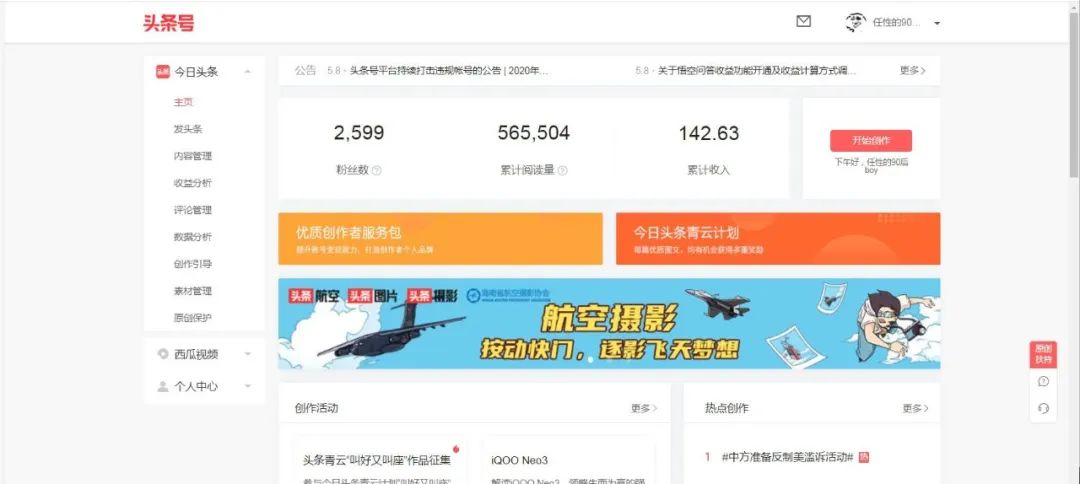
前言大家好,我是黄伟。今日头条我发觉做的挺不错,啥都不好爬,出于好奇心的驱使,小编想获取到自己所有的头条好友,看似简单,那么情况确实是这样吗,下面我们来看下吧。项目目标获取所有头条好友昵称项目实践编辑器:sublimetext3浏览器:360浏览器,顺带一个头条号实验步骤1.登陆自己的头条号:可以看到2599,不知道谁会是下一个幸运观众了,
超全Python网络爬虫教程合集!
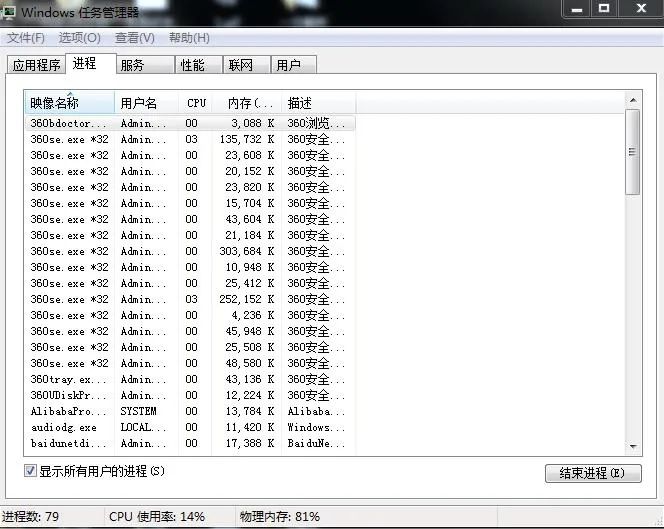
前言进程,一个新鲜的字眼,可能有些人并不了解,它是系统某个运行程序的载体,这个程序可以有单个或者多个进程,一般来说,进程是通过系统CPU内核数来分配并设置的,我们可以来看下系统中的进程:可以看到,360浏览器是真的皮,这么多进程啊,当然可以这样来十分清楚的看进程线程使用情况:通过任务管理器中的资源监视器,是不是很厉害了,哈哈哈。讲完了这些,再说说用法。
《Python3网络爬虫开发实战》
提取码:1028内容简介······本书介绍了如何利用Python3开发网络爬虫,书中首先介绍了环境配置和基础知识,然后讨论了urllib、requests、正则表达式、BeautifulSoup、XPath、pyquery、数据存储、Ajax数据爬取等内容,接着通过多个案例介绍了不同场景下如何实现数据爬取,后介绍了pyspider框架、S
Python网络爬虫与信息提取
title:Python网络爬虫与信息提取date:2020121001:00:23tags:Pythoncategories:学习笔记写在前面不知道写啥其实说实话TOC网络爬虫之规则安装requests库cmd命令行打开输入pip3installrequests,等待即可简单测试,爬一下bkjwpythonimportrequ
《自己动手写网络爬虫》.pdf
关注“_<em<em</emJava后端技术全栈</em_”回复“面试”获取全套面试资料什么是爬虫?爬虫的全名叫网络爬虫。他还有其他的名字,比如网络机器人,网络蜘蛛等等。爬虫有简单的爬虫和复杂的爬虫。简单的爬虫是一种脚本,脚本是粗糙但却非常
使⽤正则表达式的python爬⾍,爬取内涵段⼦⽹站
现在拥有了正则表达式这把神兵利器,我们就可以进⾏对爬取到的全部⽹⻚源代码进⾏筛选了。下⾯我们⼀起尝试⼀下爬取内涵段⼦⽹站:http://www.neihan8.com/articl...(https://link.segmentfault.com/?enckr0a%2Fy4ta%2B5Whcf
python网络爬虫案例:批量爬取百度贴吧页面数据
⾸先我们创建⼀个python⽂件,tiebaSpider.py,我们要完成的是,输⼊⼀个百度贴吧的地址,⽐如:百度贴吧LOL吧第⼀⻚:http://tieba.baidu.com/f?kwl...(https://link.segmentfault.com/?encjnGpbb%
高价值干货:这可能是你见过最全的网络爬虫总结
<blockquote<strong摘要:</strong从抓取、解析、存储、反爬、加速五个方面介绍了利用Python进行网络爬虫开发的相关知识点和技巧,介绍了不同场景下如何采取不同措施高效地进行数据抓取的方法。</blockquote前段时间参加了一场Python网络爬虫主题
正在加载更多文章…
加载更多已加载文章中没有匹配内容,可继续加载更多。