Dubbo序列化插件smartbuf与kryo、fst、hessian2、fastjson等性能对比
文章目录
介绍
本文同步发布于GitHub、个人主页等
smartbuf-dubbo是一个基于smartbuf的dubbo序列化插件。
它内部封装了smartbuf序列化框架的stream模式,通过自定义的SmartbufSerialization向dubbo暴露了一个名为smartbuf的序列化器。
关于smartbuf
smartbuf是一种新颖、高效、智能、易用的跨语言序列化框架,它既拥有不亚于protobuf的高性能,也拥有与json相仿的通用性、可扩展性、可调试性等。
它内部采用分区序列化将松散的对象序列化为若干个紧凑的分区,从而大幅提高编码效率,具体细节请参考smartbuf项目。
使用方式
smartbuf-dubbo内部实现非常简单,它只是简单地按照dubbo官方文档提供了序列化插件,包括三个class:
SmartbufObjectInputSmartbufObjectOutputSmartbufSerialization
以及位于core/src/main/resources/META-INF.dubbo/的插件配置。
此插件已打包deploy至中心仓库,所以你可以直接通过以下maven坐标引入它:
<dependency>
    <groupId>com.github.smartbuf</groupId>
    <artifactId>smartbuf-dubbo</artifactId>
    <version>1.0.1</version>
</dependency>当然也可以直接将以上提到的class和resources配置复制入自己的工程中,同时记得手动添加smartbuf依赖。
之后就可以按照官方文档的配置,在protocol中选择启用序列化插件,具体效果可能类似于:
<dubbo:protocol serialization="smartbuf" />此插件支持com.alibaba版本与org.apache版本的dubbo。
对比其他序列化方案
根目录中的demo-alibaba和demo-apache分别针对2.6.*版本和2.7.*版本的dubbo进行序列化测试,测试对象包括smartbuf、fastjson、hessian2、kryo、fst。
对比测试包括三部分:tiny、user、posts,分别对比测试各个序列化框架在简单、普通、复杂业务中的综合表现。
提示:对比测试侧重于单线程的序列化性能、数据压缩率,最终数据仅用于横向对比各个序列化框架,并不能体现dubbo本身的多并发性能。
大数据集posts测试
此测试中dubbo接口返回的数据为100个固定的PostModel实例,其具体模型如下:
public class PostModel implements Serializable {
    private int         postId;
    private int         authorId;
    private Integer     prePostId;
    private String      title;
    private String      description;
    private ContentType contentType;
    private Visibility  visibility;
    private long        createTime;

    private List<Integer>    mentions = new ArrayList<>();
    private List<TopicModel> topics   = new ArrayList<>();
}测试中随机创建100个PostModel对象、10个TopicModel对象,然后随机为每个PostModel分配若干个TopicModel,最终模拟类似实际产品应用中的queryPost结果集。
这个数据集采用json编码时,大概20KB,各个序列化框架调用10w次的综合表现为:
-
fastjson: 耗时约192s, 网络输入输出总计约17.88GB -
fst: 耗时约52s, 网络输入输出总计约4.01GB -
hessian2: 耗时约115s, 网络输入输出总计约11.08GB -
kryo: 耗时约135s, 网络输入输出总计约4.05GB -
smartbuf: 耗时约75s, 网络输入输出总计约2.15GB
具体表现如下图所示,横轴表示时间,纵轴表示网络流量:

说明:模型中存在枚举值ContentType与Visibility,而测试中使用的kryo并不支持枚举,因此在测试kryo时直接忽略了枚举,最终导致它的测试数据并不完整。
普通数据集user测试
此测试中dubbo接口返回的数据为1个固定的UserModel实例,其具体模型如下:
public class UserModel implements Serializable {
    private int    id;
    private String token;
    private String nickname;
    private String loginIp;
    private long   loginTime;
    private long   createTime;
    private long   updateTime;

    private List<UserModel> friends = new ArrayList<>();
}为了照顾kryo,此测试中不再使用enum类型。
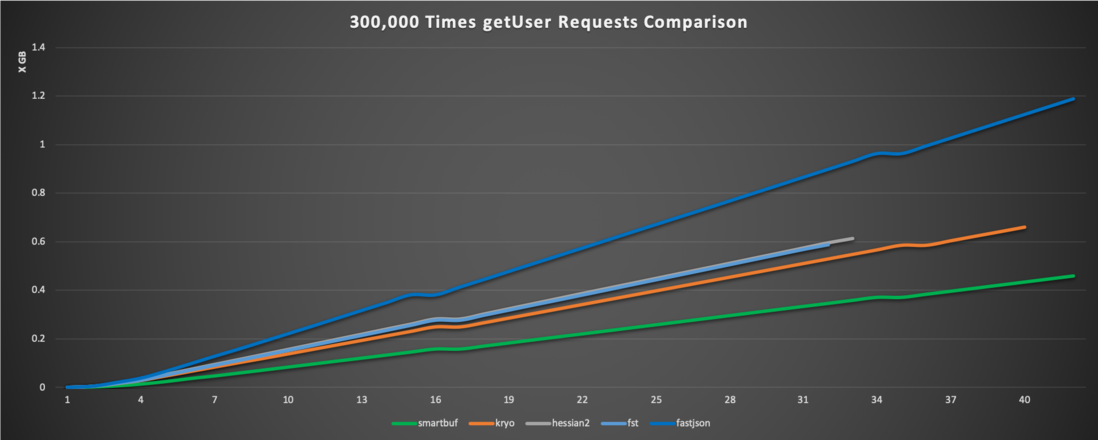
测试中为friends随机创建20个UserModel对象,顺便测试一下各个序列化框架对循环引用的处理。这个数据集采用json编码时,大概4KB,各个序列化框架调用30w次的综合表现为:
-
fastjson: 耗时约41s, 网络输入输出总计约1.11GB -
fst: 耗时约31s, 网络输入输出总计约0.55GB -
hessian2: 耗时约32s, 网络输入输出总计约0.57GB -
kryo: 耗时约39s, 网络输入输出总计约0.62GB -
smartbuf: 耗时约41s, 网络输入输出总计约0.43GB
具体表现如下图所示,横轴表示时间,纵轴表示网络流量:
小数据集tiny测试
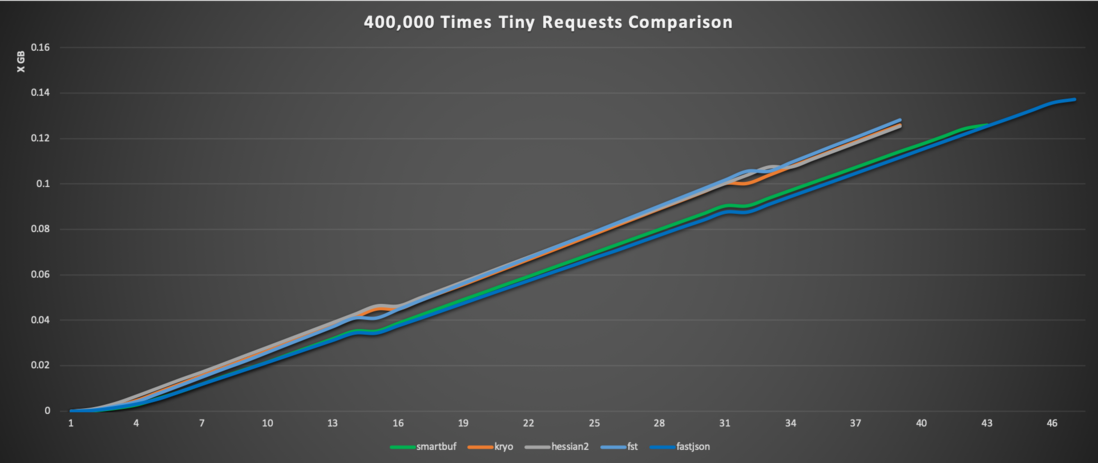
此测试中dubbo接口返回的数据为一个普通的uuid字符串,没有太大的意义。各个序列化框架调用40w次的综合表现为:
-
fastjson: 耗时约46s, 网络输入输出总计约130MB -
fst: 耗时约38s, 网络输入输出总计约122MB -
hessian2: 耗时约38s, 网络输入输出总计约120MB -
kryo: 耗时约38s, 网络输入输出总计约120MB -
smartbuf: 耗时约42s, 网络输入输出总计约120MB
具体表现如下图所示,横轴表示时间,纵轴表示网络流量:
测试说明
以上测试全部为本地网络,使用的dubbo版本号为2.6.7。
你可以直接checkout源代码在本地执行测试代码。测试中用于采集网络IO数据的NetMonitor类内部使用了nettop指令,据我了解它应该只支持osx操作系统,如果你在其他系统中执行测试,可能无法获得正确的bytes_in及bytes_out。
总结
由于smartbuf在架构设计上采用了数据可复用的分区序列化,因此面对大数据集、数组、列表等结构时,可以通过属性复用的技术优势,显著地提高其编码效率。相比于kryo、fst、hession2等时,甚至可以提高一倍的空间利用率,相比于json更是提高一个数量级。
由于smartbuf底层设计上以类似于json的方式解析数据,因此它的兼容性与json相仿,天然地解决了不同对象模型之间的字段兼容。且支持大多数常用的数据类型,也包括枚举、泛型等等。相比之下其他序列化框架仅支持java语言,且存在或多或少的兼容性问题,以及支持数据类型过少的问题。比如测试中发现kryo不支持enum和AbstractList$SubList。
在序列化性能上smartbuf相比于fst存在一些劣势,可能是分区序列化中内存复制所致,也可能是代码中某些地方存在性能问题。不过这种劣势往往只是纳秒级的,相比于数据报文在服务器、机房、区域的网络传输而言,都是微不足道的。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论