JDK源码分析——AbstractQueuedSynchronizer(上)
文章目录
一. Java并发编程的基石
AQS是Java并发编程的基础,Java类库提供的并发工具如Semaphore, CountDownLatch, CyclicBarrier, ReentrantLock, ReadWriteLock等等都是建立在AQS上的,按照Doug Lea的说法,AQS是一个并发基础框架,用户通过继承AQS并覆写tryAcquire()和tryRelease()来表达他所希望的信号量控制方式,其余的细节则完全由这个并发框架完成。
理论总是拗口的,所以还是直接来看细节好啦。
二. State的含义
AQS中核心的字段自然是private volatile int state,在用户层面表达控制state的方式就是覆写tryAcquire和tryRelease方法。
最自然的想法是将state看做剩余信号量,那么只有在剩余信号量为正的情况下tryAcquire才能成功,大多数并发工具都是这么操作的,比如Semaphore,也有为了实现特殊的功能而在剩余量为0的时候tryAcquire才能成功,比如CountDownLatch。
也就是说state的含义由具体所要实现的功能紧紧关联在一起,用户需要覆写tryAcquire和tryRelease来表达他所希望进行的state控制。
三. 构造一个不可重入锁
我想来想去,AQS的讲解着实不适合自底向上,所以还是用从顶向下的方式讲解好了。
Java类库中的Semaphore对于state的解释很纯粹,就是将它当做剩余信号量,tryAcquire表示获取信号量,tryRelease表示释放信号量,这也符合大家学操作系统课程时所接收的信号量PV概念。然而尴尬的是,它使用的是AQS的Share模式,这对于初学者的理解实在是不太友好。
而使用Exclusive模式的ReentrantLock中处理可重入的代码又太多,掩盖了最核心的代码。所以我决定还是自己构造一个简单的不可重入锁好了,这样的锁自然是不适用于实际业务的,不过很适合讲解:-)
自定义锁命名为GLock,为了代码简洁也不实现Lock接口了,不然又要覆写一大堆没用的方法,咱们怎么简洁怎么来。
Java类库的并发工具使用AQS都是通过在内部持有一个继承AQS的子类来完成的,这个子类的命名约定俗成都是Sync,咱们也入乡随俗
public class GLock {
    private final Sync sync;
    public GLock() {
        // 设置总信号量为1
        sync = new Sync(1);
    }

    /**
     * 获取锁
     */
    public void lock() {
        // 获取一个信号量
        sync.acquire(1);
    }

    /**
     * 释放锁
     */
    public void unlock() {
        // 释放一个信号量
        sync.release(1);
    }

    static class Sync extends AbstractQueuedSynchronizer {
        Sync(int permits) {
            setState(permits);
        }

        @Override
        protected boolean tryAcquire(int acquires) {
            int c = getState();
            if (c == 0)
                return false;

            return compareAndSetState(c, c - acquires);
        }

        @Override
        protected boolean tryRelease(int releases) {
            setState(getState() + releases);
            return true;
        }
    }
}GLock的总信号量在初始化时设置为1,并且使用Exclusive独占模式操作AQSGLock完美地展示了信号量PV的概念——将AQS的state字段作为剩余信号量来看待,tryAcquire-获取信号量,tryRelease-释放信号量。
四. 进入Acquire
假设业务逻辑调用了GLock.lock()方法,那么大家都知道要么是成功了,可以执行后续的业务逻辑,要么就是被阻塞住了,直到等待一段时间别的线程释放了锁,至于等待多久就天晓得了。
咋看之下,GLock.lock()方法中调用的是sync.acquire(1),咱们写的tryAcquire方法用在哪了?我们来看一下AQS的acquire源码
public final void acquire(int acquires) {
    if (!tryAcquire(acquires) &&
        acquireQueued(addWaiter(Node.EXCLUSIVE), acquires))
    {
            selfInterrupt();
    }
}是在acquire里回调了tryAcquire方法。acquire方法中,存在以下情况
tryAcquire成功了,那么不需要执行acquireQueued和selfInterupt(),直接返回,表示成功获取了信号量,对于GLock也即意味着第一次获取锁就成功了- 如果
tryAcquire失败了,这种情况需要进入AQS中的等待队列,我们需要先在队列中占个位置,这也是addWaiter方法要做的事情
五. AQS的等待队列
FIFO队列是AQS的核心,其实这是一个双向链表,链表中的结点由Node类型表示
static final class Node {
    volatile int waitStatus;
    volatile Node prev;
    volatile Node next;
    volatile Thread thread;
}在AQS中包含volatile Node head和volatile Node tail两个字段分别指向表头和表尾
前面说到第一次tryAcquire没有成功时,需要进入等待队列,addWaiter方法的作用就是在表尾插入结点,参数mode有两种取值——Shared共享模式和Exclusive独占模式,这里使用的是独占模式
private Node addWaiter(Node mode) {
    Node node = new Node(Thread.currentThread(), mode);
    enq(node);
    return node;
}
private Node enq(final Node node) {
    for (;;) {
        Node t = tail;
        if (t == null) { // Must initialize
            if (compareAndSetHead(new Node()))
                tail = head;
        } else {
            node.prev = t;
            if (compareAndSetTail(t, node)) {
                t.next = node;
                return t;
            }
        }
    }
}可以看到,当队列为空时,必须先在队列头部插入一个空白结点,也就是说,只要队列被第一次使用,后续所有时间,队列的头部一定不为空
我们假设此时GLock的信号量已经被线程X给占用了,而现在有三个线程T1, T2, T3都尝试获取信号量,并且三个线程都刚刚结束调用enq()方法,那么此时AQS的等待队列看起来像是这样
请问在队列中插入结点后线程是立刻休眠呢还是有别的操作?我们继续看acquireQueued方法。
我们来看下acquireQueued源码,简洁起见我删除了部分不影响讲解的代码
final boolean acquireQueued(final Node node, int acquires) {
    boolean interrupted = false;
    for (; ; ) {
        final Node p = node.predecessor();
        if (p == head && tryAcquire(acquires)) {
            setHead(node);
            p.next = null; // help GC
            failed = false;
            return interrupted;
        }
        if (shouldParkAfterFailedAcquire(p, node) &&
            parkAndCheckInterrupt())
        {
            interrupted = true;
        }
    }
}我们发现acquireQueued()整体是一个无限循环,不停地去尝试获取信号量,直到获取成功才return
但是获取信号量并不是在队列中的任何线程都可以进行的,我们要特别注意这句代码if (p == head && tryAcquire()),只有在当前线程所处结点是整个队列第二个结点时(第一个是头结点,它是个哑结点)才能够尝试获取信号量,这说明,任意时刻,队列中只有第一个线程有资格获取信号量
在我们的例子中就是T1才有资格获取信号量,假设当前占用信号量的线程X的业务逻辑比较复杂,执行时间较长,那么线程T1在执行第二次tryAcquire()时依然没有获取到信号量(第一次是在acquire()中),就会进入到shouldParkAfterFailedAcquire()方法
private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) {
    int ws = pred.waitStatus;
    if (ws == Node.SIGNAL)
        return true;
    if (ws > 0) {
        do {
            node.prev = pred = pred.prev;
        } while (pred.waitStatus > 0);

        pred.next = node;
    } else {
        compareAndSetWaitStatus(pred, ws, Node.SIGNAL);
    }
    return false;
}这个pred前置结点就是头结点,根据结点中waitStatus值的不同,这个方法有不同的逻辑,下面我们来看看waitStatus不同值的含义
六. 队列结点中的waitStatus
waitStatus有如下取值
| 命名 | 取值 | 含义 |
|---|---|---|
| CANCELLED | 1 | 结点中的线程已经取消等待 |
| SIGNAL | -1 | 后继结点要求持有信号量的线程释放信号量时唤醒它 |
| CONDITION | -2 | 这个值只在Condition中用到,我们暂时不关心 |
| PROPAGATE | -3 | 共享模式下,释放信号量的线程要求让等待队列中的线程尽可能地在进入休眠前获得信号量 |
CONDITION状态我们不用管,在信号量PV操作中不会用到这个状态,所以我们要研究的就是默认初始化状态0, CANCELLED, SIGNAL和PROPAGATE,进一步地,当前从易于读者理解的角度考虑,使用的是AQS独占模式,PROPAGATE暂时也不需要考虑
我们当前在GLock中需要考虑的有0, CANCELLED和SIGNAL三种结点状态。
还有很重要的一点是,头结点的waitStatus永远不会是CANCELLED!,所以我们最终需要考察的只有0和SIGNAL两种状态.
桥豆麻袋!你说头结点不会是CANCELLED,那么为什么会有这样的代码?
if (ws > 0) {
    do {
        node.prev = pred = pred.prev;
    } while (pred.waitStatus > 0);
    pred.next = node;
}这是因为队列中的线程可以随时退出等待,所以当发现前驱结点的waitStatus是CANCELLED时,这说明搞不好自己有机会成为队列中第二个结点哦(走狗屎运了,头结点到本节点之间的所有线程全部放弃了),所以一直往前找,直到找到第一个没有退出的结点(可能是头结点,也可能是其他结点,毕竟大家都是正经人,谁会随随便便让别人踩狗屎运呢)
用图说话就是这样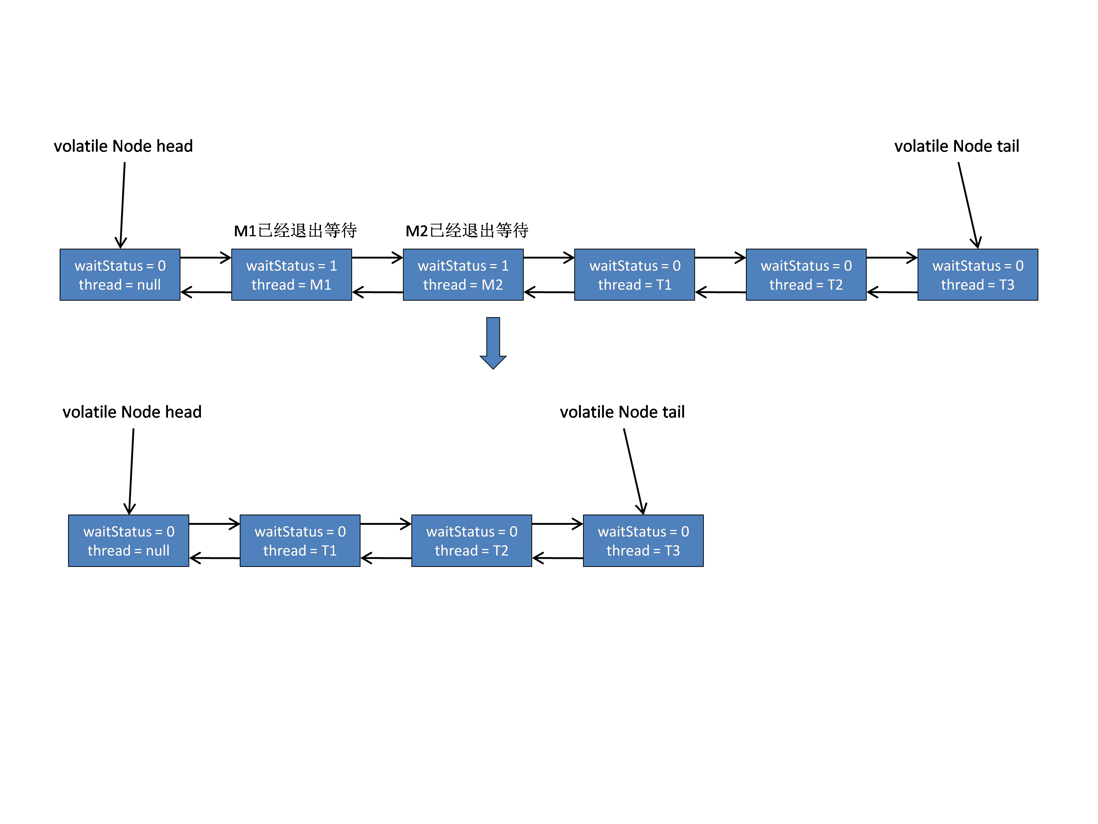
请读者再翻到上一节去看shouldParkAfterFailedAcquire()方法的源码
1 假设头结点的waitStatus已经是SIGNAL了,那么就会返回true,对于acquireQueued()方法中的shouldParkAfterFailedAcquire(p, node) && parkAndCheckInterrupt()这一行代码而言,就会继续执行parkAndCheckInterrupt()方法
private final boolean parkAndCheckInterrupt() {
    LockSupport.park(this);
    return Thread.interrupted();
}LockSupport.park()方法会让线程休眠,直到被其他线程唤醒
2 如果前驱结点已经退出,则找到第一个没有退出的结点,然后返回false
3 前两种情况都不是,那么头结点的waitStatus一定是0或者PROPAGATE(前面说过CONDITION值不会用在队列中),这两种值的处理方法都一样,将头结点的waitStatus设置为SIGNAL,表示本线程希望获得信号量的那位兄弟在释放信号量时唤醒自己,因为本线程极有可能要进入休眠了
大家可以发现,除了第一种情况会让线程立刻休眠外,其他的情况都会导致线程的执行流程又回到acquireQueued()中无限循环的开头
对于情况2,如果所有前驱线程都退出了,那么当前线程就有资格调用tryAcquire,如果此时信号量被线程X释放了,那么就能获得锁了; 如果仍然获取失败,则再次进入shouldParkAfterFailedAcquire()方法,将头结点状态置为SIGNAL,然后跟情况3一样,在休眠前执行最后一次tryAcquire
对于情况3,会最后一次调用tryAcquire,如果还是无法得到信号量,就跟情况1一样,进入shouldParkAfterFailedAcquire()直接返回true,然后直接进入parkAndCheckInterrupt()方法中进入休眠,等待唤醒
七. 多余的话
虽然我们现在是以AQS的独占模式为主题进行分析的,但是我还是想顺带提一下有关共享模式的东西。
上一节的情况3,头结点的waitStatus为0和PROPAGATE时都不会立刻休眠,而是会再多尝试一次tryAcquire,些微不同的是,创建结点时waitStatus自动初始化为0,waitStatus不会自己改变,从0转换到PROPAGATE需要共享模式下的其他线程来主动设置
其实这就是我之前对PROPAGATE含义的解释:共享模式下,释放信号量的线程要求让等待队列中的线程尽可能地在进入休眠前获得信号量PROPAGATE这个值所要表达的语义我个人参悟了很久很久,虽然源码注释里阐述了作者希望这个值所要完成的目标,但是非常难以理解,经过反复阅读源码我明白了PROPAGATE真正的含义——给线程多一次机会尝试tryAcquire。
其实默认状态0也完成了同样的功能,但我认为PROPAGATE是共享模式中表达希望降低队列线程进入休眠几率的一种显式语义
八. 进击!信号量的恩赐
咳咳,标题起过头了。这一节我们来分析,在acquireQueued()中调用tryAcquire时成功获取了信号量时的后续逻辑。不管是什么情况,获得信号量的后续逻辑都是一样的。
我们来到setHead()方法
private void setHead(Node node) {
    head = node;
    node.thread = null;
    node.prev = null;
}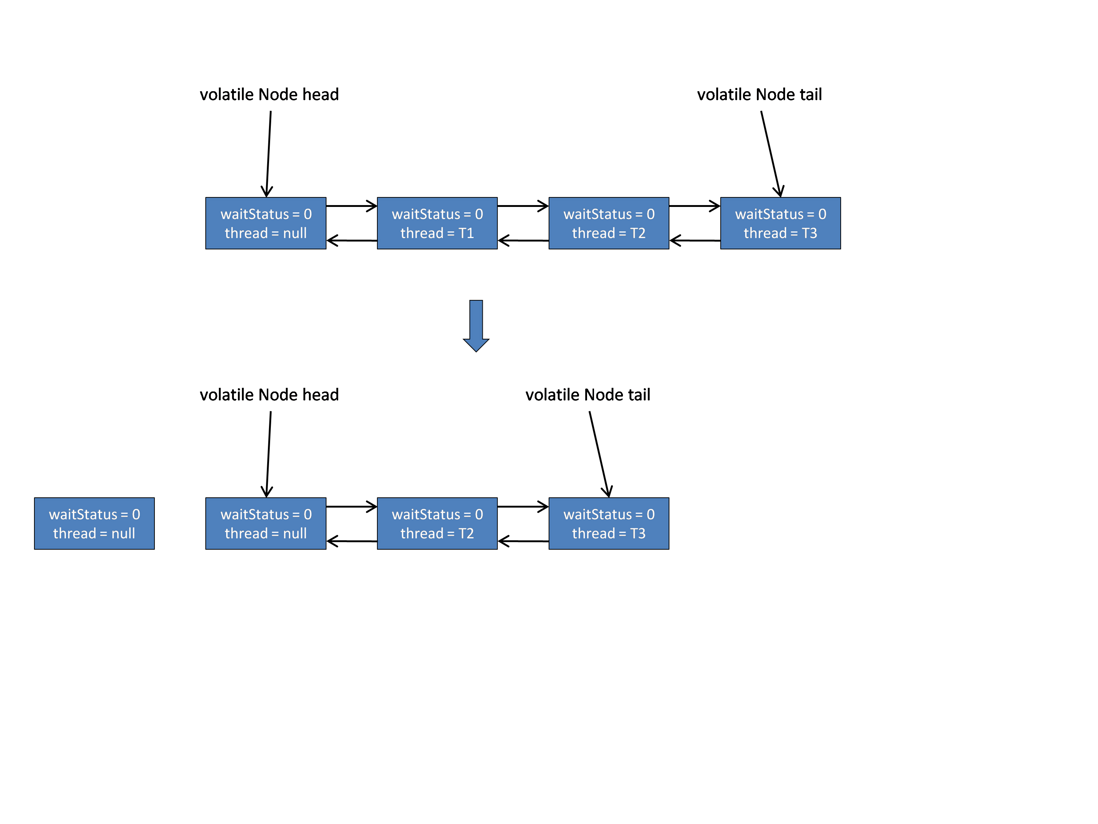
我们可以看到线程获得信号量后立刻将本结点设置为队列的头结点,这也是为什么我说头结点不可能处于CANCELLED状态——线程如果选择放弃等待,它根本就执行不到setHead方法嘛,更不可能成为头结点。
此时站在用户层面看,线程已经获得了GLock锁,可以兴高采烈地继续执行后续业务逻辑了。
九. 释放!信号量的重生
我们来看看释放信号量的过程,同样的,我们自定义的tryRelease方法在release中被回调了
public final boolean release(int releases) {
    if (tryRelease(releases)) {
        Node h = head;
        if (h != null && h.waitStatus != 0)
            unparkSuccessor(h);
        return true;
    }
    return false;
}跟tryAcquire不同的是,tryAcquire可能因为线程的竞争而导致失败,而tryRelease却不需要考虑线程竞争,它一定是成功的(因为我们是独占模式,独占模式只有一个线程能成功获得信号量嘛)
然后我们需要注意唤醒队列中的线程需要的前置条件:h != null && h.waitStatus != 0,只有头结点的状态不是0的时候才去唤醒头结点的后继线程。
我们想想头结点除了0会有哪些状态,CANCELLED直接排除,PROPAGATE也直接排除(我们是独占模式哦),CONDITION也排除,我们只剩下SIGNAL了。
是的,聪明的你一定想起来在shouldParkAfterFailedAcquire()方法中将头结点状态设置为SIGNAL的场景了SIGNAL的含义清晰了——后继线程通过设置前驱结点的SIGNAL状态来表达希望前驱释放信号量时唤醒自己之意图
我们来仔细思考下,是否存在这种情况:后继结点tryAcquire失败,但是尚未将头结点设置为SIGNAL,而此时前驱线程释放了信号量,并且发现头结点的状态依然是0,于是不唤醒后继线程,最后后继线程陷入无限的休眠之中。首先我们明确一下线程从初次尝试获取信号量,到进入休眠的过程中经过了哪些步骤
tryAcquire(acquire方法中)tryAcquire(acquireQueued方法中)compareAndSetHead(SIGNAL)(shouldParkAfterFailedAcquire方法中)tryAcquire(acquireQueued方法中)LockSupport.park进入休眠 (parkAndCheckInterrupt方法中)
我们可以发现,前驱线程得到头结点状态是0的情况只可能发生在第4步以前,我们考察最极限的情况: 在后继线程执行CPU汇编指令cmpxchg之前刚好轮到前驱线程执行,此时前驱线程得知头结点依然是0,下一刻头结点状态就被设置为SIGNAL。
那么这样极端的情况是否会造成线程无限休眠呢?显然不会,因为第4步又做了一次信号量获取——你可以偷懒不去尽全力唤醒我,但我一定会反复确认信号量是否有剩余。确保了极限情况下依然能正确运行。
十. 结语
AQS的独占模式还是比较容易理解的,总结起来就是
- 初次尝试获取信号量失败则进入队列
- 只有队列中的第一个线程才能尝试获取信号量
OK,今天就到这里,文章下半部会针对AQS的共享模式进行分析,下期再会!
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论