【数据结构与算法】二、复杂度分析
文章目录
只要讲到数据结构和算法,就一定离不开时间、空间复杂度分析。复杂度分析是整个算法学习的精髓,只要掌握了它,数据结构和算法的内容基本上就掌握了一半。
为什么需要复杂度分析?
事后分析法:把代码跑一遍,通过统计、监控、就能得到算法执行的时间、占用的内存大小,但是这种统计方法具有很大的局限性。
1、测试结果依赖测试环境
测试环境中,硬件的不同会对测试结果有很大的影响,比如 i9 的运算速度会比 i3 快,或者在 A 计算机上执行某个代码块a 的速度比另一个代码块 b 的速度要快,放到 B 计算机上可能又会得到不同的结果。
2、测试结果受测试数据的规模的影响很大
如果是在测试排序算法,测试数据的有序性很可能会影响不同排序算法的执行时间;如果测试数据规模太小,测试结果有可能无法真实地反映算法的性能。
我们需要一个不需要用具体的测试数据来测试,就可以粗略的估计算法的执行效率的方法。这就是时间、空间复杂度分析。
大 O 复杂度表示法
算法的执行效率,粗略地讲,就是算法的执行时间。但是如何在不运行代码的情况下,用“肉眼”得到一段代码的执行时间呢?
这里有一段非常简单的代码例 1,求 1,2,3...n 的累加和:
例 1:
1  int cal(int n){
2    int sum = 0;
3    int i = 1;
4    for(; i <= n; i ++){
5       sum = sum + i;
6    }
7
8    return sum;
9  }
从 CPU 的角度来看,例 1 的代码的每一行都执行着类似的操作:读数据 -- 运算 -- 写数据。尽管每一行代码对应的 CPU 执行的个数、执行时间都不一样,但是,我们这里只是粗略估计,所以可以假设每行代码执行的时间都为 unit_time。
例 1 中,第 2、3、8 行代码需要 3 * unit_time 的执行时间;第 4、5 行都运行了 n 遍,需要 2n * unit_time 的执行时间;总的执行时间就是T(n) = ( 2n + 3 ) * unit_time 。可以看出,所有代码的执行时间 T(n) 与每行代码的执行次数成正比。
再看例 2:
例 2:
1  int cal(int n){
2    int sum = 0;
3    int i = 1;
4    int j = 1;
5    for(; i <= n; i ++){
6      j = 1;
7      for(; j <= n; j ++){
8        sum = sum + i;
9      }
10   }
11
12   return sum;
13  }
例 2 中,第 2、3、4、12 行代码需要 4 * unit_time 的执行时间;第 5、6 行代码需要 2n * unit_time 的执行时间;第 7、8 行代码循环执行了 n² 遍,需要 2 * n² * unit_time 的执行时间;总的执行时间就是 T(n) = ( 2n² + 2n + 4 ) * unit_time 。
根据例1 和例 2 的推导过程,可以得到一个非常重要的规律:所有的代码的执行时间 T(n) 与每行代码的执行次数 n 成正比。
我们把这个规律总结成一个公式,就是大 O 复杂度表示法:

其中,T(n) 表示代码执行的时间,n 表示数据规模的大小,f(n) 表示每行代码执行的次数总和;O 表示代码的执行时间 T(n) 与代码的执行次数 f(n) 成正比。
用大 O 复杂度表示法来表达时间复杂度,例 1 为 T(n) = O( 2n + 3),例 2 为 T(n) = O( 2n² + 2n + 4 )。大 O 时间复杂度实际上并不具体表示代码真正的执行时间,而是表示代码执行时间随数据规模增长的变化趋势,所以也叫做渐进时间复杂度(asymptotic time complexity),简称时间复杂度。
当 n 很大时,公式中的低阶、常量、系数三部分并不左右增长趋势,所以都可以忽略,只需要记录一个最大量级就可以了。例 1、例 2 的时间复杂度,就分别可以记为: T(n) = O( n );T(n) = O( n² )。
时间复杂度分析
1、只关注循环执行次数最多的一段代码
大 O 复杂度表示方法,只是表示一种变化趋势,我们通常会忽略掉公式中的常量、低阶、系数,只需记录一个最大阶的量级就可以了。
我们在分析一个算法、一段代码的时间复杂度的时候,只关注循环执行次数最多的那一段代码就可以了。这段核心代码执行次数的 n 的量级,就是整段要分析代码的时间复杂度。
仍以例 1 为例:
例 1:
1  int cal(int n){
2    int sum = 0;
3    int i = 1;
4    for(; i <= n; i ++){
5      sum = sum + i;
6    }
7
8    return sum;
9  }
其中第 2、3、8 行代码都是常量级的执行时间,与 n 的大小无关,所以对于时间复杂度并没有影响。循环执行次数最多的是第 4、5 行代码,所以这块代码要重点分析。由于这两行代码被执行了 n 次,所以总的时间复杂度就是 O( n )。
2、加法法则:总复杂度等于量级最大的那段代码的复杂度
下面大家看例 3:
例 3:
1  int cal(int n){
2    int sum_1 = 0;
3    int p = 1;
4    for(; p < 100; p ++){
5      sum_1 = sum_1 + p;
6    }
7
8    int sum_2 = 0;
9    int q = 1;
10   for(; q < n; q ++){
11     sum_2 = sum_2 + q;
12   }
13
14   int sum_3 = 0;
15   int i = 1;
16   int j = 1;
17   for(; i <= n; i ++){
18     j = 1;
19     for(; j <= n; j ++){
20         sum_3 = sum_3 + i * j;
21     }
22   }
23
24   return sum_1 + sum_2 + sum_3;
25 }
例 3 的代码分为三部分,分别求 sum_1 、sum_2 、sum_3 。
- 第一段代码循环执行了 100 次,所以是一个常量的执行时间,跟 n 的规模无关;
- 第二段代码的 10、11 一共执行了 2n 次,所以时间复杂度 T(n) = O( n ) ;
- 第三段代码的 19、20 行代码一共执行了 2n² 次,所以时间复杂度是 T(n) = O( n² )。
综合这三段代码的时间复杂度,我们取其中最大的量级,所以整段代码的时间复杂度为 T(n) = O( n² )。也就是说,总的时间复杂度,等于量级最大的那段代码的时间复杂度。
将这个规律抽象成公式,如下:
如果:
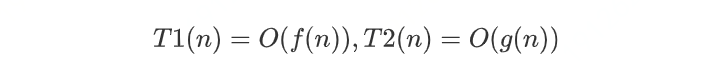
那么:
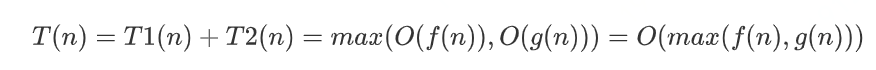
3、乘法法则:嵌套代码的复杂度等于嵌套内外代码复杂度的乘积
有如下代码例 4:
例 4:
1  int cal(int n){
2    int ret = 0;
3    int i = 1;
4    for(; i < n; i ++){
5      ret = ret + f(i);
6    }
7
8    return ret;
9  }
10
11 int f(int n){
12   int sum = 0;
13   int i = 1;
14   for(; i < n; i ++){
15       sum = sum + i;
16   }
17
18   return sum;
19 }
例 4 的代码为嵌套循环代码。假设 f() 只是一个普通的操作,那 4、5 行的时间复杂度就是T1(n) = O( n )。但是,f() 函数本身不是一个简单的操作,它的时间复杂度为T2(n) = O( n )。所以,例 4 中整个 cal() 函数的时间复杂度就是T(n) = T1(n) * T2(n) = O( n * n ) = O( n² )。
也就是说,总的时间复杂度,等于循环调用代码的时间复杂度的乘积。
将这个规律抽象成公式,如下:
如果:
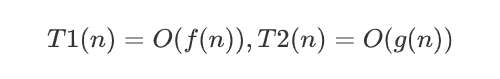
那么:
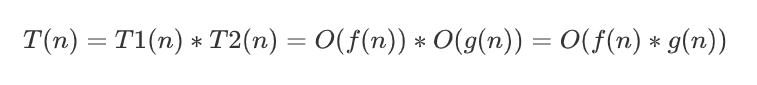
几种常见的时间复杂度
常见的复杂度量级并不多,粗略的分为两类:多项式量级和非多项式量级。
多项式量级:
- 常量阶 O(1)
- 对数阶 O(㏒n)
- 线性阶 O(n)
- 线性对数阶 O(n ㏒n)
- 平方阶 O(n²)、立方阶 O(n³) ... k次方阶 O(nᵏ)
非多项式量级:
- 指数阶 O(2ⁿ)
- 阶乘阶 O( n! )
我们把时间复杂度为非多项式量级的算法问题叫做 NP(Non-Deterministic Polynomial,非确定多项式)问题。
当数据规模越来越大时,非多项式量级算法的执行时间和急剧增加,求解问题的执行时间会无线增长。所以,非多项式时间复杂度的算法其实是非常低效的算法。了解几种常见的多项式时间复杂度即可:
1、O(1)

2、O(㏒n)、O(n ㏒n)

3、O(m+n)、O(m\*n)
空间复杂度分析
前面提到,时间复杂度的全称是渐进时间复杂度,表示算法的执行时间与数据规模之间的增长关系。
类比一下,空间复杂度全称就是渐进空间复杂度,表示算法的存储空间与数据规模之间的增长关系。
相对时间复杂度来说,空间复杂度分析要简单得多。
下面看一下例 5:
例 5:
1  void print(int n){
2    int i = 0;
3    int[]a= new int[n];
4    for(; i < n; i ++){
5      a[i] = i * i;
6    }
7
8    for(i = n - 1; i >= 0; i --){
9      System.out.println(a[i]);
10   }
11 }
跟时间复杂度分析一样,可以看到,第 2 行代码中,我们申请了一个空间存储变量 i,但是它是常量阶的,与数据规模 n 无关,所以可以忽略;第 3 行申请了一个大小为 n 的 int 类型数组;除此之外,剩下的代码都没有占用更多的空间,所以整段代码的空间复杂度就是 O( n )。
我们常见的空间复杂度就是O( 1 )、O( n )、O( n² )。
最好、最坏情况时间复杂度
例 6:
例 6:
1  int find(int[]array,
   /*n 表示数组 array 长度*/int n,
   /*x 表示需要寻找的数字*/int x){
2    int i = 0;
3    int pos = -1;
4    for(; i < n; i ++){
5      if(array[i] == x){
6        pos = i;
7      }
8    }
9
10   return pos;
11 }
例 6 要实现的功能,是在一个无序的数组中,查找变量 x 出现的位置,如果没有找到,就返回 -1;按照大 O 表示法,例 6 的时间复杂度是 O( n ),其中,n 代表数组长度。
但是,我们在数组中查找某一个数字,不用全部都遍历一遍,有可能半途中就找到了,就可以提前结束循环了。
将例 6 改进后,得到例 7:
例 7:
1  int find(int[]array,
   /*n 表示数组 array 长度*/int n,
   /*x 表示需要寻找的数字*/int x){
2    int i = 0;
3    int pos = -1;
4    for(; i < n; i ++){
5      if(array[i] == x){
6        pos = i;
7        break;
8      }
9    }
10
11   return pos;
12 }
不同的情况下,例 7 的时间复杂度是不一样的:
- 如果数组中的第一个数字刚好是 x,那例 7 的时间复杂度就是 O( 1 )
- 如果数组中的最后一个数字才是 x,那例 7 的时间复杂度就是 O( n )
下面引入三个概念,用来表示代码在不同情况下的不同时间复杂度:
1、最好情况时间复杂度
最好情况时间复杂度,就是在最理想的情况下,执行这段代码的时间复杂度。
例 7 中,如果数组中第一个数字就是 x,那这时候的时间复杂度就是最好情况时间复杂度。
2、最坏情况时间复杂度
最坏情况时间复杂度,就是在最不理想的情况下,执行这段代码的时间复杂度。
例 7 中,如果数组中 x 是最后一个数字,那这时候的时间复杂度就是最坏情况时间复杂度。
3、平均情况时间复杂度
最好情况时间复杂度和最坏情况时间复杂度都是出现在极端环境下的代码复杂度,发生的概率并不大。为了更好地表示平均情况下的复杂度,我们需要分析平均情况时间复杂度,简称平均时间复杂度。
平均时间复杂度
继续看例 7:
例 7:
1  int find(int[]array,
   /*n 表示数组 array 长度*/int n,
   /*x 表示需要寻找的数字*/int x){
2    int i = 0;
3    int pos = -1;
4    for(; i < n; i ++){
5      if(array[i] == x){
6        pos = i;
7        break;
8      }
9    }
10
11   return pos;
12 }
在例 7 中,我们要查找的 x 所在的位置有 n+1 种情况:
- 前 n 种情况:x 在数组的 0 ~ n-1 的位置中
- 第 n+1 种情况:不在数组中
我们把每种情况下,查找需要遍历的元素个数累加起来,然后除以 n+1,就可以得到需要遍历的元素个数的平均值:
- 假如 x 在第 0 位,需要遍历 1 个元素(1)
- 假如 x 在第 1 位,需要遍历 2 个元素(2)
- 假如 x 在第 2 位,需要遍历 3 个元素(3)
- 假如 x 在第 n-1 位,需要遍历 n 个元素(n)
- 假如 x 不在数组中,同样需要遍历 n 个元素(n)
所以,总共的遍历个数为:

再除以总共的遍历方法 n + 1,即:
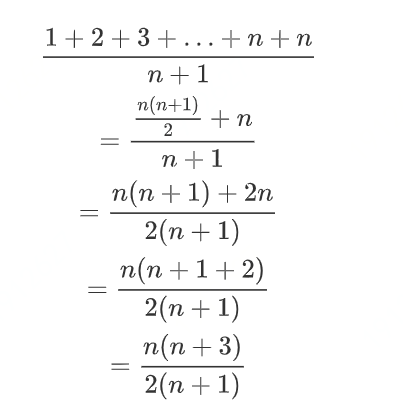
在大 O 表示法中,可以省略掉系数、低阶、常量,平均复杂度为 O( n )。
但是有一个问题,就是这 n+1 种情况,并不是等概率的。
- 首先,变量 x要么在数组里,要么不在数组里。这两种概率统计起来比较麻烦,为了方便理解,假设 x 在数组中和不在数组中的概率都为 1/2
- 另外,要查找的变量 x,在 0 ~ n-1 这 n 个位置上的概率是一样的,均为 1/n ,所以整体上,要查找的 x 在 0 ~ n-1 这 n 个位置上的的概率为 1/2n
将概率因素考虑进去,平均时间复杂度为:
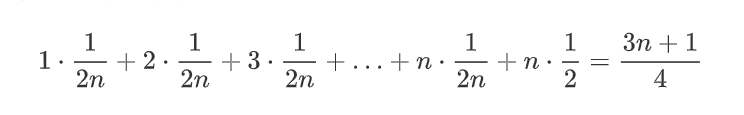
这样的计算结果叫做加权平均值,也叫做期望值,所以平均时间复杂的的实际上是加权平均时间复杂度或期望时间复杂度。
舍掉系数和常量,得到的平均时间复杂度为 O( n )。
在大多数情况下,我们并不需要区分最好、最坏、平均时间复杂度。只有同一块代码在不同情况下,时间复杂度出现了量级的差距,才会使用这三种时间复杂度来表示。
均摊时间复杂度
大部分情况下,并不需要区分最好、最坏、平均时间复杂度,平均时间复杂度只在某些特殊场景有使用,均摊时间复杂度的应用场景比平均时间复杂度更特殊、更有限。
事实上,均摊时间复杂度就是一种特殊的平均时间复杂度。
例 8:
例 8:
1  int[]array = new int[n];  // 长度为 n 的数组
2  int count = 0;
3
4  void insert(int val){
5    if(count == array.length){
6      int sum = 0;
7      for(int i = 0; i < array.length; i ++){
8        sum = sum + array[i];
9      }
10     array[0] = sum;
11     count = 1;
12   }
13   array[count] = val;
14   count ++;
15 }
例 8 实现了往数组中插入数据的功能:
- 当数组满了之后(也就是代码中 count == array.length 的时候),用 for 循环遍历数组求和,并清空数组,将求和之后的 sum 值放到数组的第一个位置,然后再将新的数据插入
- 如果数组一开始就有空闲时间,则直接将数据插入数组
所以例 8 的时间复杂度:
- 最理想的情况下,数组中有空闲时间,我们只需要将数据插入到数组下标为 count 的位置就行了,所以最好情况时间复杂度为 O( 1 )
- 最坏的情况下,数组中没有空闲空间了,我们需要先做一次数组的遍历求和,然后再将数据插入,所以最坏情况时间复杂度为 O( n )
最后通过概率计算一下平均时间复杂度:假设数组长度是 n,根据数据插入位置的不同,可以分为 n 种情况,每种情况的时间复杂度为 O( 1 );另外还有 1 种情况,假如数组中没有空闲空间时,插入一个数据的时间复杂度为O( n )。而且,这 n+1 种情况发生的概率一样,都是 1/(n+1) 。根据加权平均的计算方法,可以求得平均时间复杂度:
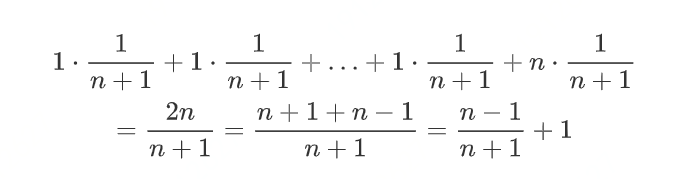
使用大 O 表示法,舍掉常量、系数、低阶,平均时间复杂度为 O( 1 )。
但是例 8 中的平均复杂度分析其实并不需要这么麻烦。再将例 7 和例 8 的代码放在一起看一下:
例 7:
1  int find(int[]array,
   /*n 表示数组 array 长度*/int n,
   /*x 表示需要寻找的数字*/int x){
2    int i = 0;
3    int pos = -1;
4    for(; i < n; i ++){
5      if(array[i] == x){
6        pos = i;
7        break;
8      }
9    }
10
11   return pos;
12 }
例 8:
1 int[]array = new int[n]; // 长度为 n 的数组
2 int count = 0;
3
4 void insert(int val){
5 if(count == array.length){
6 int sum = 0;
7 for(int i = 0; i < array.length; i ++){
8 sum = sum + array[i];
9 }
10 array[0] = sum;
11 count = 1;
12 }
13 array[count] = val;
14 count ++;
15 }- 如前所述,例 7 中的 find() 函数在极端情况下才会出现复杂度为 O(1)的情况;但是例 8 中的 insert() 函数在大部分情况下,时间复杂度都是 O(1),只有个别情况下,复杂度才为 O(n)。这是两者之间的第一个差异。
- 第二个差异,对于 insert() 函数来说,O(1) 时间复杂度和 O(n) 时间复杂度,出现的频率是非常有规律的,而且有一定的前后时序关系,一般都是一个 O(n) 插入之后,紧跟着 n-1 个 O(1)插入,循环往复。
所以,针对这样一种特殊场景的复杂度分析,并不需要之前的计算平均时间复杂度那样,引入概率计算加权平均值。由一种更加简单的分析方法:摊还分析法。通过摊还分析得到的时间复杂度,叫做均摊时间复杂度。
例 8 中的 insert() 函数,每一次 O(n) 插入操作后,都会跟着 n-1 次的 O(1) 插入操作,所以把耗时多的那次操作均摊到接下来的 n-1 次耗时少的操作上,均摊下来,这一组连续的操作的均摊时间复杂度就是 O(1)。
均摊时间复杂度和摊还分析的应用场景比较特殊,所以我们不会经常用到。它们的应用场景一般如下:
对一个数据结构进行一组连续操作中,大部分情况下时间复杂度都很低,只有个别情况下时间复杂度比较高,而且这些操作之间存在前后连贯的时序关系,这个时候我们就可以将这一组操作放在一块儿分析,看是否能将较高时间复杂度那次操作的耗时,均摊到其他那些时间复杂度比较低的操作上。而且,在能够应用均摊时间复杂度分析的场合,一般情况下均摊时间复杂度就等于最好情况时间复杂度。
思考分析
有如下代码例 9 ,试着分析一下 add() 函数的时间复杂度:
例 9:
1  int[]array = new int[10];
2  int len = 10;
3  int i = 0;
4
5  void add(int element){
6    if(i >= len){
7      int[]new_array = new int[len * 2];
8      for(int j = 0; j < len; j ++){
9        new_array[j] = array[j];
10     }
11     array = new_array;
12     len = len * 2;
13   }
14   array[i] = element;
15   i ++;
16 }
解答:
函数 add() 的作用,有两点:
- 代码 14、15 行,将给定的数据 element 按顺序放入数组 array 中,这个过程中的时间复杂度为 O(1)
- 代码 6-13 行,假如数组 array 已经存满,将数组 array 的容量扩充到原来容量的 2 倍,然后将原数组 array 元素赋值过去,再将给定的数据 element 按顺序放入数组 array 中,这个过程中的时间复杂度为O(n),n 为数组 array 扩容前的长度。
由上述可知,最好时间复杂度为O(1),最坏时间复杂度为O(n)
经过观察,可以发现,1 、 2两步是有规律执行的。没有扩容时,先执行 len 次第 1 步,再执行 1 次第 2 步,此时完成一次扩容;然后执行 2*len-1 次第 1 步,再执行 1 次第 2 步,此时完成二次扩容;归纳可得,执行的规律应该为 n 次 O(1),1 次 O(n),2*n-1 次 O(1),1 次 O(2n),4*n-1 次 O(1),1 次 O(4n)...
所以均摊复杂度应为O(1)
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论