Java的无锁原子类
文章目录
原子类示例
其实对于简单的原子性问题,还有一种无锁方案。Java SDK 并发包将这种无锁方案封装提炼之后,实现了一系列的原子类。
先看看如何利用原子类实现一个线程安全的累加器,这样你会对原子类有个初步的认识。
public class Test {
  AtomicLong count = new AtomicLong(0);
  void add10K() {
    int idx = 0;
    while(idx++ < 10000) {
      count.getAndIncrement();
    }
  }
}
将原来的 long 型变量 count 替换为了原子类 AtomicLong,原来的 count +=1 替换成了 count.getAndIncrement(),仅需要这两处简单的改动就能使 add10K() 方法变成线程安全的。
无锁方案相对互斥锁方案,最大的好处就是性能。
- 互斥锁方案为了保证互斥性,需要执行加锁、解锁操作,而加锁、解锁操作本身就消耗性能;
- 同时拿不到锁的线程还会进入阻塞状态,进而触发线程切换,线程切换对性能的消耗也很大。
无锁方案的实现原理
cas指令
其实原子类性能高的秘密很简单,硬件支持而已:
- CPU 为了解决并发问题,提供了
CAS 指令(CAS,全称是 Compare And Swap,即“比较并交换”)。 - CAS 指令包含
3 个参数:共享变量的内存地址 A、用于比较的值 B 和共享变量的新值 C;并且只有当内存中地址 A 处的值等于 B 时,才能将内存中地址 A 处的值更新为新值 C。 - 作为一条 CPU 指令,CAS 指令
本身是能够保证原子性的。
可以通过下面 CAS 指令的模拟代码来理解 CAS 的工作原理。在下面的模拟程序中有两个参数,一个是期望值 expect,另一个是需要写入的新值 newValue,只有当目前 count 的值和期望值 expect 相等时,才会将 count 更新为 newValue。
class SimulatedCAS{// 模拟实现CAS,仅用来帮助理解
  int count;
  synchronized int cas(int expect, int newValue){
    int curValue = count;// 读目前count的值
    if(curValue == expect){ // 比较目前count值是否==期望值
      count = newValue; // 如果是,则更新count的值
    }
    return curValue;// 返回写入前的值
  }
}
使用 CAS 来解决并发问题,一般都会伴随着自旋,而所谓自旋,其实就是循环尝试。因为执行CAS不一定能成功,如果失败了需要循环重试。
ABA问题
在 CAS 方案中,有一个问题可能会常被你忽略,那就是 ABA 的问题。
什么是 ABA 问题呢?假设我们更新count的值, count 原本是 A,线程 T1在读取count后,且在更新count之前,有可能 count 被线程 T2 更新成了 B,之后又被 T3 更新回了 A,这样线程 T1 虽然看到的一直是 A,但是其实已经被其他线程更新过了,这就是 ABA 问题。
可能大多数情况下我们并不关心 ABA 问题,例如数值的原子递增,但也不能所有情况下都不关心,例如原子化的更新对象很可能就需要关心 ABA 问题,因为两个 A 虽然相等,但是第二个 A 的属性可能已经发生变化了。
getAndIncrement()源码分析
原子类 AtomicLong 的 getAndIncrement() 方法内部就是基于 CAS 实现的。
在 Java 1.8 版本中,getAndIncrement() 方法会转调 unsafe.getAndAddLong() 方法。这里 this 和 valueOffset 两个参数可以唯一确定共享变量的内存地址。
final long getAndIncrement() {
  return unsafe.getAndAddLong(this, valueOffset, 1L);
}
unsafe.getAndAddLong() 方法的源码如下,该方法首先会在内存中读取共享变量的值,之后循环调用 compareAndSwapLong() 方法来尝试设置共享变量的值,直到成功为止。
public final long getAndAddLong(Object o, long offset, long delta){
  long v;
  do {
    v = getLongVolatile(o, offset);// 读取内存中的值
  } while (!compareAndSwapLong(o, offset, v, v + delta));
  return v;
}

//原子性地将变量更新为x
//条件是内存中的值等于expected
//更新成功则返回true
native boolean compareAndSwapLong(
  Object o, long offset,
  long expected,
  long x);
compareAndSwapLong() 是一个 native 方法,只有当内存中共享变量的值等于 expected 时,才会将共享变量的值更新为 x,并且返回 true;否则返回 fasle。compareAndSwapLong 的语义和 CAS 指令的语义的差别仅仅是返回值不同而已。
getAndAddLong() 方法的实现,基本上就是 CAS 使用的经典范例。
do {
  oldV = xxxx;// 获取当前值
  newV = ...oldV...// 根据当前值计算新值
}while(!compareAndSet(oldV,newV);
原子类概览
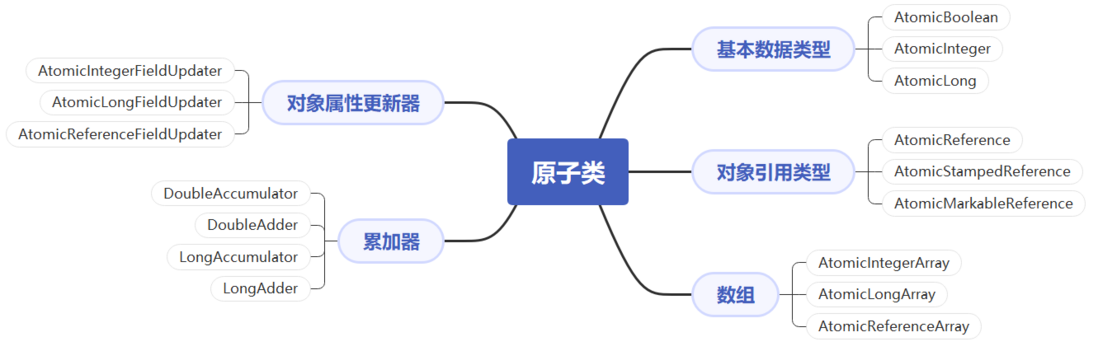
Java SDK 并发包里提供的原子类内容很丰富,我们可以将它们分为五个类别:
- 原子化的基本数据类型
- 原子化的对象引用类型
- 原子化数组
- 原子化对象属性更新器
- 原子化的累加器。
1.原子化的基本数据类型
相关实现有 AtomicBoolean、AtomicInteger 和 AtomicLong,提供的方法主要有以下这些,详情你可以参考 SDK 的源代码
getAndIncrement() //原子化i++
getAndDecrement() //原子化的i--
incrementAndGet() //原子化的++i
decrementAndGet() //原子化的--i

getAndAdd(delta) //当前值+=delta,返回+=前的值
addAndGet(delta)//当前值+=delta,返回+=后的值

compareAndSet(expect, update)//CAS操作,返回是否成功

//以下四个方法,新值可以通过传入func函数来计算
getAndUpdate(func)
updateAndGet(func)
getAndAccumulate(x,func)
accumulateAndGet(x,func)
2.原子化的对象引用类型
相关实现有 AtomicReference、AtomicStampedReference 和 AtomicMarkableReference,利用它们可以实现对象引用的原子化更新。AtomicReference 提供的方法和原子化的基本数据类型差不多,这里不再赘述。
不过需要注意的是,对象引用的更新需要重点关注 ABA 问题,AtomicStampedReference 和 AtomicMarkableReference 这两个原子类可以解决 ABA 问题。
解决 ABA 问题的思路其实很简单,增加一个版本号维度就可以了。AtomicStampedReference 实现的 CAS 方法就增加了版本号参数,方法签名如下:
boolean compareAndSet(
  V expectedReference,
  V newReference,
  int expectedStamp,
  int newStamp)
AtomicMarkableReference 的实现机制则更简单,将版本号简化成了一个 Boolean 值,方法签名如下:
boolean compareAndSet(
  V expectedReference,
  V newReference,
  boolean expectedMark,
  boolean newMark)
3. 原子化数组
相关实现有 AtomicIntegerArray、AtomicLongArray 和 AtomicReferenceArray,利用这些原子类,我们可以原子化地更新数组里面的每一个元素。这些类提供的方法和原子化的基本数据类型的区别仅仅是:每个方法多了一个数组的索引参数,所以这里也不再赘述了。
4.原子化对象属性更新器
相关实现有 AtomicIntegerFieldUpdater、AtomicLongFieldUpdater 和 AtomicReferenceFieldUpdater,利用它们可以原子化地更新对象的属性,这三个方法都是利用反射机制实现的,创建更新器的方法如下:
public static <U> AtomicXXXFieldUpdater<U> newUpdater(Class<U> tclass, String fieldName)需要注意的是,对象属性必须是 volatile 类型的,只有这样才能保证可见性;如果对象属性不是 volatile 类型的,newUpdater() 方法会抛出 IllegalArgumentException 这个运行时异常。
newUpdater() 的方法参数只有类的信息,没有对象的引用,而更新对象的属性,一定需要对象的引用,所以对象的引用是在原子操作的方法参数中传入的。
原子化对象属性更新器相关的方法,相比原子化的基本数据类型仅仅是多了对象引用参数。例如 compareAndSet() 这个原子操作,相比原子化的基本数据类型多了一个对象引用 obj。
boolean compareAndSet(T obj, int expect, int update)优点:
- 相比于原子化的基本数据类型,原子化对象属性更新器仅需要在抽象的父类中声明一个静态的更新器,就可以在各个对象中使用了。在所属类会被创建大量实例对象的情况下,使用AtomicXXXFieldUpdater可以节约内存开销。
5.原子化的累加器
DoubleAccumulator、DoubleAdder、LongAccumulator 和 LongAdder,这四个类仅仅用来执行累加操作,相比原子化的基本数据类型,速度更快,但是不支持 compareAndSet() 方法。如果你仅仅需要累加操作,使用原子化的累加器性能会更好。
// LongAdder初始值固定为0
LongAdder longAdder = new LongAdder();
longAdder.add(2);
longAdder.increment();

// LongAccumulator需要设定初始值,并且需要设定累加规则
LongAccumulator longAccumulator = new LongAccumulator((x, y) -> x - y, 3);
longAccumulator.accumulate(2);
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论