探花06(安装jdk)
文章目录
安装jdk
1、在/usr/local 目录下新建Java文件夹
mkdir /usr/local/java将jdk拷贝到 /usr/local/java 进入到java文件夹,解压压缩包
tar -zxvf jdk-8u281-linux-x64.tar.gz
2、设置环境变量 这里采用全局设置方法,就是修改etc/profile,它是是所有用户的共用的环境变量 找到/etc/profile,编辑,在末尾添加
# java的配置
export JAVA_HOME=/usr/local/java/jdk1.8.0_281/
export JRE_HOME=/usr/local/java/jdk1.8.0_281/jre
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib:$CLASSPATH
export PATH=$JAVA_HOME/bin:$PATH
在上述添加过程中,等号两侧不要加入空格,不然会出现“不是有效的标识符”,因为source /etc/profile 时不能识别多余到空格,会理解为是路径一部分。
然后保存。
运行以下命令,使profile生效。
source /etc/profile3、检验是否成功 在终端
java -version
javac
spark的环境准备
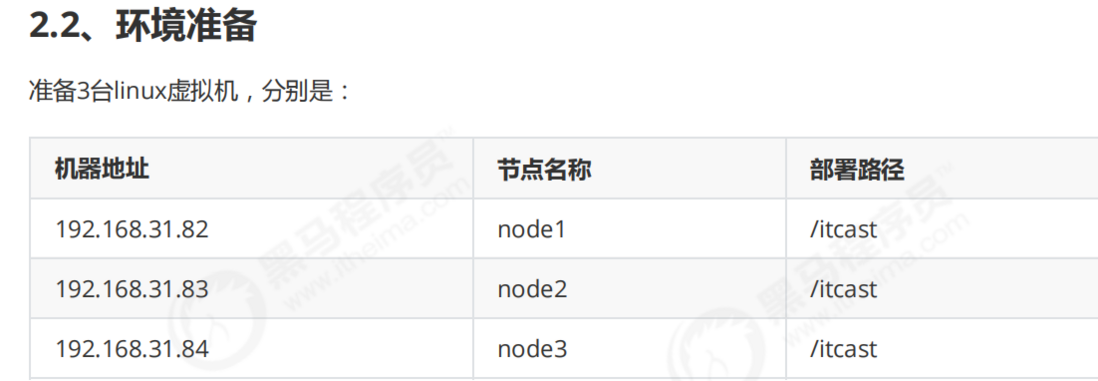
在hosts文件中添加节点的映射:
vim /etc/hosts
192.168.31.82 itcast
192.168.31.82 node1 node01
192.168.31.83 node2 node02
192.168.31.84 node3 node03
#关闭防火墙
systemctl stop firewalld.service
#禁止开机启动
systemctl disable firewalld.service
修改hosts文件后
/etc/init.d/network restart即可生效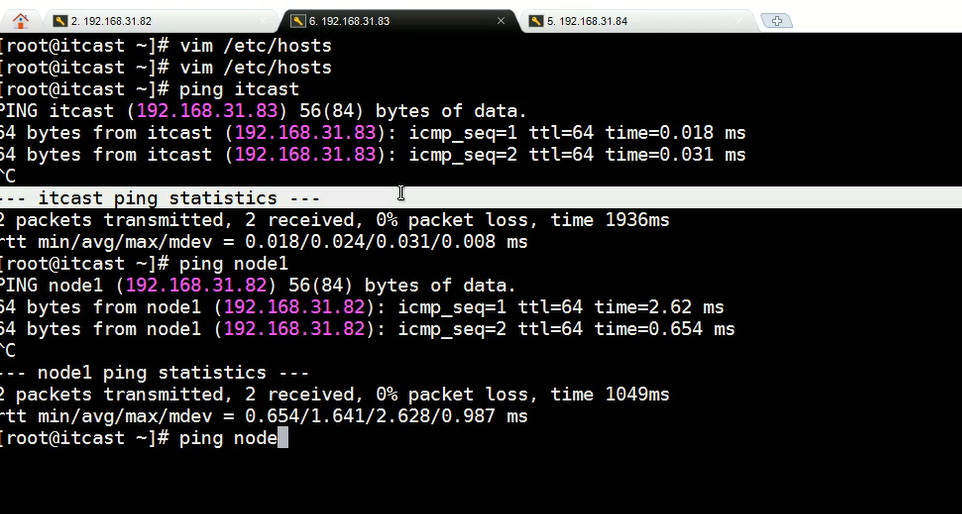
免密登录
在node1上
生成秘钥,一路回车
ssh-keygen
ssh-copy-id node1
ssh-copy-id node2
ssh-copy-id node3
部署集群
调整机器时间
date命令查看时间
#创建安装目录,3台机器都要创建
mkdir /itcast
#上传spark-2.4.3-bin-hadoop2.7.tgz到该目录,进行解压
tar -xvf spark-2.4.3-bin-hadoop2.7.tgz
mv spark-2.4.3-bin-hadoop2.7 spark
#修改配置
cd spark/conf
mv spark-env.sh.template spark-env.sh
vim spark-env.sh
#在最上面插入如下信息(3台机器都是如此)
export JAVA_HOME=/usr/local/src/java/jdk1.8.0_141 #jdk地址
export SPARK_MASTER_HOST=node1 #指定master的主机名
export SPARK_MASTER_PORT=7077#master的端口
mv slaves.template slaves vim slaves
#输入如下内容(3台机器都是如此)
node1 node2 node3
#远程拷贝到其它机器
scp -r spark node2:/itcast/ scp -r spark node3:/itcast/
#添加环境变量(3台都添加)
vim /etc/profile
export SPARK_HOME=/itcast/spark
export PATH=$PATH:$SPARK_HOME/bin
export PATH=$PATH:$SPARK_HOME/sbin
source /etc/profile
#启动(只在node1节点启动即可)
cd /itcast/spark/sbin ./start-all.sh

这个jdk需要根据自己电脑的配置进行设置
启动集群后查看
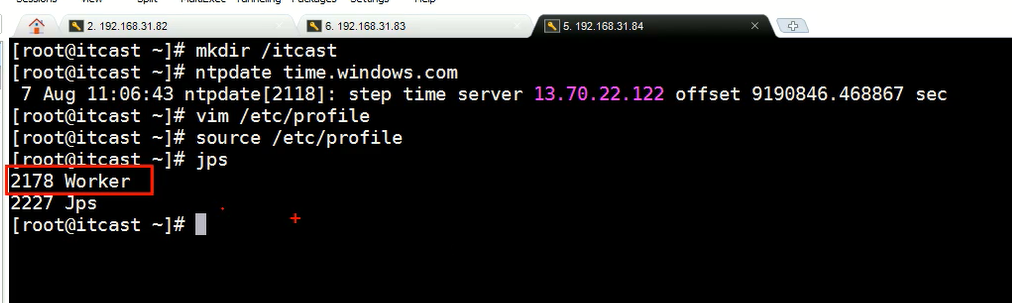
启动spark后在主从机上查看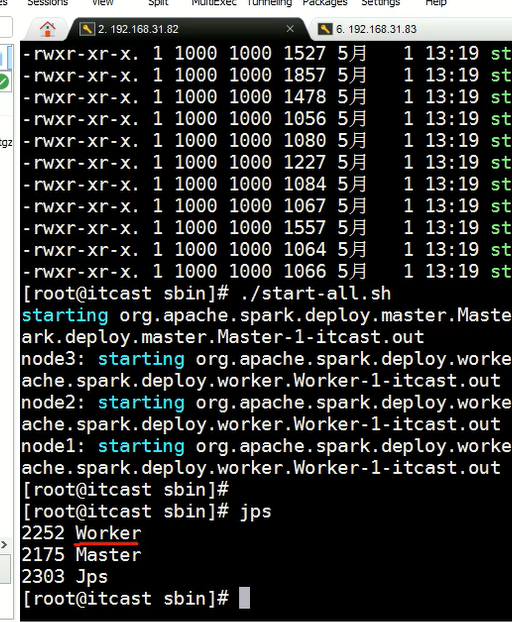

Spark高可用搭建
# 修改三台机器的host文件
vim /etc/hosts
#添加zookeeper的ip,并起名叫zk

#修改spark配置
vim spark-env.sh
export SPARK_MASTER_HOST=node1 #把这个注释掉
#增加ZooKeeper的配置
export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=zk:2181 -Dspark.deploy.zookeeper.dir=/spark"
参数说明:
spark.deploy.recoveryMode:恢复模式(Master 重新启动的模式)
有三种:(1) ZooKeeper (2) FileSystem (3) NONE
spark.deploy.zookeeper.url:ZooKeeper 的Server 地址
spark.deploy.zookeeper.dir:保存集群元数据信息的文件、目录。包括Worker,Driver 和
Application。
进入/itacst/spark/conf下边
有个spark-env.sh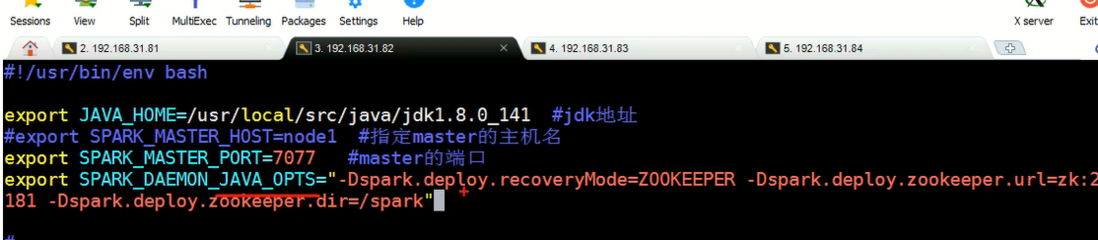
发现模式是通过revoveryMode=zookeeper
修改完spark-env.sh后,
在三台机器上停掉所有的服务
./stop-all.sh182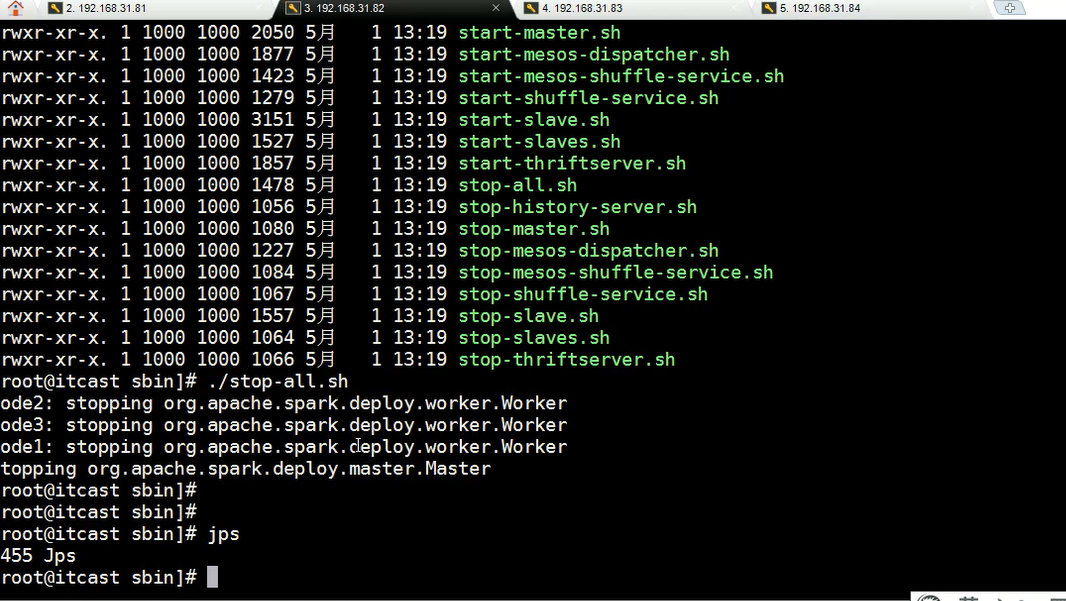
184
启动集群
#启动HA集群,不能通过start-all.sh的方式启动,会导致找不到master #首先,将3台机器的master启动起来
./sbin/start-master.sh
#然后,分别启动每个机器上的slave
./start-slave.sh spark://node1:7077
#这里的node1是当前的master,需要通过zk中查看 哪个机器是master #最后就可以通过停止master的方式进行测试了
启动集群后的结果
spark应用入门
word.txt
hello world
hello spring
hello mvc
hello spark
1
package cn.itcast.spark;

import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaPairRDD;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import org.apache.spark.api.java.function.FlatMapFunction;
import org.apache.spark.api.java.function.Function2;
import org.apache.spark.api.java.function.PairFunction;
import scala.Int;
import scala.Tuple2;

import java.util.Arrays;
import java.util.Iterator;
import java.util.List;

public class WordCountApp {

    public static void main(String[] args) {

        // spark的配置
        SparkConf sparkConf = new SparkConf()
                .setAppName("WordCountApp")
                .setMaster("local[*]"); //本地模式,并且使用和cpu的内核数相同的线程数进行执行

        // 定义上下文对象,它是程序的入口
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);

        // 读取文件
        JavaRDD<String> fileRdd = jsc.textFile("F://code//word.txt");

        // 压扁操作,并且按照空格分割
        JavaRDD<String> flatMapRdd = fileRdd.flatMap(new FlatMapFunction<String, String>() {
            @Override
            public Iterator<String> call(String s) throws Exception {
                String[] ss = s.split(" ");
                return Arrays.asList(ss).iterator();
            }
        });

        // 对单词做计数
        JavaPairRDD<Object, Integer> mapToPairRdd = flatMapRdd.mapToPair(new PairFunction<String, Object, Integer>() {
            @Override
            public Tuple2<Object, Integer> call(String s) throws Exception {
                return new Tuple2<>(s, 1);
            }
        });

        // 对相同的单词做相加操作
        JavaPairRDD<Object, Integer> reduceByKeyRdd = mapToPairRdd.reduceByKey(new Function2<Integer, Integer, Integer>() {
            @Override
            public Integer call(Integer v1, Integer v2) throws Exception {
                return v1 + v2;
            }
        });

        // 执行计算
        List<Tuple2<Object, Integer>> collect = reduceByKeyRdd.collect();
        for (Tuple2<Object, Integer> obj : collect) {
            System.out.println(obj._1() + "出现的次数为:"+ obj._2());
        }


        // 关闭,释放资源
        jsc.stop();
    }
}
2 连贯操作
package cn.itcast.spark;

import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaPairRDD;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import org.apache.spark.api.java.function.FlatMapFunction;
import org.apache.spark.api.java.function.Function2;
import org.apache.spark.api.java.function.PairFunction;
import scala.Tuple2;

import java.util.Arrays;
import java.util.Iterator;
import java.util.List;

public class WordCountApp2 {

    public static void main(String[] args) {

        // spark的配置
        SparkConf sparkConf = new SparkConf()
                .setAppName("WordCountApp2")
                .setMaster("local[*]"); //本地模式,并且使用和cpu的内核数相同的线程数进行执行

        // 定义上下文对象,它是程序的入口
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);

        // 读取文件
        JavaRDD<String> fileRdd = jsc.textFile("F://code//word.txt");

        // 单词计数的逻辑处理
        List<Tuple2<String, Integer>> list = fileRdd.flatMap(s -> {
            String[] ss = s.split(" ");
            return Arrays.asList(ss).iterator();
        }).mapToPair(s -> new Tuple2<>(s, 1))
                .reduceByKey((v1, v2) -> v1 + v2)
                .collect();


        // 遍历输出
        list.forEach(obj -> System.out.println(obj._1() + "出现的次数为:" + obj._2()));


        // 关闭,释放资源
        jsc.stop();
    }
}
3 打包到线上运行
package cn.itcast.spark;

import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaPairRDD;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import org.apache.spark.api.java.function.FlatMapFunction;
import org.apache.spark.api.java.function.Function2;
import org.apache.spark.api.java.function.PairFunction;
import scala.Tuple2;

import java.util.Arrays;
import java.util.Iterator;
import java.util.List;

public class WordCountApp3 {

    public static void main(String[] args) {

        // spark的配置
        SparkConf sparkConf = new SparkConf()
                .setAppName("WordCountApp");
//                .setMaster("local[*]"); //本地模式,并且使用和cpu的内核数相同的线程数进行执行

        // 定义上下文对象,它是程序的入口
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);

        // 读取文件
        JavaRDD<String> fileRdd = jsc.textFile(args[0]);

        // 压扁操作,并且按照空格分割
        JavaRDD<String> flatMapRdd = fileRdd.flatMap(new FlatMapFunction<String, String>() {
            @Override
            public Iterator<String> call(String s) throws Exception {
                String[] ss = s.split(" ");
                return Arrays.asList(ss).iterator();
            }
        });

        // 对单词做计数
        JavaPairRDD<Object, Integer> mapToPairRdd = flatMapRdd.mapToPair(new PairFunction<String, Object, Integer>() {
            @Override
            public Tuple2<Object, Integer> call(String s) throws Exception {
                return new Tuple2<>(s, 1);
            }
        });

        // 对相同的单词做相加操作
        JavaPairRDD<Object, Integer> reduceByKeyRdd = mapToPairRdd.reduceByKey(new Function2<Integer, Integer, Integer>() {
            @Override
            public Integer call(Integer v1, Integer v2) throws Exception {
                return v1 + v2;
            }
        });

        // 保存结果到指定的目录或文件
        reduceByKeyRdd.saveAsTextFile(args[1]);


        // 关闭,释放资源
        jsc.stop();
    }
}
打包到集群上运行
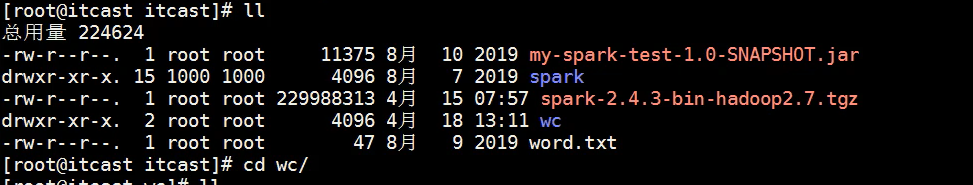
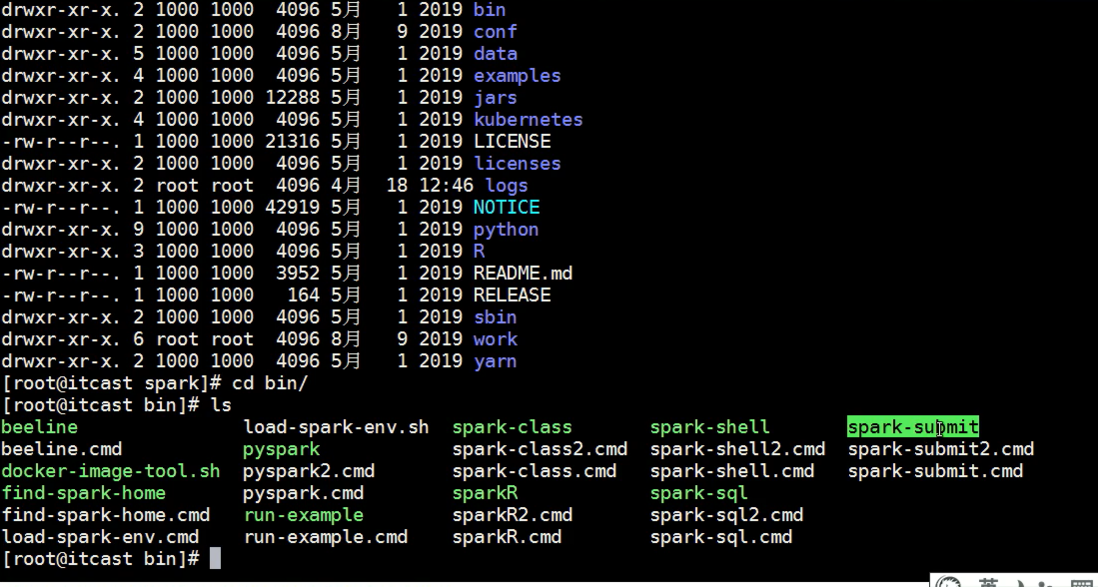
cd /itcast/bin下
./spark-submit --master spark://node1:7077 --class cn.itcast.spark.WordCountApp3 /itcast/my-spark-test-1.0-SNAPSHOT.jar /itcast/word.txt /itcast/wc查看运行后的结果
cat part-00000 part-00001

弹性分布式数据集RDD
6.1、RDD概述
6.1.1、什么是RDD
RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据抽象,它代表
一个不可变、可分区、里面的元素可并行计算的集合。RDD具有数据流模型的特点:自动容错、位置感
知性调度和可伸缩性。RDD允许用户在执行多个查询时显式地将数据缓存在内存中,后续的查询能够重
用这些数据,这极大地提升了查询速度。
Dataset:一个数据集合,用于存放数据的。
Distributed:RDD中的数据是分布式存储的,可用于分布式计算。
Resilient:RDD中的数据可以存储在内存中或者磁盘中。
6.1.2、为什么会产生RDD?
传统的MapReduce虽然具有自动容错、平衡负载和可拓展性的优点,但是其最大缺点是采用非循
环式的数据流模型,使得在迭代计算中要进行大量的磁盘IO操作。RDD正是解决这一缺点的抽象
方法。
RDD是Spark提供的最重要的抽象的概念,它是一种具有容错机制的特殊集合,可以分布在集群的
节点上,以函数式编程来操作集合,进行各种并行操作。可以把RDD的结果数据进行缓存,方便
进行多次重用,避免重复计算。
6.2、RDD的类型
Spark中的操作大致可以分为四类操作,分别是创建操作、转换操作、控制操作和行为操作。
创建操作:用于RDD创建工作,RDD的创建只有两种方法:
一种是来自于内存集合和外部存储系统
通过转换操作生成的RDD
转换操作:将RDD通过一定的操作变换成新的RDD
比如:RDD通过flatMap操作后得到新的RDD
控制操作:进行RDD持久化,可以让RDD按不同的存储策略保存在磁盘或者内存中。
行为操作:能够触发Spark的运行操作,比如:collect的操作就是行为操作
map
map是对RDD中的每个元素都执行一个指定的函数来产生一个新的RDD。 任何原RDD中的元素在新
RDD中都有且只有一个元素与之对应。
连贯操作变量的数据类型跟初始的RDD中的数据类型一致
@Test
public void testMap() {
    SparkConf sparkConf = new SparkConf()
            .setAppName("RddOperation")
            .setMaster("local[*]");
    JavaSparkContext jsc = new JavaSparkContext(sparkConf);

    // 生成一个测试rdd数据集
    JavaRDD<Integer> rdd1 = jsc.parallelize(Arrays.asList(1, 2, 3, 4, 5));


    // 将rdd1中每一个元素都乘以2,生成新的rdd
//        JavaRDD<Integer> rdd2 = rdd1.map(new MyFunction()); 方案一
    JavaRDD<Integer> rdd2 = rdd1.map(v1 -> v1 * 2); //方案二

    List<Integer> list = rdd2.collect();
    list.forEach(integer -> System.out.println(integer));

    jsc.stop();
}
结果是遍历输出2,4,6,8,10
filter
filter 是对RDD中的每个元素都执行一个指定的函数来过滤产生一个新的RDD。 任何原RDD中的元素在
新RDD中都有且只有一个元素与之对应。
连贯操作变量的数据类型跟初始的RDD中的数据类型一致
@Test
public void testFilter(){
    SparkConf sparkConf = new SparkConf()
            .setAppName("RddOperation")
            .setMaster("local[*]");
    JavaSparkContext jsc = new JavaSparkContext(sparkConf);

    // 生成一个测试rdd数据集
    JavaRDD<Integer> rdd1 = jsc.parallelize(Arrays.asList(1, 2, 3, 4, 5));

    // 过滤数据,用大于2的数据组成一个新的rdd
    JavaRDD<Integer> rdd2 = rdd1.filter(v1 -> v1 > 2);

    List<Integer> list = rdd2.collect();

    list.forEach(integer -> System.out.println(integer));

    jsc.stop();
}
结果输出3,4,5
flatMap
与map类似,区别是原RDD中的元素经map处理后只能生成一个元素,而原RDD中的元素经flatmap处
理后可生成多个元素来构建新RDD。 举例:对原RDD中的每个元素x产生y个元素(从1到y,y为元素x
的值)
连贯操作中变量返回迭代器Iterator<Object>
    @Test
    public void testFlatMap() {
        SparkConf sparkConf = new SparkConf()
                .setAppName("RddOperation")
                .setMaster("local[*]");
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);
        // 生成RDD
        JavaRDD<String> rdd = jsc.parallelize(Arrays.asList("hello world","hello spark"));
        // 数据压扁操作
        JavaRDD<String> rdd2 = rdd.flatMap(s -> Arrays.asList(s.split(" ")).iterator());

        //收集数据
        List<String> list = rdd2.collect();
        for (String o : list) {
            System.out.println(o);
        }
    }
结果是
hello
spark
hello
world
mapPartitions
mapPartitions是map的一个变种。map的输入函数是应用于RDD中每个元素,而mapPartitions的输
入函数是应用于每个分区,也就是把每个分区中的内容作为整体来处理的。
将一个数据集合分成若干个区
连贯操作中变量返回迭代器Iterator<Object>
    @Test
    public void testMapPartitions (){
        SparkConf sparkConf = new SparkConf()
                .setAppName("RddOperation")
                .setMaster("local[*]");
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);
        // 生成RDD,分3个区存储
        JavaRDD<Integer> rdd = jsc.parallelize(Arrays.asList(1,2,3,4,5,6,7,8,9,10),3);
        // 分区操作数据
        JavaRDD<Integer> rdd2 = rdd.mapPartitions(integerIterator -> {
            List<Integer> result = new ArrayList<>();
            while (integerIterator.hasNext()){
                Integer i = integerIterator.next();
                result.add(i);
            }
            System.out.println("分区数据:" + result);
            return result.iterator();
        });

        //收集数据
        List<Integer> list = rdd2.collect();
        list.forEach(integer ->  System.out.println(integer));
    }
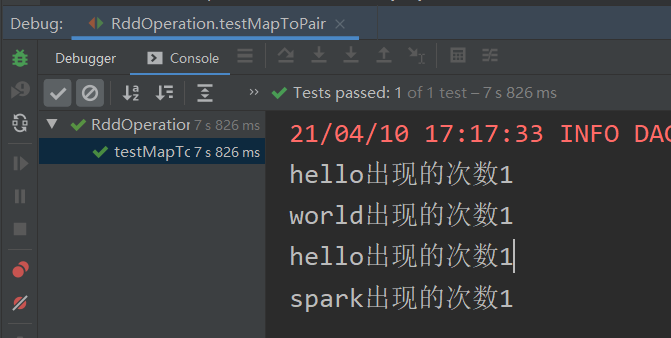
结果如下所示
mapToPair
此函数会对一个RDD中的每个元素调用f函数,其中原来RDD中的每一个元素都是T类型的,调用f函数
后会进行一定的操作把每个元素都转换成一个<K2,V2>类型的对象
连贯操作返回的变量的数据类型是new Tuple<Object,Object>
    @Test
    public void testMapToPair (){
        SparkConf sparkConf = new SparkConf()
                .setAppName("RddOperation")
                .setMaster("local[*]");
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);
        // 生成RDD
        JavaRDD<String> rdd = jsc.parallelize(Arrays.asList("hello world","hello spark"));

        // 按照空格分割
        JavaRDD<String> rdd1 = rdd.flatMap(s -> Arrays.asList(s.split(" ")).iterator());

        // 把每一个单词的出现数量标记为1
        JavaPairRDD<Object, Object> rdd2 = rdd1.mapToPair(s -> new Tuple2<>(s, 1));

        //收集数据
        List<Tuple2<Object, Object>> list = rdd2.collect();
        for (Tuple2<Object, Object> o : list) {
            System.out.println(o);
        }
    }
reduceByKey
顾名思义,reduceByKey就是对元素为KV对的RDD中Key相同的元素的Value进行reduce,因此,Key
相同的多个元素的值被reduce为一个值,然后与原RDD中的Key组成一个新的KV对。
    @Test
    public void testReduceByKey (){
        SparkConf sparkConf = new SparkConf()
                .setAppName("RddOperation")
                .setMaster("local[*]");
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);
        // 生成RDD
        JavaRDD<String> rdd = jsc.parallelize(Arrays.asList("hello world","hello spark"));

        // 按照空格分割
        JavaRDD<String> rdd1 = rdd.flatMap(s -> Arrays.asList(s.split(" ")).iterator());

        // 把每一个单词的出现数量标记为1
        JavaPairRDD<Object, Integer> rdd2 = rdd1.mapToPair(s -> new Tuple2<>(s, 1));

        // 按照key相同的数进行相加操作
        JavaPairRDD<Object, Integer> rdd3 = rdd2.reduceByKey((v1, v2) -> v1 + v2);

        //收集数据
        List<Tuple2<Object, Integer>> list = rdd3.collect();
        for (Tuple2<Object, Integer> o : list) {
            System.out.println(o);
        }
    }
结果是
coalesce
该函数用于将RDD进行重分区,使用HashPartitioner。第一个参数为重分区的数目,第二个为是否进
行shuffle,默认为false;
    @Test
    public void testCoalesce (){
        SparkConf sparkConf = new SparkConf()
                .setAppName("RddOperation")
                .setMaster("local[*]");
        JavaSparkContext jsc = new JavaSparkContext(sparkConf);
        // 生成RDD
        JavaRDD<Integer> rdd = jsc.parallelize(Arrays.asList(1,2,3,4,5,6,7,8,9,10));

        System.out.println(rdd.getNumPartitions()); //4
        // 重新分区,shuffle:是否重新分配存储,如果分区数大于原有分区数,就需要设置为true
        JavaRDD<Integer> rdd2 = rdd.coalesce(6, true);
        System.out.println(rdd2.getNumPartitions()); //2

        //收集数据
        List<Integer> list = rdd2.collect();
        for (Integer o : list) {
            System.out.println(o);
        }
    }
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论