动手学pytorch——线性回归
文章目录
线性回归
内容:
- 线性回归的基本要素
- 线性回归模型从零开始的实现
- 线性回归模型使用pytorch的简洁实现
线性回归的基本要素
模型
为了简单起见,这里我们假设价格只取决于房屋状况的两个因素,即面积(平方米)和房龄(年)。接下来我们希望探索价格与这两个因素的具体关系。线性回归假设输出与各个输入之间是线性关系: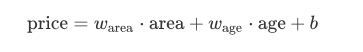
数据集
我们通常收集一系列的真实数据,例如多栋房屋的真实售出价格和它们对应的面积和房龄。我们希望在这个数据上面寻找模型参数来使模型的预测价格与真实价格的误差最小。在机器学习术语里,该数据集被称为训练数据集(training data set)或训练集(training set),一栋房屋被称为一个样本(sample),其真实售出价格叫作标签(label),用来预测标签的两个因素叫作特征(feature)。特征用来表征样本的特点。
损失函数
在模型训练中,我们需要衡量价格预测值与真实值之间的误差。通常我们会选取一个非负数作为误差,且数值越小表示误差越小。一个常用的选择是平方函数。 它在评估索引为i的样本误差的表达式为
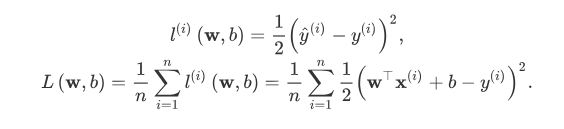
优化函数 - 随机梯度下降
当模型和损失函数形式较为简单时,上面的误差最小化问题的解可以直接用公式表达出来。这类解叫作解析解(analytical solution)。本节使用的线性回归和平方误差刚好属于这个范畴。然而,大多数深度学习模型并没有解析解,只能通过优化算法有限次迭代模型参数来尽可能降低损失函数的值。这类解叫作数值解(numerical solution)。
在求数值解的优化算法中,小批量随机梯度下降(mini-batch stochastic gradient descent)在深度学习中被广泛使用。它的算法很简单:先选取一组模型参数的初始值,如随机选取;接下来对参数进行多次迭代,使每次迭代都可能降低损失函数的值。在每次迭代中,先随机均匀采样一个由固定数目训练数据样本所组成的小批量(mini-batch)B,然后求小批量中数据样本的平均损失有关模型参数的导数(梯度),最后用此结果与预先设定的一个正数的乘积作为模型参数在本次迭代的减小量。
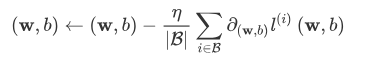
学习率:η代表在每次优化中,能够学习的步长的大小
批量大小:B是小批量计算中的批量大小batch size
总结一下,优化函数的有以下两个步骤:
- (i)初始化模型参数,一般来说使用随机初始化;
- (ii)我们在数据上迭代多次,通过在负梯度方向移动参数来更新每个参数。
线性回归模型从零开始的实现
%matplotlib inline
import torch
from IPython import display
from matplotlib import pyplot as plt
import numpy as np
import random

print(torch.__version__)

**#生成数据集,使用线性模型来生成数据集,
#生成一个1000个样本的数据集,下面是用来生成数据的线性关系:**

# set input feature number
num_inputs = 2
# set example number
num_examples = 1000

# set true weight and bias in order to generate corresponded label
true_w = [2, -3.4]
true_b = 4.2

features = torch.randn(num_examples, num_inputs,
                      dtype=torch.float32)
 #torch.randn=()函数说明,正态分布生成 num_examples*num_inputs个张量,dtype为float32类型

#(torch.randn(*sizes, out=None, dtype=None, layout=torch.strided, device=None, requires_grad=False) -> Tensor
labels = true_w[0] * features[:, 0] + true_w[1] * features[:, 1] + true_b#生成预测标签值
labels += torch.tensor(np.random.normal(0, 0.01, size=labels.size()),
                       dtype=torch.float32)#加上(0,0.01)的标准正态分布的高斯白噪声干扰

#使用图像来展示生成的数据
plt.scatter(features[:, 1].numpy(), labels.numpy(), 1);


#读取数据集
def data_iter(batch_size, features, labels):
    num_examples = len(features)
    indices = list(range(num_examples))#随机化序号
    random.shuffle(indices)   #random read 10 samples

    for i in range(0, num_examples, batch_size):
        j = torch.LongTensor(indices[i: min(i + batch_size, num_examples)])  #the last time may be not enough for a whole batch
        yield  features.index_select(0, j), labels.index_select(0, j)
 #torch.index_select(a,0/1,tensor[a,b]) 第一个参数代表索引的对象,第二个参数代表0为行索引,1为列索引,第三个参数tensor里面为索引的序号。

 batch_size = 10
for X, y in data_iter(batch_size, features, labels):
    print(X, '\n', y)
    break

# 初始化模型参数
w = torch.tensor(np.random.normal(0, 0.01, (num_inputs, 1)), dtype=torch.float32)#标准正态分布生成(0,0.01)的(num_inputs*1)的特征张量作为参数,与之前的真实特征值作为对比
b = torch.zeros(1, dtype=torch.float32)

w.requires_grad_(requires_grad=True)#表示允许对w反向求导
b.requires_grad_(requires_grad=True)
定义模型
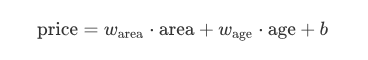
def linreg(X, w, b):
    return torch.mm(X, w) + b  #torch.mm为矩阵乘法,torch.mul(a, b)是矩阵a和b对应位相乘,a和b的维度必须相等,比如a的维度是(1, 2),b的维度是(1, 2),返回的仍是(1, 2)的矩阵,
    #torch.mm(a, b)是矩阵a和b矩阵相乘,比如a的维度是(1, 2),b的维度是(2, 3),返回的就是(1, 3)的矩阵
定义损失函数

def squared_loss(y_hat, y):
    return (y_hat - y.view(yhat.size())) ** 2 / 2 #y.view(yhat.size(),-1)把原先多维张量变为一维的张量,不管尺寸如何,其中-1为自适应
定义优化函数
def sgd(params, lr, batch_size):
    for param in params:
        param.data -= lr * param.grad  batch_size # ues .data to operate param without gradient track
训练
当数据集、模型、损失函数和优化函数定义完了之后就可来准备进行模型的训练了。
# super parameters init
lr = 0.03
num_epochs = 5

net = linreg    #线性模型
loss = squared_loss #平方损失函数

# training
for epoch in range(num_epochs):  # training repeats num_epochs times
    # in each epoch, all the samples in dataset will be used once

    # X is the feature and y is the label of a batch sample
    for X, y in data_iter(batch_size, features, labels):
        l = loss(net(X, w, b), y).sum()#公式推导可以理解为求一个样本的损失,这里是求一个批次的损失,经过net(X, w, b)后得到的是一个batch\_size\*1的向量,得到的损失也是一个batch\_size\*1向量,需要将其表示为一个数值来表示这个batch的损失,所以后面多了一个sum(),用一个批次的损失的和来表示这个批次的损失值
        # calculate the gradient of batch sample loss
        l.backward()
        # using small batch random gradient descent to iter model parameters
        sgd([w, b], lr, batch_size)
        # reset parameter gradient
        w.grad.data.zero_() #防止(w,b)梯度累加,计算一次梯度,更新一次网络
        b.grad.data.zero_()
    train_l = loss(net(features, w, b), labels)#训练好的w,b与真实标签值进行对比
    print('epoch %d, loss %f' % (epoch + 1, train_l.mean().item())) #格式化输出

w, true_w, b, true_b
训练的结果:其中用了2000个训练样本
总结:
本视频用了许多pytorch的函数,由于不是太了解pytorch内的函数,因此查询记录了一下。
torch.ones()/torch.zeros(),与MATLAB的ones/zeros很接近。初始化生成
均匀分布
torch.rand(*sizes, out=None) → Tensor
返回一个张量,包含了从区间[0, 1)的均匀分布中抽取的一组随机数。张量的形状由参数sizes定义。
标准正态分布
torch.randn(*sizes, out=None) → Tensor
返回一个张量,包含了从标准正态分布(均值为0,方差为1,即高斯白噪声)中抽取的一组随机数。张量的形状由参数sizes定义。
torch.mul(a, b)是矩阵a和b对应位相乘,a和b的维度必须相等,比如a的维度是(1, 2),b的维度是(1, 2),返回的仍是(1, 2)的矩阵
torch.mm(a, b)是矩阵a和b矩阵相乘,比如a的维度是(1, 2),b的维度是(2, 3),返回的就是(1, 3)的矩阵
torch.Tensor是一种包含单一数据类型元素的多维矩阵,定义了7种CPU tensor和8种GPU tensor类型。
random.shuffle(a):用于将一个列表中的元素打乱。shuffle() 是不能直接访问的,需要导入 random 模块,然后通过 random 静态对象调用该方法。
backward()是pytorch中提供的函数,配套有require_grad:
1.所有的tensor都有.requires_grad属性,可以设置这个属性.x = tensor.ones(2,4,requires_grad=True)
2.如果想改变这个属性,就调用tensor.requires_grad_()方法: x.requires_grad_(False
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论