交封不杀!——python获取bilibli视频封面
文章目录
昨晚终于提交了该死的31条CPU,今天十节课翘了八节,躺在宿舍睡觉,不幸遇到几百年难得一见的点名……然而当时我在吃炸鸡,没法(懒)赶过去,达成“第一次翘课就点名”。
心情郁结的我打算看一看漂亮小姐姐开心一下,于是我发现了这个视频:
据说是Rose韩国站的站姐飞去美国科切拉音乐节现场拍摄的视频。因为四个站只有Rose的站姐去了,所以视频、高清图都非常珍稀。
于是我对up主说:
交封不杀!
但是显然up主并不care我的留言,气。
求人不如求己,打开开发者工具:
……我瞎了……
老年人还是要放大字体啊。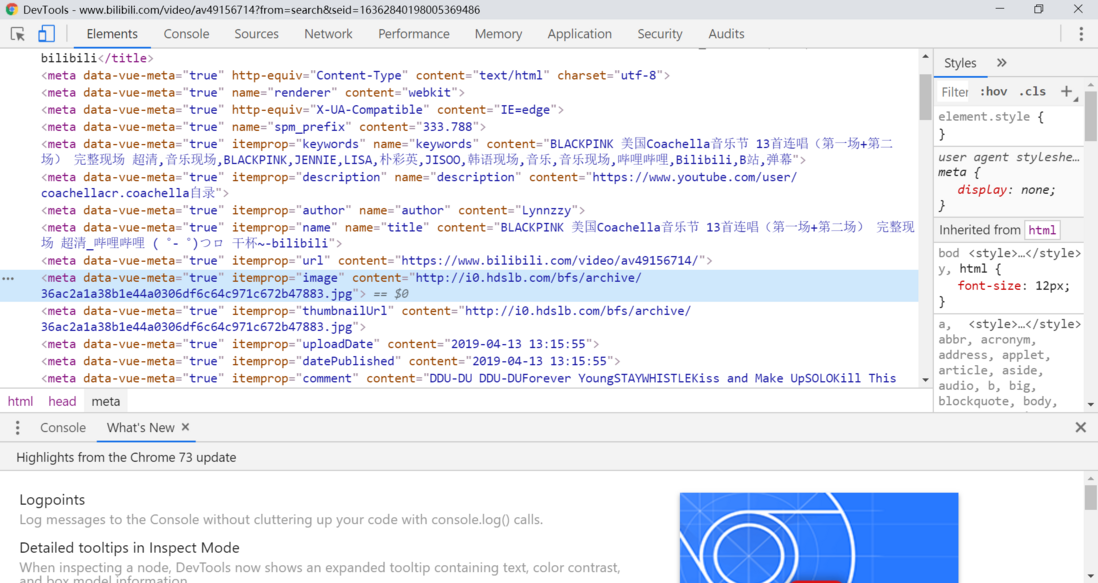
看我找到了什么?
哈哈哈哈哈哈哈哈哈
复制链接打开: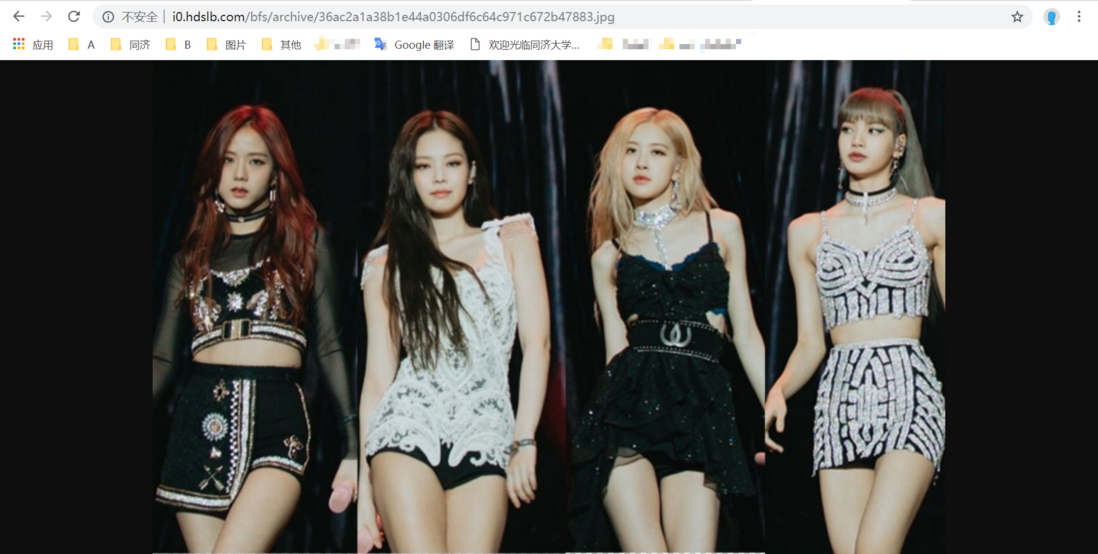
555为什么会有这么漂亮的小姐姐!!我爱了!!
但是后面我又发现了更多想要封面的视频: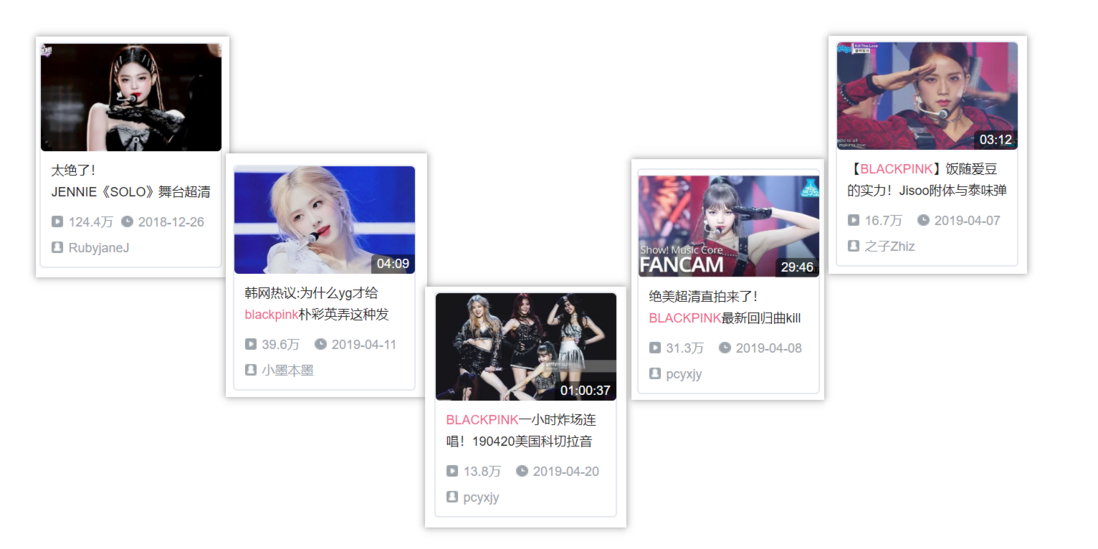
一个一个找我怕不是要累死……
想到“一个木函”这个app之前有获取B站封面的功能,但是后来用不了了。
那我就自己写一个!
(非常激动,毕竟我只会用python写hello world)
工具:pycharm(不得不说这东西的logo真丑);
功能:输入av号,生成封面图片链接;
环境:python3.7
思路:输入av号,到相应的网址,打开开发者界面,找到并返回图片链接。
那就开始吧!
刚刚那个视频的链接是:
结构是https://www.bilibili.com/ + video + av号。
that's easy.
def getcover():
    avnum=input("please input the av number of your video:")
    url="https://www.bilibili.com/video/av"+avnum
emmmm,下面该怎么做?
哦对!下面找图片的链接!
可以看出来,只要找到
itemprop="image"
content="https://balabala.jpg"
就能确定图片地址。
index1=text.find('itemprop=\"image\"')+len('itemprop=\"image\" content=\"')
index2=text.find('\"',index1)
cover=text[index1:index2]
print(cover)
作为一个不会python的人,我能写出这段真是感天动地了。
(我在网上找到好多教python爬虫的文章,可是他们写的都好长好复杂……然后看到一个爬取京东商品信息的,从里面抠出来这一段……)
anyway,运行!
咦,出错了。
我又回头看那个爬京东的程序……
哦!我没加head。
headers={
    'Host':'www.bilibili.com',
    'User-Agent': 'Chrome/73.0.3683.103'
}
再运行……
还是错。wtf。
我又回头看那个爬京东的程序……
哦!我好像被反爬虫发现了!
text=requests.get(url,headers=headers).text#解决反爬虫问题
这下可以了吧?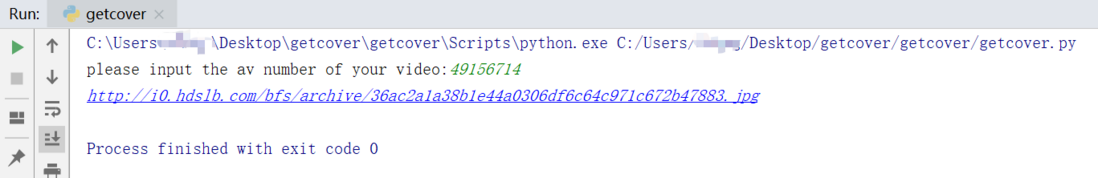
直接点开链接看一下?
没错,火狐才是我的默认浏览器
perfect!
终于不用再说“交封不杀”了。
下面附上源代码:
import re
import requests

def getcover():
    avnum=input("please input the av number of your video:")
    url="https://www.bilibili.com/video/av"+avnum
    headers={
        'Host':'www.bilibili.com',
        'User-Agent': 'Chrome/73.0.3683.103'
    }
    text=requests.get(url,headers=headers).text#解决反爬虫问题
    index1=text.find('itemprop=\"image\"')+len('itemprop=\"image\" content=\"')
    index2=text.find('\"',index1)
    cover=text[index1:index2]
    print(cover)

getcover()
最后,记录一下一些“意想不到的bug”。
正常的不会python的人的bug:
ModuleNotFoundError: No module named 'requests'
上网找这个bug的原因,都显示因为没有安装这个package。
ok,那装。
顺便升级了一下pip
但是还是同样的报错。
找啊找找啊找,终于看到有人说,或许是因为“没有安装到同一目录”。
what???谁和谁没有安装到同一目录???
但是!我突然想到,第一次用的时候输入任何代码都报错,因为我没把python放到interpreter里。
打开project interpreter,发现果然没有requests。
那就手动install一下: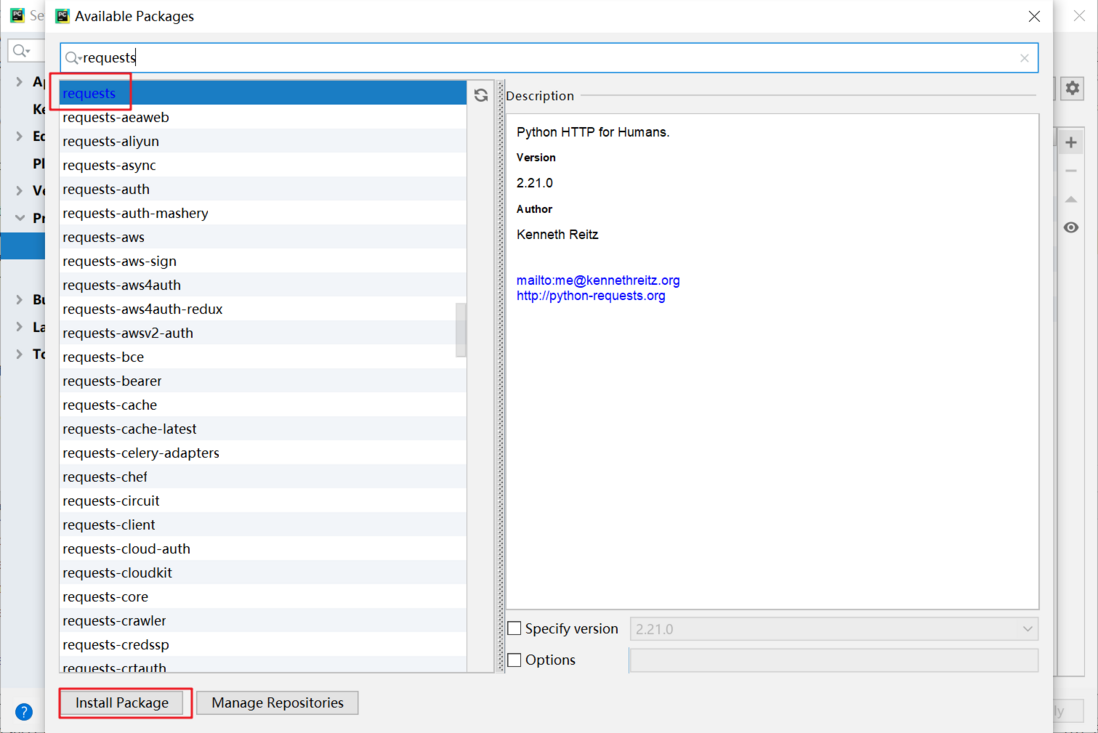

perfect!
不正常的bug:
python语句结尾不要加分号!!!
不要加分号!!!
不要加分号!!!
python的注释是#不是// !!!
python的注释是#不是// !!!
python的注释是#不是// !!!
That's all.
最后,python和C++真的是太不一样了。
python可以引用的东西非常多,很多东西都不需要自己写。
但是其实也差不多,不过相比之下,python的可读性更好一点。
btw我还是懒得学orz
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论