从时间序列ariam模型到Prophet模型的应用
文章目录
所遇问题
前两个星期,我的一个朋友(任职于上海的一家数据公司的机器学习岗位)在工作中有一个华为手机各价位销售趋势预测的项目,需要用到时间序列,找到我一起做一下协助。数据是2016年12月-2019年12月的脱敏数据,拿到的数据很简单,我们的思路是按照价格段来分组,根据不同的价格段用前三年的数据划分训练集和测试集,预测2020年前6个月的趋势走向。但是遇到的问题是数据中2017年整个6月份的数据是缺失的,各年的3月,5月,11月分别有零散缺失。其中每年份中6月18日,11月11日,12月12日等特殊日期的峰值特别的高。
了解完数据的特点,我首先想到的是用时间序列里的arima模型,把2017年1月,2018年1月的数据作为训练集,2019年1月的数据作为测试集,跑入模型,预测2020年1月的数据,同理用2017年2月,2018年2月的数据作为训练集,2019年2月的数据作为测试集,预测2020年2月的数据,用这个思路分别来预测2020年1月,2月,3月,4月,5月,6月的数据,抛开缺失不谈,这种思路预测效果偏差很大,直接原因是因为训练数据量太少。第二种做法是直接把三年的数据全放进去,按七三比例拆分成训练集和测试集,利用步长差分消除季节性去跑模型,一起预测出2020年前六个月的数据。但是arima模型不能很好的解决2017年6月份缺失的数据,针对节假日数据也没办法很好的控制,我们采取的方法是把属于6月18日,11月11日,12月12日等购物节假日的数据剔除,零散缺失值用-1填充,但是最后结果也是不尽人意。
探索新方法
通过查找资料和交流,最终确定了处理时间序列的另外一种非常实用的模型Prophet模型。Prophet模型可以很好的解决异常的节假日级别的数据,在这里使数据和代码简单的介绍一下Prophet模型的使用。
Prophet 遵循 sklearn 库建模的应用程序接口。我们创建了一个 Prophet 类的实例,其中使用了“拟合模型” fit 和“预测” predict 方法。
# Python
import pandas as pd
import numpy as np
from fbprophet import Prophet
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")
data = pd.read_csv('原版市场价格段.csv',encoding='gbk')
data['y'] = np.log(data['1200元~2400元'])
data['ds'] = data['时间']
df = data[['ds','y']]
df
# 拟合模型
m = Prophet()
m.fit(df)
# 构建待预测日期数据框,periods = 365 代表除历史数据的日期外再往后推 365 天
future = m.make_future_dataframe(periods=365)
future.tail()
# 预测数据集
forecast = m.predict(future)
forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail()
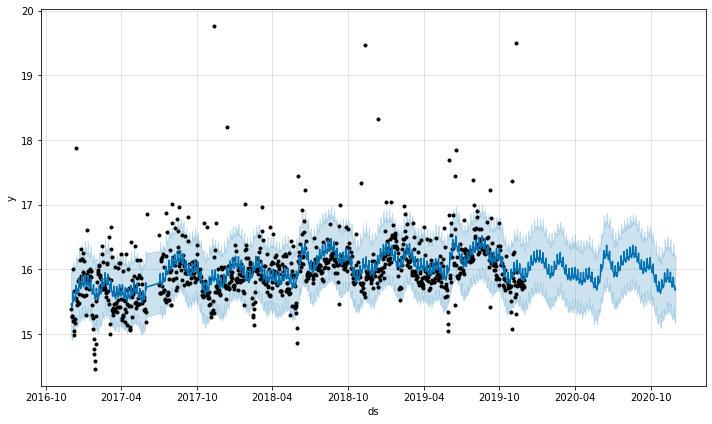
# 展示预测结果
m.plot(forecast)
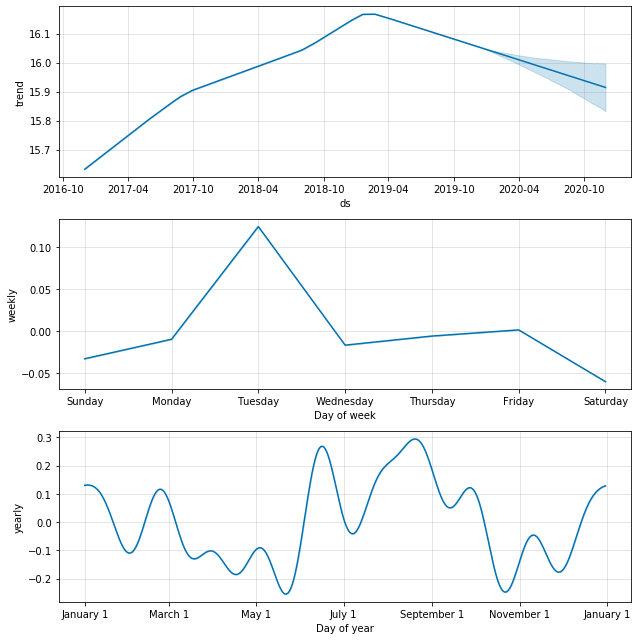
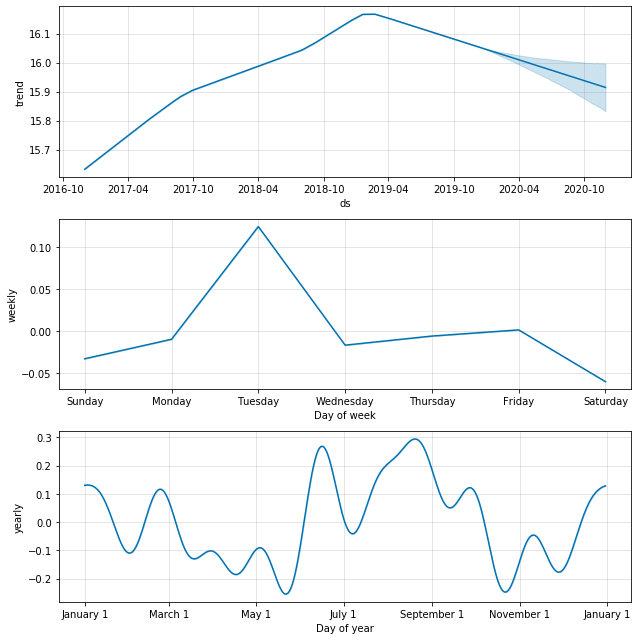
# 预测的成分分析绘图,展示预测中的趋势、周效应和年度效应
m.plot_components(forecast)
forecast[['ds','yhat_1']]
forecast['y1'] = data['1200元~2400元']
forecast[['ds','yhat_1','y1']].describe(percentiles= [0.1,0.9,0.95,0.99,0.999])
forecast.loc[forecast['y1'] > 3.492611e+07,'y1'] = 8.811842e+06
forecast[['ds', 'yhat']]
forecast['yhat_1'] = np.exp(forecast[ 'yhat'])
forecast[['ds', 'yhat','yhat_1']]
plt.figure(figsize=(15,6))
plt.plot(forecast['ds'],forecast[['yhat_1','y1']])
# plt.xticks(np.arange(57)[0::6], train.时间[0::6])
plt.xticks(np.arange(57)[0::12], train.时间[0::12],rotation=90)
plt.xlabel('时间')
plt.ylabel('1200元~2400元')
plt.title('手机1200元~2400元价格段')
plt.show()
饱和预测
data = pd.read_csv('原版市场价格段.csv',encoding='gbk')
data['y'] = np.log(data['1200元~2400元'])
data['ds'] = data['时间']
df = data[['ds','y']]
df['cap'] = 1.5
df
m = Prophet(growth='logistic')
m.fit(df)
future = m.make_future_dataframe(periods=365)
future['cap'] = 1.5
fcst = m.predict(future)
fig = m.plot(fcst)
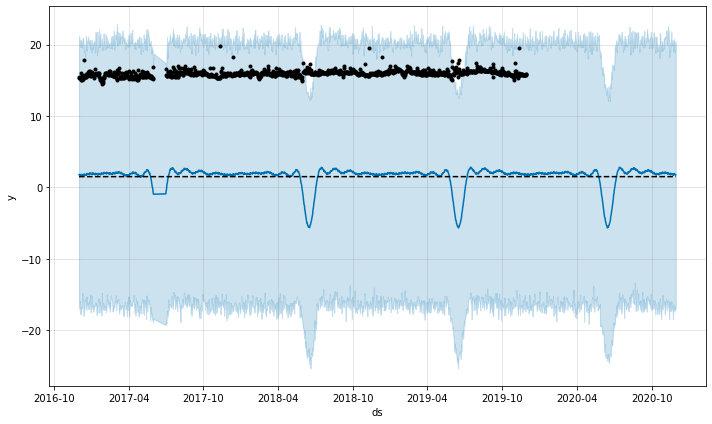
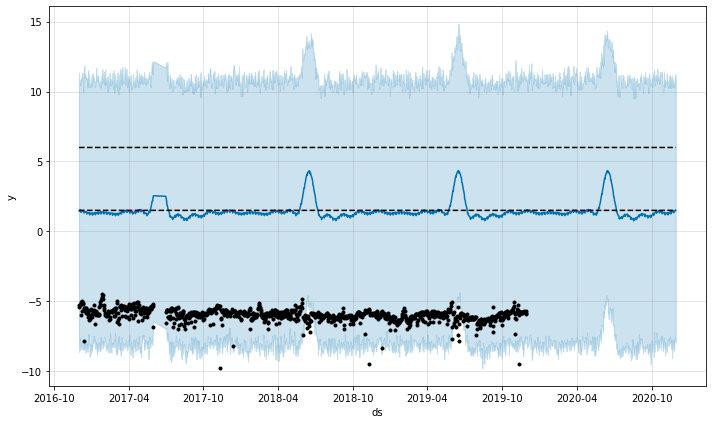
df['y'] = 10 - df['y']
df['cap'] = 6
df['floor'] = 1.5
future['cap'] = 6
future['floor'] = 1.5
m = Prophet(growth='logistic')
m.fit(df)
fcst = m.predict(future)
fig = m.plot(fcst)
趋势突变点
在之前的部分,我们可以发现真实的时间序列数据往往在趋势中存在一些突变点。默认情况下, Prophet 将自动监测到这些点,并对趋势做适当地调整。不过,要是对趋势建模时发生了一些问题,例如:Prophet 不小心忽略了一个趋势速率的变化或者对历史数据趋势变化存在过拟合现象。如果我们希望对趋势的调整过程做更好地控制的话,那么下面将会介绍几种可以使用的方法。
Prophet 中的自动监测突变点
data = pd.read_csv('原版市场价格段.csv',encoding='gbk')
data['y'] = np.log(data['1200元~2400元'])
data['ds'] = data['时间']
df = data[['ds','y']]
# 拟合模型
m = Prophet()
m.fit(df)
# 构建待预测日期数据框,periods = 365 代表除历史数据的日期外再往后推 365 天
future = m.make_future_dataframe(periods=365)
future.tail()
# 预测数据集
forecast = m.predict(future)
forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail()
from fbprophet.plot import add_changepoints_to_plot
fig = m.plot(forecast)
a = add_changepoints_to_plot(fig.gca(), m, forecast)

调整趋势的灵活性
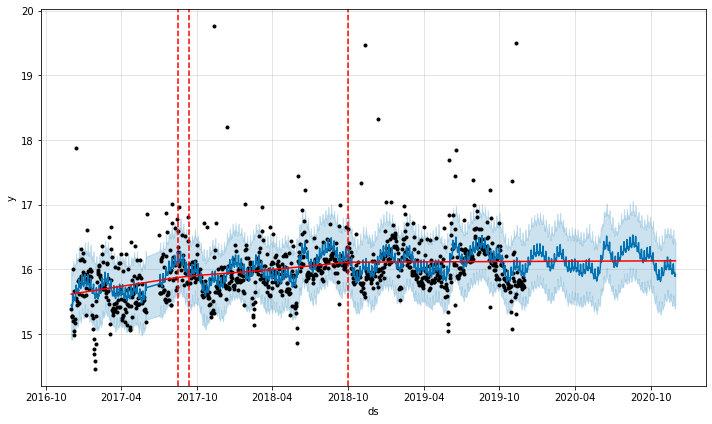
如果趋势的变化被过度拟合(即过于灵活)或者拟合不足(即灵活性不够),可以利用输入参数 changepoint_prior_scale 来调整稀疏先验的程度。默认下,这个参数被指定为 0.05 。增加这个值,会导致趋势拟合得更加灵活。代码和图如下所示:
data = pd.read_csv('原版市场价格段.csv',encoding='gbk')
data['y'] = np.log(data['1200元~2400元'])
data['ds'] = data['时间']
df = data[['ds','y']]
# 拟合模型
m = Prophet(changepoint_prior_scale=0.5)
m.fit(df)
# 构建待预测日期数据框,periods = 365 代表除历史数据的日期外再往后推 365 天
future = m.make_future_dataframe(periods=365)
forecast = m.predict(future)
fig = m.plot(forecast)
指定突变点的位置
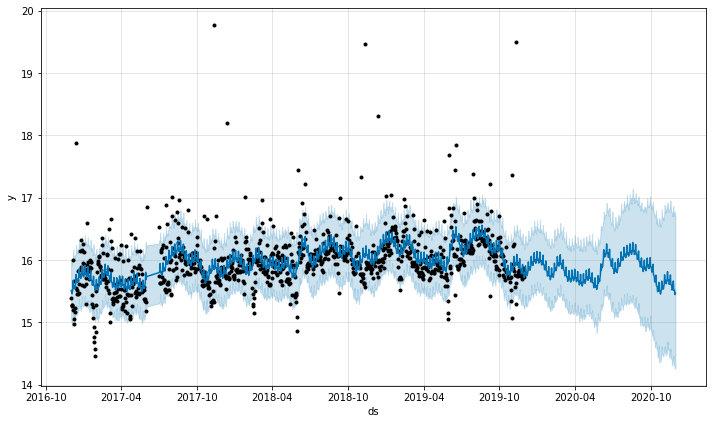
如果你希望手动指定潜在突变点的位置而不是利用自动的突变点监测,可以使用 changepoints 参数。
m = Prophet(changepoints=['2017-06-18', '2017-11-11', '2017-12-12' ])
m.fit(df)
future = m.make_future_dataframe(periods=365)
forecast = m.predict(future)
m.plot(forecast)

季节性,假期效果和回归量
对假期和特征事件建模
playoffs = pd.DataFrame({
'holiday': 'playoff',
'ds': pd.to_datetime(['2016-12-12','2017-06-18', '2017-11-11', '2017-12-12',
'2018-06-18', '2018-11-11', '2018-12-12',
'2019-06-18', '2019-11-11', '2019-12-12',
'2020-06-18', '2020-11-11', '2020-12-12']),
'lower_window': 0,
'upper_window': 1,
})
superbowls = pd.DataFrame({
'holiday': 'superbowl',
'ds': pd.to_datetime(['2017-11-11', '2018-11-11', '2019-11-11', '2020-11-11']),
'lower_window': 0,
'upper_window': 1,
})
holidays = pd.concat((playoffs, superbowls))
m = Prophet(changepoint_prior_scale=0.005,holidays=holidays,yearly_seasonality=80)
m.fit(df)
future = m.make_future_dataframe(periods=365)
forecast = m.predict(future)
# 可通过 forecast 数据框,来展示节假日效应:
# 看一下假期的最后10行数据
forecast[(forecast['playoff'] + forecast['superbowl']).abs() > 0][
['ds', 'playoff', 'superbowl']][-10:]
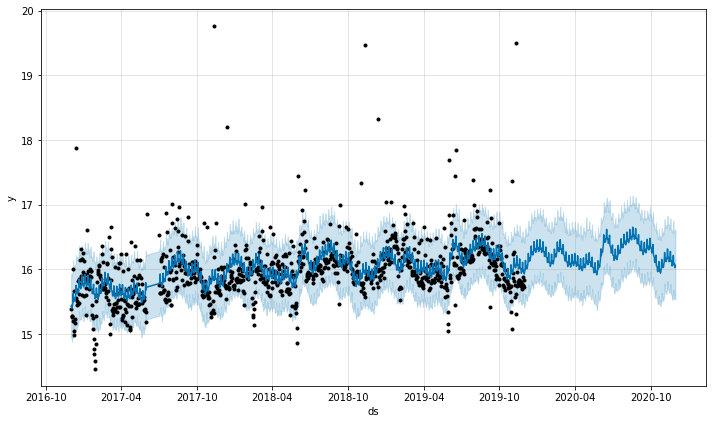
# 在成分分析的图中,如下所示,也可以看到节假日效应。我们可以发现,在节日日期附近有一个穿透,而在超级碗日期时穿透则更为明显。
fig = m.plot_components(forecast)
m.plot(forecast)
forecast['y'] = df['y']
forecast[['ds', 'yhat']]
forecast[['ds', 'yhat','y']]
plt.figure(figsize=(15,6))
plt.plot(forecast['ds'],forecast[['yhat','y']])
# plt.xticks(np.arange(57)[0::6], train.时间[0::6])
plt.xticks(np.arange(57)[0::12], train.时间[0::12],rotation=90)
plt.xlabel('时间')
plt.ylabel('1200元~2400元')
plt.title('手机1200元~2400元价格段')
plt.show()
季节性的傅里叶级数
季节性是用部分傅里叶和估计的。有关完整的细节,请参阅论文,以及维基百科上的这个图,以说明部分傅里叶和如何近似于一个线性周期信号。部分和(order)中的项数是一个参数,它决定了季节性的变化有多快。为了说明这一点, 我们仍似乎用第一部分中佩顿 · 曼宁的数据。每年季节性的默认傅立叶级数是10,这就产生了这样的拟合:
from fbprophet.plot import plot_yearly
m = Prophet().fit(df)
a = plot_yearly(m)

默认值10通常是合适的,但是当季节性需要适应更高频率的变化时,它们可以增加,并且通常不那么平滑。在实例化模型时,可以为每个内置季节性指定傅立叶级数,这里增加到20:
from fbprophet.plot import plot_yearly
m = Prophet(yearly_seasonality=20).fit(df)
a = plot_yearly(m)
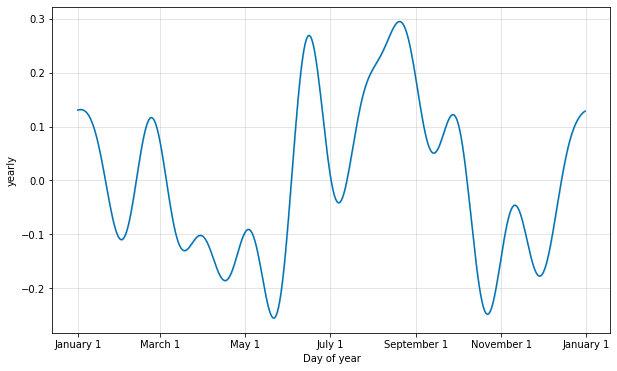
可以看到,曲线更加的多变了。增加傅立叶项的数量可以使季节性适应更快的变化周期,但也可能导致过度拟合:N个傅立叶项对应于用于建模周期的2N个变量。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论