效果如图:
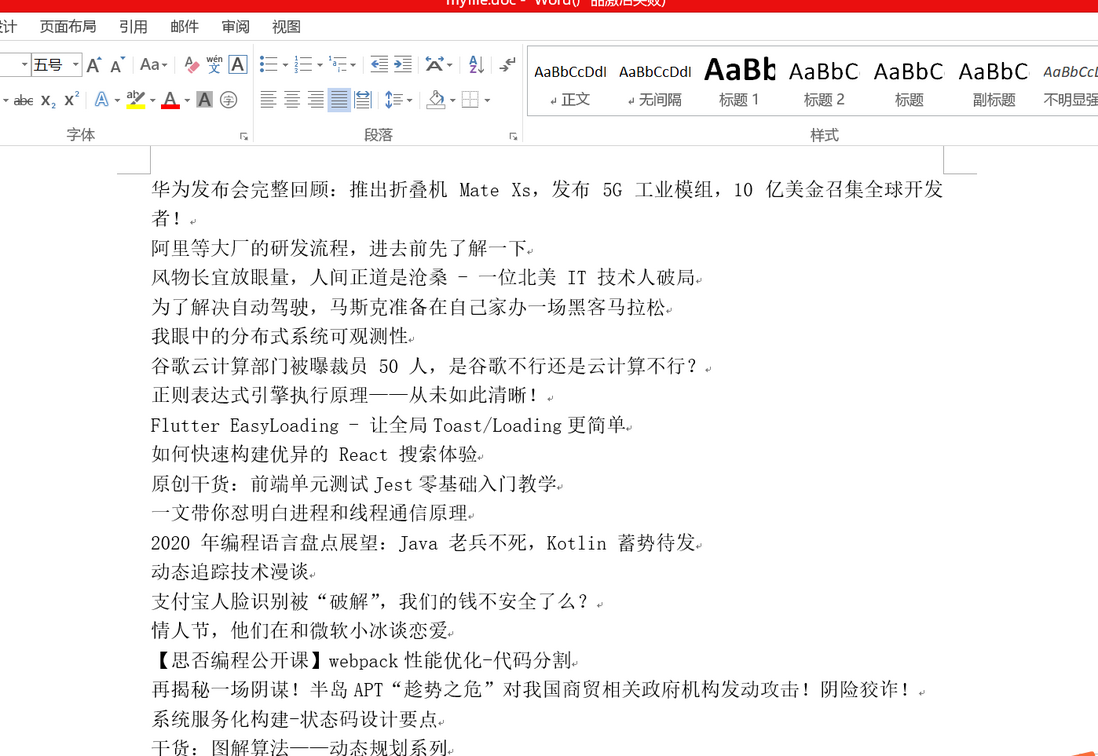
代码如下:
# 从urllib库中引入request模块
from urllib import request
# 从bs4库中引入BeautifulSoup模块
from bs4 import BeautifulSoup
# 设置要爬取的网址
url = r'https://segmentfault.com/'
# 设置模拟浏览器外衣
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
# 添加头部header,让服务器以为你是浏览器
page = request.Request(url, headers=headers)
# 请求网址,获取请求结果,解码格式为utf-8
page_info = request.urlopen(page).read().decode('utf-8')
# 使用BeautifulSoup网页解析库
soup = BeautifulSoup(page_info, 'html.parser')
# 查找全部的<h4 class="news__item-title"></h4>标签
titles = soup.find_all('h4', 'news__item-title')
try:
    # 在D盘创建一个名为 myfile的 word文件
    # w+   打开一个文件用于读写。如果该文件已存在则打开文件,
    # 并从开头开始编辑,即原有内容会被删除。如果该文件不存在,创建新文件。
    file = open(r'D:\myfile.doc', 'w+')
    for title in titles:
        # 将标签里面的内容写入文件中
        file.write(title.string + '\n')
finally:
    if file:
        # 关闭文件
        file.close()
# try..finally...语句可以用with语句替换,更简洁
# with open(r'D:myfile2.doc','w+') as file:
#    for title in titles:
#        file.write(title.string+'\n')
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论