JVM字节码文件结构说明

文章目录
.class字节码文件结构
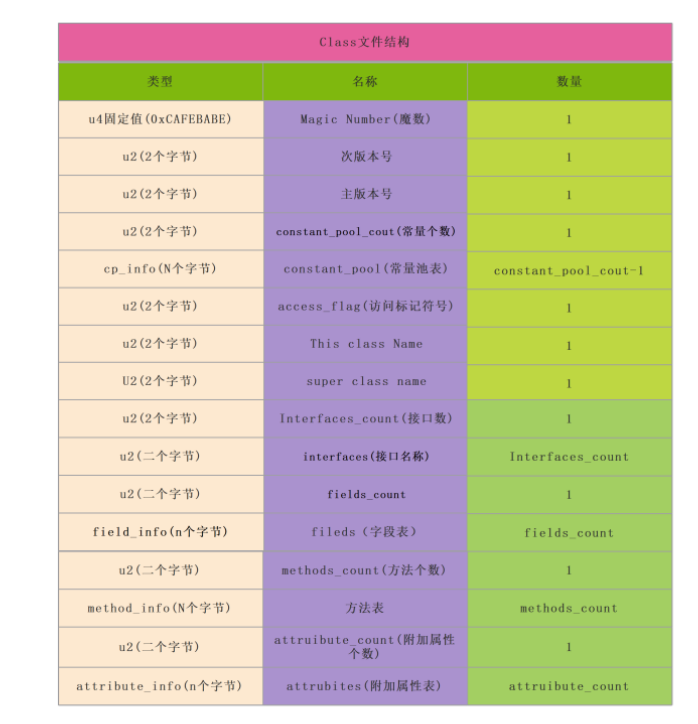
魔数: 文件的开头的 四个字节 是固定 值位 0xCAFEBABE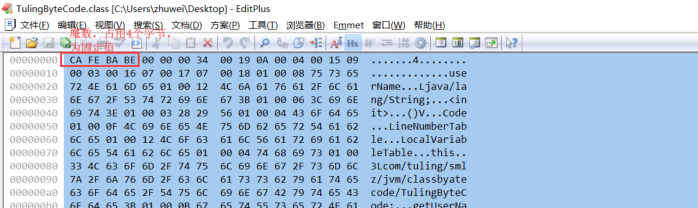
次版本号( minor version ):二个字节00 00 表示jdk的次版本号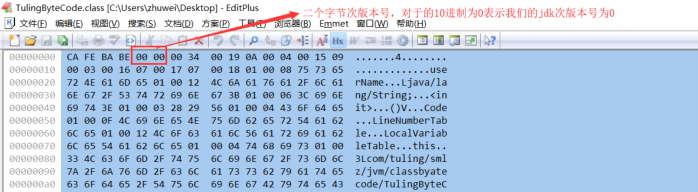
主版本号( major version ):二个字节 00 34 表示为jdk的主版本号,34对于10
进制为52
那么52代表的是1.8,51代表的是1.7 等等一直类推下去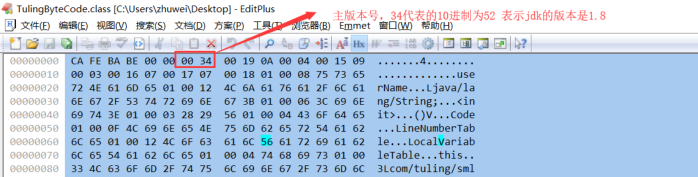
所以通过主次版本号来确定我们jdk的版本是1.8.0
常量池入口,占用二个字节,表示常量池中的个数=00 19 (25)-1=24个, 为啥
需要-1,因为常量池中的第0个位置被我们的jvm占用了表示为null 所以我们通过
编译出来的常量池索引是从1开始的.
Constant pool:
2  #1 = Methodref #4.#21 // java/lang/Object."<init>":()V
3  #2 = Fieldref #3.#22 // com/tuling/smlz/jvm/classbyatecode/TulingByteCode.u
serName:Ljava/lang/String;
4  #3 = Class #23 // com/tuling/smlz/jvm/classbyatecode/TulingByteCode
5  #4 = Class #24 // java/lang/Object
6  #5 = Utf8 userName
7  #6 = Utf8 Ljava/lang/String;
8  #7 = Utf8 <init>
9  #8 = Utf8 ()V
10  #9 = Utf8 Code
11  #10 = Utf8 LineNumberTable
12  #11 = Utf8 LocalVariableTable
13  #12 = Utf8 this
14  #13 = Utf8 Lcom/tuling/smlz/jvm/classbyatecode/TulingByteCode;
15  #14 = Utf8 getUserName
16  #15 = Utf8 ()Ljava/lang/String;
17  #16 = Utf8 setUserName
18  #17 = Utf8 (Ljava/lang/String;)V
19  #18 = Utf8 MethodParameters
20  #19 = Utf8 SourceFile
21  #20 = Utf8 TulingByteCode.java
22  #21 = NameAndType #7:#8 // "<init>":()V
23  #22 = NameAndType #5:#6 // userName:Ljava/lang/String;
24  #23 = Utf8 com/tuling/smlz/jvm/classbyatecode/TulingByteCode
25  #24 = Utf8 java/lang/Object
常量池结构
u1,u2,u4,u8分别代表1个字节,2个字节,4个字节,8个字节的无符号数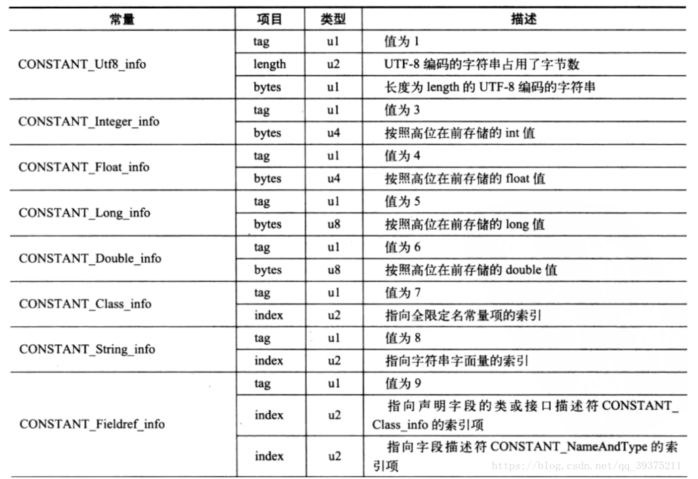
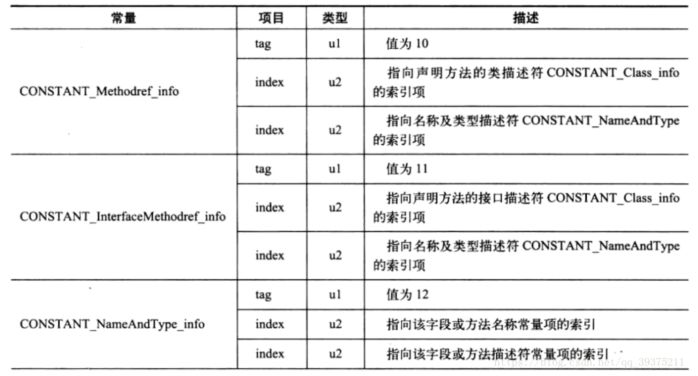
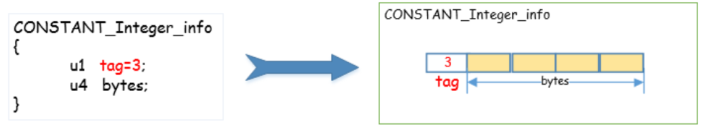
不同常量对应的字节码结构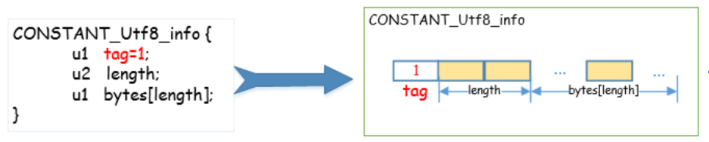
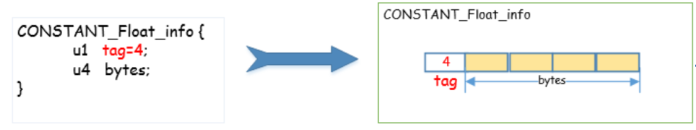


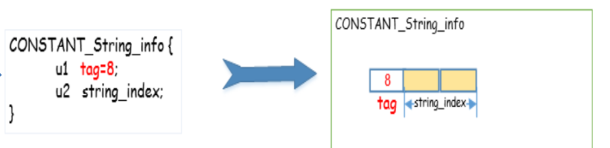
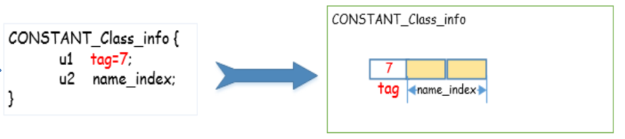
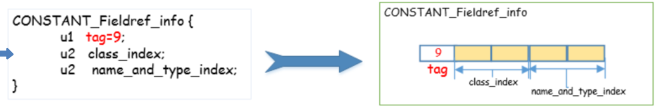
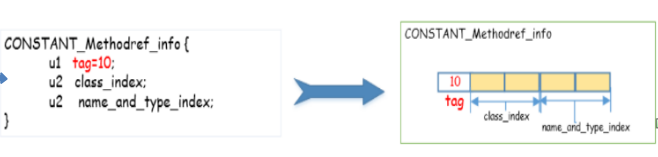
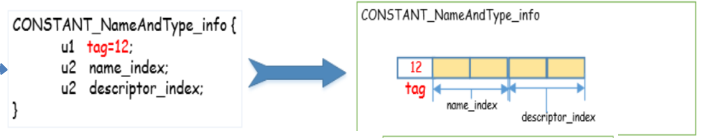
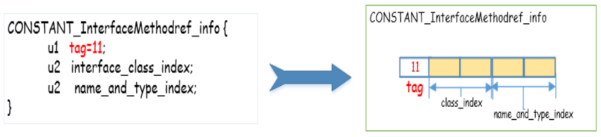
我们的常量池可以看作我们的java class类的一个资源仓库(比如Java类定的
方法和变量信息),我们后面的方法 类的信息的描述信息都是通过索引去常量池中获
取。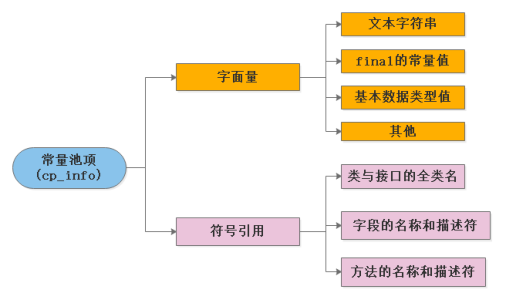
class文件结构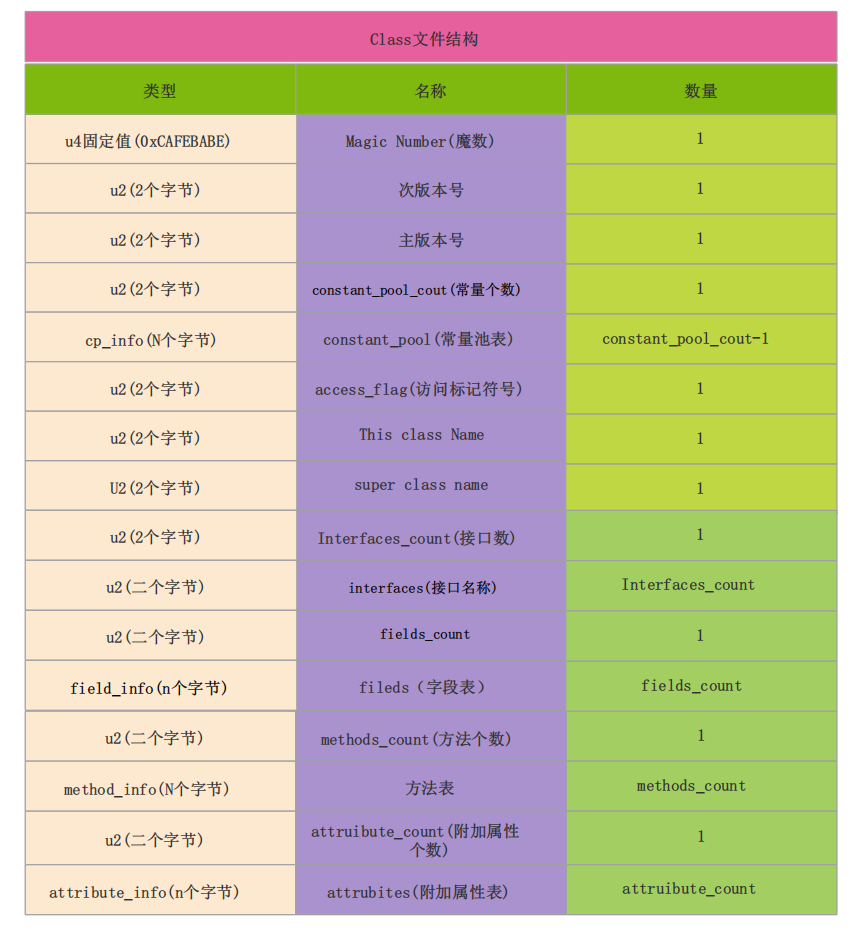
类的访问权限查询手册
字段表结构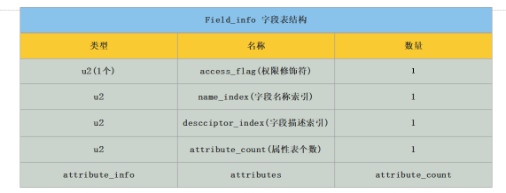
方法表中的属性表attribute_info结构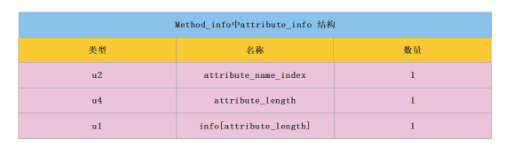
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论