Hadoop中重新格式化namenode

文章目录
题记:
Hadoop在我放下很久以后,再次拿起来。
使用
bin/start-all.sh
命令启动hadoop集群,死活不见namenode节点。在解决这个问题的时候,又不断的引出了很多新的问题。
虽然这些问题在以前学习hadoop时都解决过。但,正因为以前解决过,现在遇到这些问题就更不想重复解决了。想要以最快的速度启动集群。最后想了一个馊主意。直接格式化namenode吧。
进入正题:
hadoop中重新格式化namenode
因为之前正常启动过hadoop集群。所以在hadoop的对应data目录中,已经有很多相关文件夹了。我们在格式化之前得先删除相关文件夹才行。
一、对于master主节点进行操作
1、删除data、name、namesecondary三个文件夹。

2、删除mrlocal目录中的四个文件夹
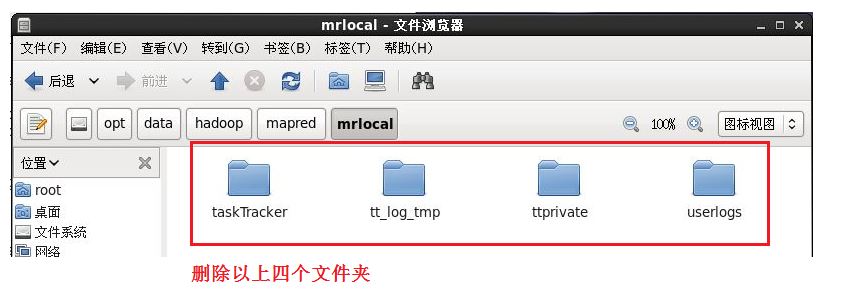
3、删除logs文件夹中的所有文件

二、对于node节点进行操作
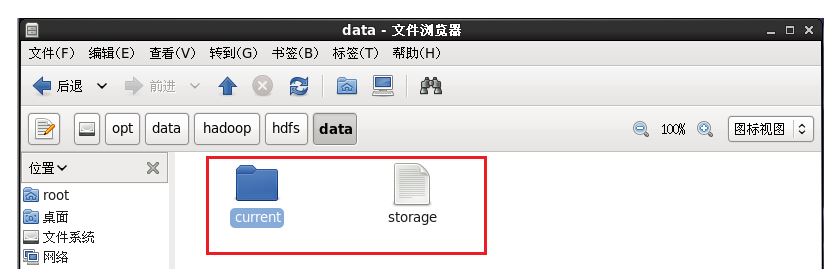
1、删除hdfs/data中的所有文件
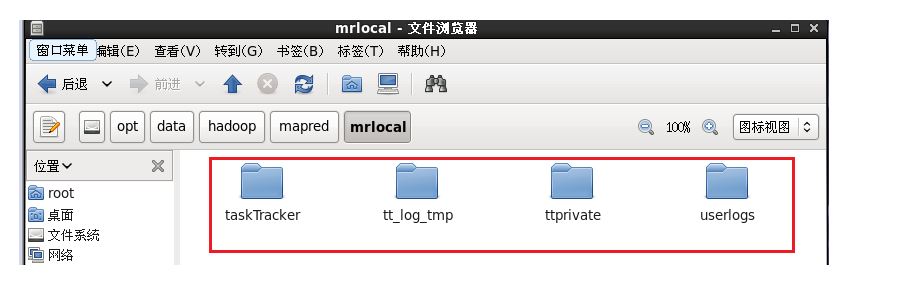
2、删除mrlocal中的所有文件
3、删除logs中所有文件
基本删除完成后。开始重新格式化namenode
三、格式化namenode
[hadoop@master hadoop]$ bin/hadoop namenode -format
格式化成功后。重新启动集群
四、重新启动集群
[hadoop@master hadoop]$ bin/start-all.sh
五、查看集群启动情况
[hadoop@master hadoop]$ jps
3851 Jps
3744 TaskTracker
3622 JobTracker
3279 NameNode
3533 SecondaryNameNode
3395 DataNode
如看到
[hadoop@master hadoop]$ jps
3851 Jps
3744 TaskTracker
3622 JobTracker
3279 NameNode
3533 SecondaryNameNode
3395 DataNode
则代表启动成功。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论