Machine Learning 中的逻辑回归
文章目录
感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
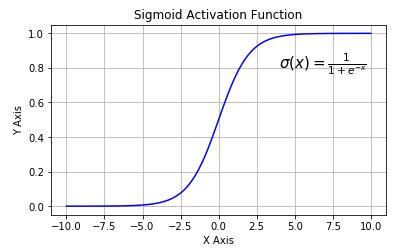
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。

读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()

我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)

第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的感谢平台分享-http://bjbsair.com/2020-04-10...
@Author:Runsen
什么是逻辑回归
回想一下线性回归,它被用于确定一个连续因变量的值。逻辑回归通常用于分类目的。与线性回归不同,因变量只能采用有限数量的值,即因变量是分类的。当可能结果的数量只有两个时,它被称为二元逻辑回归。
从大的类别上来说,逻辑回归是一种有监督的统计学习方法,主要用于对样本进行分类。
逻辑回归与线性回归的关系
逻辑回归也被称为广义线性回归模型,它与线性回归模型的形式基本上相同,都具有 ax+b,其中a和b是待求参数,其区别在于他们的因变量不同,多重线性回归直接将ax+b作为因变量,即y = ax+b,而logistic回归则通过函数S将ax+b对应到一个隐状态p,p = S(ax+b),然后根据p与1-p的大小决定因变量的值。这里的函数S就是Sigmoid函数,就是因为这个函数的使用才能分类
该函数具有如下的特性:当x趋近于负无穷时,y趋近于0;当x趋近于正无穷时,y趋近于1;当x= 0时,y=0.5.
假设现在有一个函数 y = ax1 +b x2 +c*x3 +b x1,x2,x3 带入sigmoid函数中 得到y 如果大于0.5,分类为1,小于0.5,分类为0
德国信用卡欺诈数据集
欧洲的信用卡持卡人在2013年9月2天时间里的284807笔交易数据,其中有492笔交易是欺诈交易,占比0.172%。数据采用PCA变换映射为V1,V2,...,V28 数值型属性,只有交易时间和金额这两个变量没有经过PCA变换。输出变量为二值变量,1为正常,0为欺诈交易。
读取excel文件
data = pd.read_csv("../credit-a.csv", header=None)
data.head()
我们可以从图上可以看到有15个特征,一个分类结果 相当于y = a1x1 +…… +a15 x15 +b
逻辑回归和分类数据集
from sklearn.model_selection import train_test_split
from sklearn.linear_model.logistic import  LogisticRegression
将x 作为特征数据,y作为分类结果,因为输出变量为二值变量,1为正常,0为欺诈交易,而我这是-1代表欺诈和交易,所以用replace方法把-1,变为0
x = data[data.columns[:-1]] #
y = data[data.columns[15]].replace(-1,0)
将x和y分为训练集和测试集
x_train,x_test,y_train,y_test = train_test_split(x,y)
len(x_train),len(x_test)
OUT:
(489, 164)
和线性回归一样的操作
model = LogisticRegression()  #用逻辑回归建立模型
model.fit(x_train,y_train)  #fit 和predict
model.predict(x_test)
OUT:
array([1, 1, 1, 1, 0, 0, 0, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0,
       0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0,
       0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 0,
       0, 0, 0, 1, 1, 1, 1, 1, 0, 1, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 0,
       0, 0, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 1, 0,
       1, 1, 0, 1, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0,
       0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 1, 1, 0,
       1, 0, 0, 1, 0, 1, 1, 0, 1, 1], dtype=int64)
       #这里有164个结果
predict_proba 方法可以得到概率(Sigmoid的x和y)
model.predict_proba(x_test)
第一个数[1.42575343e-02, 9.85742466e-01] 也就是x = 0.014, y=0.9>0.5 分类结果为1
对于精确性如何,导入accuracy_score
from sklearn.metrics import accuracy_score
accuracy_score(model.predict(x_test), y_test)
OUT:
0.8719512195121951
也就是在168个测试样本中168*0.8719512195121951个是正确的
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论