MongoDB 聚合函数

文章目录
概念
聚合函数是对一组值执行计算并返回单一的值
主要的聚合函数
count
distinct
Group
MapReduce
1、count
db.users.count()
db.users.count({"uname":"hxf1"})
db.users.count({"salary":{"$gt":15000} })
db.users.find({"salary":{"$gt":15000}}).count()
find和count同时存在,只有find的条件起作用
2、distinct
db.users.distinct("uname")
db.runCommand({"distinct":"users","key":"uname"})
在数据量很大的时候,使用这种方法查询时,查询的结果集大于16M 时会查询失败,失败信息如下:
比如要对名字字段name进行distinct
db.XX.distinct('imsi')
报错如下:
[main] Error: distinct failed: {
"ok" : 0,
"errmsg" : "distinct too big, 16mb cap",
"code" : 17217,
"codeName" : "Location17217"
} :
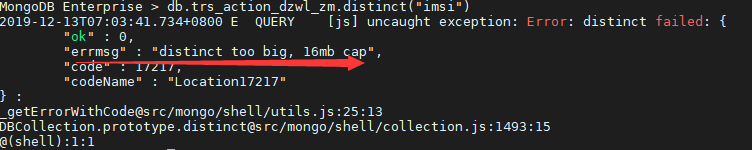
解决办法:改成用聚合方式
db.XX.aggregate([{$group:{_id:{'imsi':"$imsi"},count:{$sum:1}}}], { allowDiskUse: true})
3、group
按关键字排序,然后逐条计算(reduce)
db.runCommand({ "group":
... {"ns":"users", //集合
... "key":{"uuid":true,"uname":true}, //分组的条件
... "initial":{"num":0} , //初始化变量,在每一个分组计算时进行
... "$reduce":function(doc,prev){ //逐条文档用reduce处理
... if(doc.uuid>prev.uuid){ // 新的分组开始,因为排好序,所以直接用>
... prev.uuid=doc.uuid;
... prev.uname=doc.uname;
... prev.num =doc.num ;
... }else{ //当前文档和上一个文档相等,在一个分组内进行计算
... prev.num=prev.num+1} } ,
... "condition":{"uname":{"$nin":[null]}} //条件,和find的一样
...} })
4、MapReduce
概述
Map-Reduce是一种计算模型,简单的说就是将大批量的数据分解(MAP)执行,然后再将结果合并成最终结果(REDUCE)。
优点
它的好处是可以把一个聚合任务分解为多个小的任务,分配到多服务器上并行处理。MongoDB也提供了MapReduce,当然查询语肯定是JavaScript。
阶段
Map:使用emit函数向MapReduce提供Key/Value对。
Shuffle: 根据Key分组对文档,并且为每个不同的Key生成一系列(>=1个)的值表(List of values)。
Reduce: Key,emits. Key即为emit函数中的Key。 emits是一个数组,它的元素就是emit函数提供的Value。Reduce函数返回结果必须与emits中元素结构一致
Finalize:此步骤不是必须的。在得到MR最终结果后,再进行一些数据“修剪”性质的处理
Map或者Reduce函数中的this关键字,代表当前被Mapping文档。
语法
命令1
db.collection.mapReduce(
function() {emit(key,value);}, //map 函数
function(key,values) {return reduceFunction}, //reduce 函数
{
out: collection,
query: document,
sort: document,
limit: number
}
)
参数说明:
map :映射函数 (生成键值对序列,作为 reduce 函数参数)。
reduce 统计函数,reduce函数的任务就是将key-values变成key-value,也就是把values数组变成一个单一的值value。。
out 统计结果存放集合 (不指定则使用临时集合,在客户端断开后自动删除)。
query 一个筛选条件,只有满足条件的文档才会调用map函数。(query。limit,sort可以随意组合)
sort 和limit结合的sort排序参数(也是在发往map函数前给文档排序),可以优化分组机制
limit 发往map函数的文档数量的上限(要是没有limit,单独使用sort的用处不大)
命令1相关实例
db.posts.find({},{"_id":0})
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "mark", "status" : "active" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "mark", "status" : "active" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "mark", "status" : "active" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "mark", "status" : "active" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "mark", "status" : "disabled" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "runoob", "status" : "disabled" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "runoob", "status" : "disabled" }
{ "post_text" : "菜鸟教程,最全的技术文档。", "user_name" : "runoob", "status" : "active" }
db.posts.mapReduce(
function() { emit(this.user_name,1); },
function(key, values) {return Array.sum(values)},
{
query:{status:"active"},
out:"post_total"
}
)
db.post_total.find()
{ "_id" : "mark", "value" : 4 }
{ "_id" : "runoob", "value" : 1 }
{
"result" : "post_total", // 储存结果的collection的名字
"timeMillis" : 23, //执行花费的时间,毫秒为单位
"counts" : {
"input" : 5, //满足条件被发送到map函数的文档个数
"emit" : 5, //在map函数中emit被调用的次数,也就是所有集合中的数据总量
"reduce" : 1, //在map函数中emit被调用的次数,也就是所有集合中的数据总量
"output" : 2 //结果集合中的文档个数
},
"ok" : 1 //是否成功,成功为1
}
命令2
db.runCommand({
mapreduce:,
map:,
reduce:,
[,query:]
[,sort:<sorts the input objects using this key.Useful for optimization,like sorting by the emit key for fewer reduces>]
[,limit:]
[,out:]
[,keeptemp:<true|false>]
[,finalize:]
[,scope:
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论