DataX -- 整体的执行流程
文章目录
整体的执行流程包括preHandle、init、prepare、split、schedule、post、postHandle、invokeHooks、destroy、logStatistics。
preHandle
需要设置job.preHandler.pluginType和job.preHandler.pluginName,前者是PluginType枚举里的值,包括READER、TRANSFORMER、WRITER、HANDLER,后者是插件名称,通过这两个值就可以找到对应的插件(这个过程在上篇讲过了),并执行preHandler方法。

init
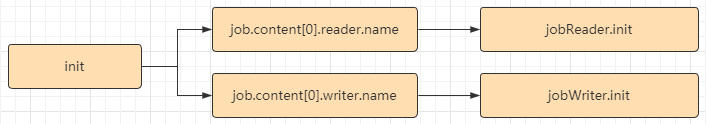
init主要是加载Reader.Job和Writer.Job两个插件,加载后会调用Reader.Job和Writer.Job对应的init方法。
比如HdfsReader和HdfsWriter,用于校验必填项、数据的合法性,初始化org.apache.hadoop.conf.Configuration。
比如MysqlReader,处理where条件、校验username、password是否有配置,数据库是否可以连接,表是否存在等。
prepare
调用Reader.Job和Writer.Job对应的prepare方法。
比如HdfsReader用来获取指定路径列表下符合条件的所有文件的绝对路径。
比如MysqlWriter,单表的时候执行presql。

split
调用Reader.Job和Writer.Job对应的split方法,对reader和writer进行切分,并且reader和writer是1:1的关系。
比如MysqlReader,就会根据主键进行切分。
比如HdfsReader,就会根据文件数进行切分。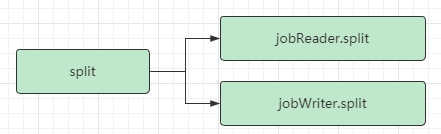
切分后,还会重新生成job.content,里面是一个Configuration的List集合,每个Configuration都对应着reader和writer的信息。
schedule
任务调度的地方,这个后面开个章节来讲。
post
调用Reader.Job和Writer.Job对应的post方法。
比如MysqlWriter,单表情况下执行postSql语句。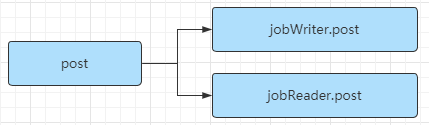
postHandle
需要设置job.postHandler.pluginType和job.postHandler.pluginName,前者是PluginType枚举里的值,包括READER、TRANSFORMER、WRITER、HANDLER,后者是插件名称,通过这两个值就可以找到对应的插件,并执行postHandle方法。

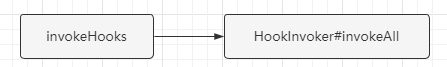
invokeHooks
主要是调用外部hook。
destroy
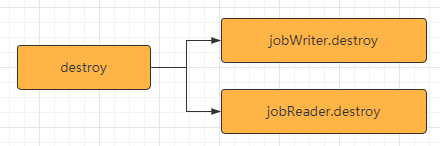
调用Reader.Job和Writer.Job对应的destroy方法。
logStatistics
用于打印结果。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论