缓存原理与微服务缓存自动管理

文章目录
抛开业务谈技术都是在耍流氓。—— Kevin Wan
为什么需要缓存?
先从一个老生常谈的问题开始谈起:我们的程序是如何运行起来的?
- 程序存储在
disk中 - 程序是运行在
RAM之中,也就是我们所说的main memory - 程序的计算逻辑在
CPU中执行
来看一个最简单的例子:a = a + 1
load x:x0 = x0 + 1load x0 -> RAM
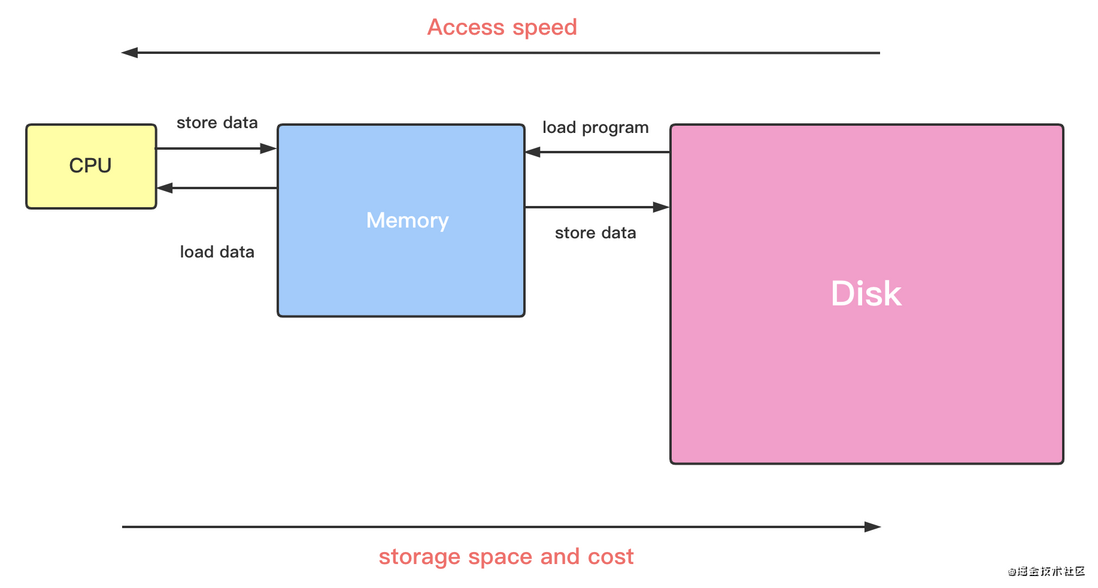
上面提到了3种存储介质。我们都知道,三类的读写速度和成本成反比,所以我们在克服速度问题上需要引入一个 中间层。这个中间层,需要高速存取的速度,但是成本可接受。于是乎,Cache 被引入
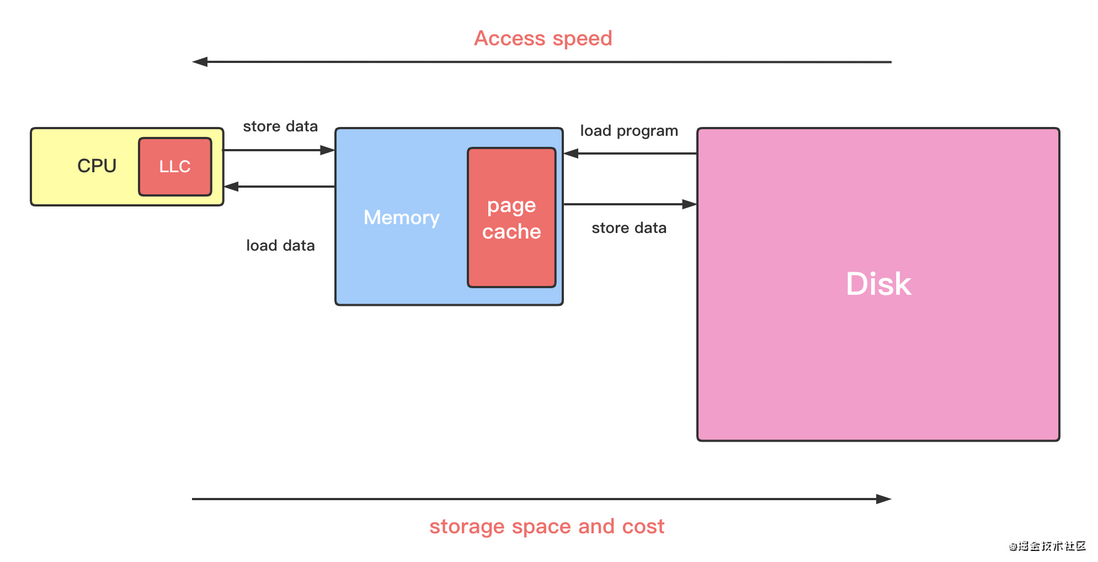
而在计算机系统中,有两种默认缓存:
- CPU 里面的末级缓存,即
LLC。缓存内存中的数据 - 内存中的高速页缓存,即
page cache。缓存磁盘中的数据
缓存读写策略
引入 Cache 之后,我们继续来看看操作缓存会发生什么。因为存在存取速度的差异「而且差异很大」,从而在操作数据时,延迟或程序失败等都会导致缓存和实际存储层数据不一致。
我们就以标准的 Cache+DB 来看看经典读写策略和应用场景。
Cache Aside
先来考虑一种最简单的业务场景,比如用户表:userId:用户id, phone:用户电话token,avtoar:用户头像url,缓存中我们用 phone 作为key存储用户头像。当用户修改头像url该如何做?
- 更新
DB数据,再更新Cache数据 - 更新
DB数据,再删除Cache数据
首先 变更数据库 和 变更缓存 是两个独立的操作,而我们并没有对操作做任何的并发控制。那么当两个线程并发更新它们的时候,就会因为写入顺序的不同造成数据不一致。
所以更好的方案是 2:
- 更新数据时不更新缓存,而是直接删除缓存
- 后续的请求发现缓存缺失,回去查询
DB,并将结果load cache
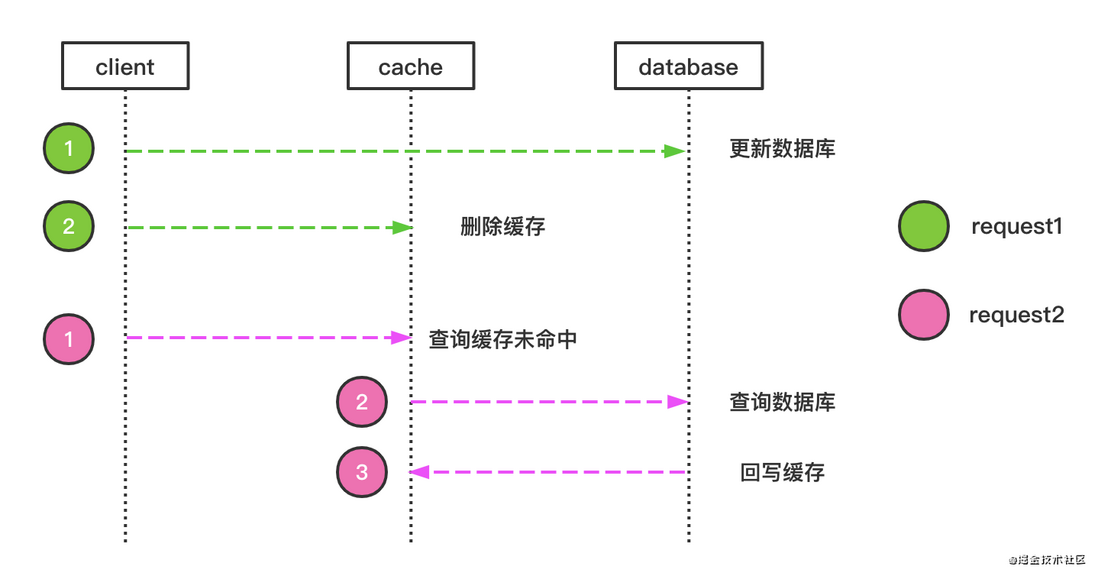
这个策略就是我们使用缓存最常见的策略:Cache Aside。这个策略数据以数据库中的数据为准,缓存中的数据是按需加载的,分为读策略和写策略。
但是可见的问题也就出现了:频繁的读写操作会导致 Cache 反复地替换,缓存命中率降低。当然如果在业务中对命中率有监控报警时,可以考虑以下方案:
- 更新数据时同时更新缓存,但是在更新缓存前加一个 分布式锁。这样同一时间只有一个线程操作缓存,解决了并发问题。同时在后续读请求中时读到最新的缓存,解决了不一致的问题。
- 更新数据时同时更新缓存,但是给缓存一个较短的
TTL。
当然除了这个策略,在计算机体系还有其他几种经典的缓存策略,它们
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论