scrapy-redis 架构,Scrapy 和 scrapy-redis 的区别
文章目录
一、scrapy-redis 架构
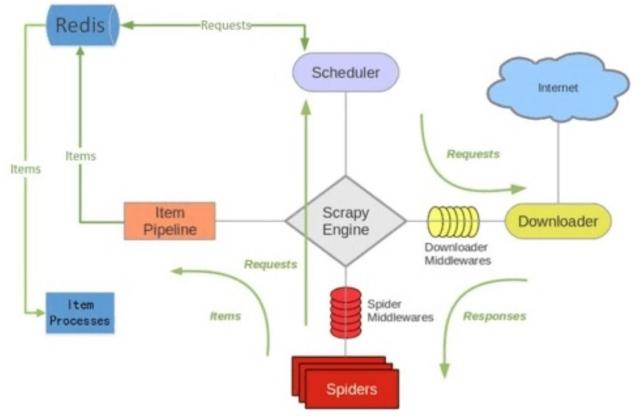
如上图所示示,scrapy-redis 在 scrapy 的架构上增加了 redis,基于 redis 的特性拓展了如下组件:
1、Scheduler :
Scrapy 改造了 python 本来的 collection.deque(双向队列)形成了⾃⼰的Scrapy
queue(https://github.com/scrapy/que...
,但是 Scrapy 多个 spider 不能共享待爬取队列 Scrapy queue, 即 Scrapy 本 身不⽀持爬⾍分布式,scrapy-redis 的解决是把这个 Scrapy queue 换成 redis数 据库(也是指 redis 队列),从同⼀个 redis-server 存放要爬取的 request, 便 能让多个 spider 去同⼀个数据库⾥读取。
Scrapy 中跟“待爬队列”直接相关的就是调度器 Scheduler ,它负责对新的request 进⾏⼊列操作(加⼊Scrapy queue),取出下⼀个要爬取的 request(从 Scrapy queue 中取出)等操作。它把待爬队列按照优先级建⽴了⼀个字典结构,⽐如:
{
优先级 0 : 队列
0 优先级 1 : 队 列 1 优先级 2 :
队列 2 }
然后根据 request 中的优先级,来决定该⼊哪个队列,出列时则按优先级较⼩的优先出列。为了管理这个⽐较⾼级的队列字典,Scheduler 需要提供⼀系列 的⽅法。但是原来的 Scheduler 已经⽆法使⽤,所以使⽤Scrapy-redis 的scheduler 组件。
2、Duplication Filter
Scrapy 中⽤集合实现这个 request 去重功能,Scrapy 中把已经发送的 request指纹放⼊到⼀个集合中,把下⼀个 request 的指纹拿到集合中⽐对,如果该指纹存在于集合中,说明这个 request 发送过了,如果没有则继续操作。这个核⼼的判重功能是这样实现的:
def request_seen(self, request): # self.request_figerprints 就是⼀个指纹集合
fp = self.request_fingerprint(request)
# 这就是判重的核⼼操作
if fp in self.fingerprints:
return True
self.fingerprints.add(fp)
if self.file:
self.file.write(fp + os.linesep)

#获取全套python爬虫学习教程请访问:https://item.taobao.com/item.htm?spm=a2oq0.12575281.0.0.4ace1deb9UZJB5&ft=t&id=619117901939
在 scrapy-redis 中去重是由 Duplication Filter 组件来实现的,它通过 redis的 set 不重复的特性,巧妙的实现了 Duplication Filter 去重。scrapy-redis 调 度 器从引擎接受 request,将 request 的指纹存⼊redis 的 set 检查是否重复,并将 不重复的 request push 写⼊redis 的 request queue。
引擎请求 request(Spider 发出的)时,调度器从 redis 的 request queue 队列⾥根据优先级 pop 出⼀个 request 返回给引擎,引擎将此 request 发给spider 处 理。
3、Item Pipeline
引擎将(Spider 返回的)爬取到的 Item 给 Item Pipeline,scrapy-redis 的Item Pipeline 将爬取到的 Item 存⼊redis 的 items queue。
修改过 Item Pipeline 可以很⽅便的根据 key 从 items queue 提取 item,从⽽实现 items processes 集群。
4、Base Spider
不在使⽤scrapy 原有的 Spider 类,重写的 RedisSpider 继承了 Spider 和RedisMixin 这两个类,RedisMixin 是⽤来从 redis 读取 url 的类。 当我们⽣成⼀个 Spider 继承 RedisSpider 时,调⽤setup_redis 函数,这个函数会去连接 redis 数据库,然后会设置 signals(信号):
- ⼀个是当 spider 空闲时候的 signal,会调⽤spider_idle 函数,这个函数调schedule_next_request函数,保证 spider 是⼀直活着的状态,并且抛出 DontCloseSpider 异常。
- ⼀个是当抓到⼀个 item 时的 signal,会调⽤item_scraped 函数,这个函数会调⽤
schedule_next_request 函数,获取下⼀个 request。
二、Scrapy 和 scrapy-redis 的区别
Scrapy 是⼀个通⽤的爬⾍框架,但是不⽀持分布式,Scrapy-redis 是为了更⽅便地实现 Scrapy 分布式爬取,⽽提供了⼀些以 redis 为基础的组件(仅有组件)。
pip install scrapy-redis
Scrapy-redis 提供了下⾯四种组件(components):(四种组件意味着这四个模块都要做相应的修改)
- Scheduler
- Duplication Filter
- Item Pipeline
- Base Spider
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论