前端的正则表达式详解
文章目录
定义
正则表达式 Regular Expression,由普通字符、元字符和修饰符组成,描述了一种字符串匹配的模式 pattern,通常被用来检索、取出、替换那些符合模式的文本。
符号
普通字符
| 字符 | 含义 |
|---|---|
| [abc][A-Z] | 匹配括号中任意一个字符 |
| [^abc] | 匹配非括号中任意一个字符 |
| \d | 匹配数字字符,等价于[0-9] |
| \w | 匹配字母、数字、下划线,等价于[A-Za-z0-9_] |
| \b | 匹配单词边界 |
| \s | 匹配不可见字符,等价于[ \f\n\r\t\v] |
| \f\n\r\t\v | 匹配换页、换行、回车、制表、垂直制表符 |
| \u | 由4位十六进制数指定的Unicode字符 |
可以用\D来表示对\d取反,其余\W\B\S同理。
这里需要注意的是, [^] 取反只对任意一个字符有效,如果要匹配多个字符例如非LAL且非LAC的话是不能用[^LAL|LAC]来表述的,只能使用否定断言 (?!LAL)(?!LAC)。
/[^LAL|LAC]/.test('LA'); // false
/(?!LAL)(?!LAC)/.test('LA'); // true
元字符
元字符是一些有特殊含义的字符,简单点说就是在被匹配时需要在前加一个 \ 转义的字符。
| 字符 | 含义 |
|---|---|
| . | 匹配非换行符,等价于[^\n\r] |
| ^ | 匹配表达式的开始位置 |
| $ | 匹配表达式的结束位置 |
| | | 匹配左边或右边 |
| ()[]{} |
部分元字符 *+? 亦属于限定符,将在限定符中讲解。
限定符
限定符用来指定正则表达式的某个 pattern 被匹配次数。
| 字符 | 含义 |
|---|---|
| * | 匹配0或多次,等价于{0,} |
| + | 匹配1或多次,等价于{1,} |
| ? | 匹配0或1次,等价于{0,1} |
| {n} | 匹配n次 |
| {n,} | 匹配至少n次 |
| {n,m} | 匹配至少n次至多m次 |
限定符都是贪婪的,会尽可能多的匹配,? 如果跟在限定符后属于非贪婪模式,将实现尽可能少的匹配。'1 23'.match(/\d{1,2}/g); // ['1', '23']
'1 23'.match(/\d{1,2}?/g); // ['1', '2', '3']获取匹配
用圆括号 () 可以分组捕获 pattern,多个被获取的匹配可以用$1...$9来得到。
/(\w+)\s(\w+)/.test('Brown Bear');
console.log(RegExp.$1); // Brown
console.log(RegExp.$2); // Bear
反向引用符
反向引用允许在正则表达式内部引用之前分组捕获的文本,原则是由外向内、由左向右。
| 字符 | 含义 |
|---|---|
| \num | num表示所引用分组的编号 |
// 检查日期格式
/\d{4}([/\-.])\d{2}\1\d{2}/.test('1990/08/02')

// 检查成对标签
/<(\w+)>.*?<\/\1>/.test('<span>bear</span>')
非获取匹配符
当不需要得到这组内容时,可以用非获取匹配符来实现。
| 字符 | 含义 |
|---|---|
| (?:pattern) | |
| (?=pattern) | 断言,预查匹配pattern的 |
| (?!pattern) | 否定断言,预查不匹配pattern的 |
/Bear(?=082)/.test('Bear082') // true
/Bear(?=082)/.test('Bear0802') // false

/Bear(?!082)/.test('Bear082') // false
/Bear(?!082)/.test('Bear0802') // true这里需要注意的是,JavaScript起初并不支持反向断言(?<=)和反向否定断言(?<!),虽然后续在ES2018中补全了这一特性,但这并不会被babel或polyfill转换,所以需要谨慎使用(个人建议暂时弃用)。

// in Safari
// SyntaxError: Invalid regular expression: invalid group specifier name
const videoUrl = 'http://play.tuhu.org/tuhulive/THMKT175B6074B01.m3u8?txSecret=&txTime=';
const videoId = videoUrl.match(/(?<=tuhulive\/)\w+/)?.[0];

      ↓ ↓ ↓ ↓ ↓ ↓

// a better compatible choice
const videoId = videoUrl.match(/tuhulive\/(\w+)/)?.[1];
修饰符
修饰符用于指定额外的匹配策略,位于正则表达式之外。
/pattern/flags
| 修饰符 | 含义 | 实例 |
|---|---|---|
| i | 忽略大小写 | 'Bear'.match(/bear/i) |
| g | 全局匹配 | 'bear bear'.match(/bear/g) |
| m | 多行匹配,使边界符 ^ 和 $ 匹配每一行 | 'bear\nbear'.match(/^bear/gm) |
s( ES2018 新增) | 允许.匹配换行符\n\r | 'bear\nbear'.match(/bear./s) |
s 修饰符出现之前一般用 [\s\S] 来替代匹配任何字符,ES 新特性另外还新增了 u(unicode) 和 y(sticky) 和 d(hasIndices) 修饰符,由于使用场景相当之少,这里就不花篇幅介绍了。
属性
source
source 属性返回当前正则表达式的字符串,该字符串不会包含两边的斜杠以及任何的标志字符。
const reg = /bear/g;
reg.source; // bear
大家熟知的 underscore 和 lodash 的 _.template 方法源码中有这么一段经典代码:
export default _.templateSettings = {
  evaluate: /<%([\s\S]+?)%>/g,
  interpolate: /<%=([\s\S]+?)%>/g,
  escape: /<%-([\s\S]+?)%>/g
};
var matcher = RegExp([
(settings.escape || noMatch).source,
(settings.interpolate || noMatch).source,
(settings.evaluate || noMatch).source
].join('|') + '|$', 'g');- evaluate对应表达式<% console.log('Bear'); %>
- interpolate对应插入值<%= value %>
- escape对应转义值<%- value %>
当需要将这三种正则合并成一种使其都能匹配到时,source 的巧妙用法就能帮助代码简洁易懂许多。
lastIndex
lastIndex 属性是一个可读写的整数,用来指定下一次匹配的起始索引。
需要注意这个属性有两个限制:
- 仅
test和exec方法有效 - 仅
g或y修饰符有效,其余永远值为0
示例:
const reg = /bear/g;
console.log(reg.test('bear')); // true
console.log(reg.test('bear')); // false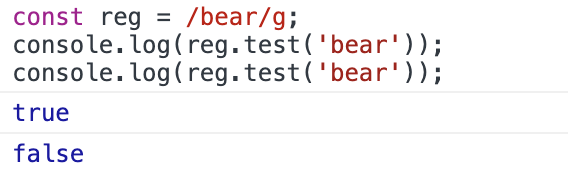
原因很简单,执行第一次 test 方法的时候 lastIndex 被置为了4,第二次是从位置4也就是字符串尾作为起始索引开始检测,所以无法匹配。
方法
String.prototype
replace返回一个被正则表达式替换后的新字符串match查看正则表达式与指定的字符串匹配的结果,返回一个结果数组或null- 使用
g(global)时,返回匹配的字符串数组 - 不使用
g(global)时, 与RegExp.prototype.exec类似但不如其强大,只返回第一个结果数组
const reg = /\w+/g; const str = 'Brown Bear'; str.match(reg); // ['Brown', 'Bear'] const reg = /\w+/; const str = 'Brown Bear'; str.match(reg); // ['Brown', index: 0, input: 'Brown Bear', groups: undefined]- 使用
search返回查找匹配的索引split把字符串分割为字符串数组
鉴于 replace 的高频使用次数及强大功能,这里额外花些篇幅讲解下。
| 参数 | 含义 |
|---|---|
| regexp | substr | 被替换的正则表达式匹配的文本或字符串,字符串格式时仅第一个匹配项会被替换 |
| newSubStr | replacer | 用于替换的字符串值或生成替换文本的函数 |
用于替换的字符串newSubStr中 $ 字符具有特定的含义:
| 字符 | 含义 |
|---|---|
| $$ | $ |
| $& | 匹配的文本 |
| $` | 匹配的文本的左边的文本 |
| $' | 匹配的文本的右边的文本 |
| $1...$99 | 匹配的第1到99个被捕获的文本,如果未匹配该分组则返回空字符串,如果不存在该分组则直接沿用字面量 |
| $<name> | 匹配的命名捕获<name> |
'Brown Bear'.replace(/(\w+)\s(\w+)/, '$2 $1'); // 'Bear Brown'
'Brown Bear'.replace(/(\w+)\s(\w+)/, '$3 $2 $1'); // '$3 Bear Brown'
// 命名捕获与分组捕获共用,此例中$<bear>与$2内容相同
'Brown Bear'.replace(/(\w+)\s(?<bear>\w+)/, '$<bear> $1'); // 'Bear Brown'
替换函数replacer(match, p1, p2, ...pN, offset, string, groups)中参数的含义:
| 参数 | 含义 |
|---|---|
| match | 匹配的文本,对应$& |
| p1...p99 | 匹配的第1到99个被捕获的文本,如果未匹配该分组则返回 undefined,对应$1...$99 |
| offset | 匹配的文本的索引值,对应 exec.index |
| string | 原始文本 |
| groups | 命名捕获组成的对象 |
'Brown Bear'.replace(/(\w+)\s(?<bear>\w+)/, (...args) => {
  return args.at(-1)?.bear; // 'Bear'
});
命名捕获(Named capture group)已经在 IE 外的浏览器得到普遍支持,可以放心使用。RegExp.prototype
test查看正则表达式与指定的字符串是否匹配,返回true或falseexec查看正则表达式与指定的字符串匹配的结果,返回一个结果数组或null,一般配合while使用。exec是正则表达式的原始方法,本身非常强大且被许多其他的正则表达式方法内部调用,但是可读性也是最差的。let result; const reg = /bear/g; const str = 'bear bear'; while(result = reg.exec(str)) { console.log(result[0], result.index); }
区别
介绍了这么多方法,是不是有些混乱,究竟该在什么场景使用哪种方法呢?这里根据个人经验做了些总结:
- 如果只是为了判断是否匹配,使用
RegExp.prototype.test - 如果只是为了查找匹配的索引,使用
String.prototype.search - 如果只是为了查找匹配的文本,使用
String.prototype.match - 如果只是为了替换匹配的文本,使用
String.prototype.replace - 如果为了循环查找匹配的文本,使用
RegExp.prototype.exec
常用案例
手机号加密
'13012345678'.replace(/(\d{3})\d{4}/, '$1****');
前端加密属于掩耳盗铃,还是要区分场合使用,千万不要因为学到了就装X(我来做!一行正则搞定的事情!)。
字符串长度和宽度
这里会涉及到两个概念:
// 匹配中文字符
const = chineseCharactorRegexp = /[\u4e00-\u9fa5]/;

// 匹配双字节字符(包含中文字符)
const = doubleCharactorRegexp = /[^\x00-\xff]/;- 需要计算文本长度限制时,根据需求,中文字符或双字节字符占两个长度得出实际总长度
canvas需要计算文本宽度时,可以基于等款字体Courier和单/双字节字符宽度配合得出const FONT_SIZE_WIDTH = 13; const DOUBLE_CHARACTOR_FACTOR = 1; const SINGLE_CHARACTOR_FACTOR = 0.6; const DOUBLE_CHARACTOR_WIDTH = FONT_SIZE_WIDTH * DOUBLE_CHARACTOR_FACTOR; const SINGLE_CHARACTOR_WIDTH = FONT_SIZE_WIDTH * SINGLE_CHARACTOR_FACTOR; const getCharactorWidth = char => doubleCharactorRegexp.test(char) ? DOUBLE_CHARACTOR_WIDTH : SINGLE_CHARACTOR_WIDTH);
千位分隔符
'12345678'.replace(/\d(?=(\d{3})+$)/g, '$&,');这里其实还有一种更高大上的实现方式:
(12345678).toLocaleString('en-US', {
  minimumFractionDigits: 2,
  maximumFractionDigits: 6
});
可能有细心的同学要问,如果分隔符是 . 怎么办呢,这个方法还能用吗?回答是当然,可以通过第一个参数区域locales来支持,这里就不赘述了。

验证密码复杂度
// 要求密码中必须包含大小写字母、数字,至少8个字符至多16个字符
/^(?:(?=.*[A-Z])(?=.*[a-z])(?=.*[0-9])).{8,16}$/.test('Bear0802');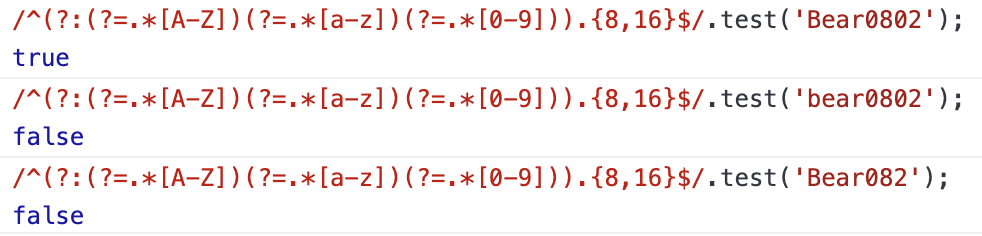
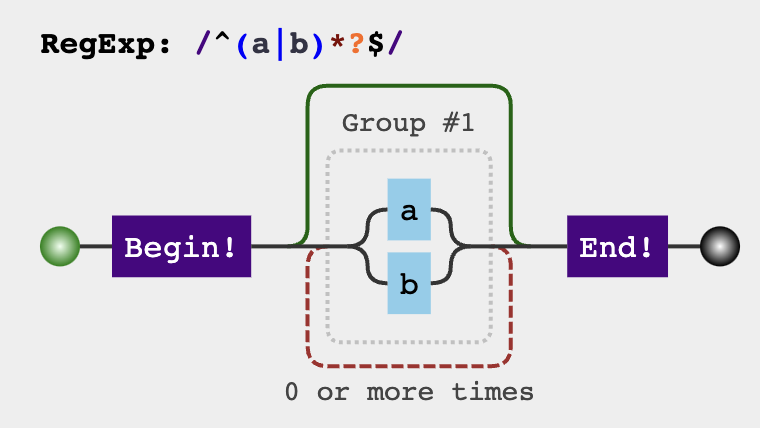
可视化工具
- 支持正则可视化
- 支持导出为图片,方便分享、留存
结语
正则表达式需要强大的基本功作为支撑,理解吃透它并不容易,真正用到它时,先不要忙于生搬硬套,罗列出所有场景并结合可视化工具,写出符合自己需求的正则表达式。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论