Redis从入门到放弃
文章目录
安装
如果还是使用官网下载源码的方式编译安装redis,那有点low了,何不尝试下docker这个神器
直接 docker run -p 6379:6379 -d redis 即可,默认会拉取最新稳定版本的redis镜像,并且启动一个redis实例
其中 -p 指定端口 -d 后台运行,docker的相关命令如果不熟悉的话,可以先花几分钟时间快速熟悉一下
如果需要指定版本,可以docker pull具体的tag
https://hub.docker.com/_/redis 提供了4.x 到 6.x的所有的版本
有兴趣的话,可以看下 https://github.com/docker-lib...
通过这个dockerFile也能清晰的看到,其实也是下载redis的源码,然后做编译,只不过是把这一系列的步骤打包在一起执行了
安装启动了以后通过
docker exec -it container_id /bin/bash
进入容器后会发现没有redis.conf
这是因为docker镜像是不可变的,假设把redis.conf打包到镜像里,那么这个镜像的redis的配置也就固定了
所以需要在启动的时候映射redis.conf
docker run -p 6379:6379 -d -v ~/software/redis-5.0.5/redis.conf:/usr/local/etc/redis/redis.conf redis redis-server /usr/local/etc/redis/redis.conf
如果需要持久化的话,可以通过-v 把镜像内的数据文件挂载到宿主机上,镜像内的数据文件目录是 /data
docker run -p 6379:6379 -d -v /path/data:/data -v ~/path/redis.conf:/usr/local/etc/redis/redis.conf redis redis-server /usr/local/etc/redis/redis.conf
版本差异
4.x 主要是引入 RDB+AOF 混合模式
Redis 4.0 was released as GA in July 2017, newcomers should use Redis 5, but Redis 4 is currently the most production-proven release and will be updated for the next year until Redis 6 will be out. It contains several big improvements: a modules system, much better replication (PSYNC2), improvements to eviction policies, threaded DEL/FLUSH, mixed RDB+AOF format, Raspberry Pi support as primary platform, the new MEMORY command, Redis Cluster support for Nat/Docker, active memory defragmentation, memory usage and performance improvements, much faster Redis Cluster key creation, many other smaller features and a number of behavior fixed.
5.x
稳定版
Redis 5.0 is the first version of Redis to introduce the new stream data type with consumer groups, sorted sets blocking pop operations, LFU/LRU info in RDB, Cluster manager inside redis-cli, active defragmentation V2, HyperLogLogs improvements and many other improvements. Redis 5 was release as GA in October 2018.
6.x
Beta版
Redis 6.0 introduces SSL, the new RESP3 protocol, ACLs, client side caching, diskless replicas, I/O threads, and many more improvements. Currently in release candidate, will be stable between March and May 2020
redis.conf
redis.conf 非常的规则,按照模块(例如 网络,主从复制)来归类配置, 加上注释总共1300多行,这里整理一些比较常用的配置
include /path/to/local.conf 如果有很多个redis-server,其中有通用配置,又有个性化配置的话,通过include来实现会很方便
bind 127.0.0.1
绑定ip,默认绑定127.0.0.1,建议绑定指定ip,避免把redis暴露到整个互联网上
protected-mode yes
如果没有设置bind,以及password,就不允许外网访问,也是为了保护redis实例的安全性
触发rdb的配置,在多少秒内,多少个key发生了变化
save 900 1
save 300 10
save 60 10000
如果启用了rdb并且最近的一次个save失败了,则redis会拒绝写入命令,这种情况一般会发生在硬盘空间不够,或者内存不足(rdb的时候会fork一个进程),这么做的目的是为了让用户知道数据持久化失败了
stop-writes-on-bgsave-error yes
可以通过这个配置来指定及时rdb失败了,仍然允许写入
rdbcompression yes
使用LZF压缩string对象,如果开启了LZF,会需要更多地CPU,如果不开启,则需要更多的存储空间
rdbchecksum yes
5.x版本以上的redis rbd文件的尾部是一个CRC64 checksum ,在load rdb的时候可以进行校验,如果开启rdbchecksum,大概会有10%左右的性能消耗~~~~
replica-serve-stale-data yes
是否允许在同步未完成的时候,slave提供服务,默认是yes,如果设置为no,则在同步未完成时候收到请求命令会返回报错信息
replica-read-only yes
replica是否只读,默认是,
repl-diskless-sync
在全量同步的时候,如何同步数据(在有新的备份加入或者slave断开连接然后重新连接上来以后)
一种策略是 基于磁盘的,master 创建一个新的进程生成一份rdb文件,然后传输给slave,这种策略的好处是这个rdb文件可以传输给多个slave
另外一种策略是 基于socket的,直接传输给相应的replica
如果磁盘速度很慢,同时网络带宽大,传输速度快的情况下用基于socket的会更好
replica-priority 100
当master挂掉了,redis sentinel会从slave中挑选一个成为新的master,这时候就跟着这个值来选择,这个值越小,选为master的优先级越高,但是如果这个值是0的话,就不会被选为master
min-replicas-to-write
如果当前有效的slave数小于配置值的话,那么master就会拒绝写入
默认是0,禁用这个特性
maxclients 10000
最大可连接数量
rename-commond
例如 rename-commond flushall ""
rename-commond flushdb ""通过把一些非常危险的命令进行rename,来达到禁用这些命令的目的
maxmemory
限制redis的内存,如果超过了最大内存,则根据内存淘汰策略进行淘汰
如果淘汰后内存还不够,或者设置的淘汰策略是不淘汰,则对于写入命令,直接返回错误,但是仍然可以提供查询服务
maxmemory-policy 内存淘汰策略
默认的是 noeviction 不淘汰,也就是内存一旦满了就不接受写入
以下7种策略,5种行为模式可选
volatile-lru 在设置了过期时间的key中进行lru
allkeys-lru 所有的key进行lru
volatile-lfu 在设置了过期时间的key中进行lfu
allkeys-lfu 所有的key进行lfu
volatile-random 在设置了过期时间的key中随机选取
allkeys-random 所有的key随机选取
volatile-ttl 淘汰最近快过期的
noeviction
lru: Least Recently Used
lfu: Least Frequently Used
maxmemory-samples
默认为5,redis使用的lru lfu并不是最精确的,而是出于性能考虑做了取舍,如果增加 maxmemory-samples 的值,则lfu lru会更准确,但是相应的需要消耗更多的cpu
测试
如果关闭redis的时候,redis会主动做一次rdb,应该是监听了kill信号
1.主从测试
启动master节点
启动slave节点
同步失败,因为master开启了password,slave节点的masterauth未设置导致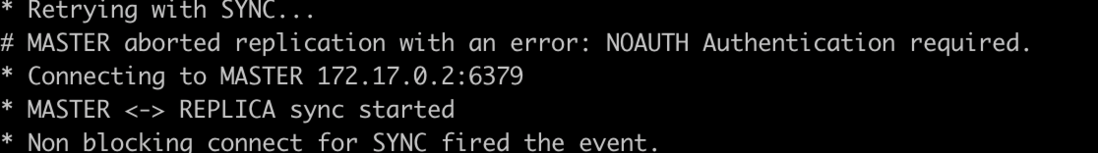
设置好后同步成功
master日志如下
slave日志如下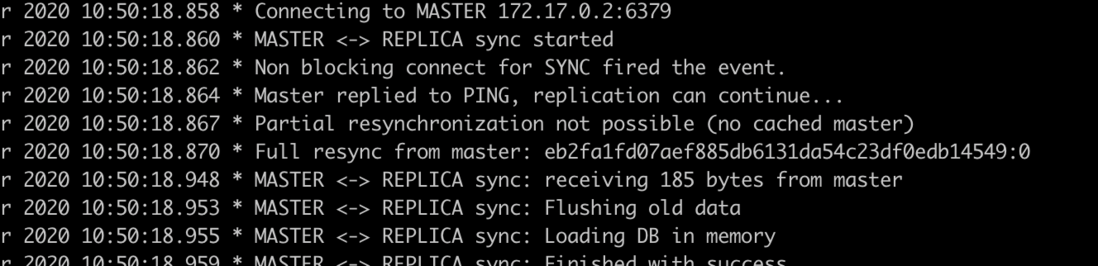
slave日志有几行关键点
a.先是 DB loaded from disk
b. MASTER <-> REPLICA sync: receiving 185 bytes from master
  MASTER <-> REPLICA sync: Flushing old data
     然后从master同步了数据以后,flush到了旧数据
  然后再把数据load到内存里,到此slave就可以提供服务了
  如果slave开启了aof,那么master同步过去的命令也会记录到slave的aof文件中
2.修改master的配置,至少需要一个连接着的slave,然后关闭slave,查看master是否还能接受写入
测试结果如下:
关闭slave后,master会监听到连接丢失
如果连接中的slave数量小于 min-replicas-to-write ,则拒绝写入
如果重新启动slave,那么会发起一次全量的full resync
同时master正常接受写请求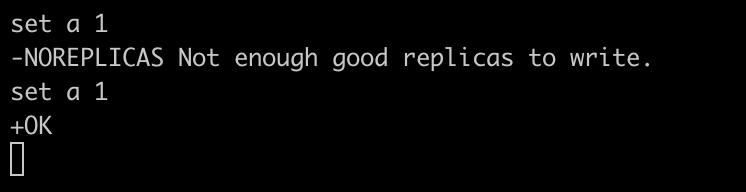
3.配合redis的哨兵,关掉master,看下slave是否能晋升为master
4.修改slave的replica-priority为0,同时关闭master,查看slave是否能晋升
- maxmemory测试
把maxmemory设置得很小,那么set的时候如果内寸不够了,就会抛异常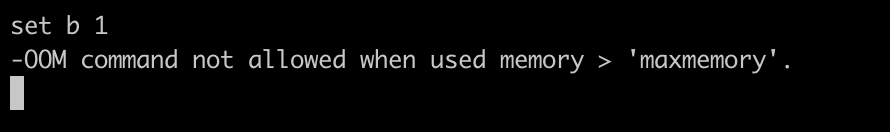
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论