滴滴前端一面必会vue面试题(附答案)
文章目录
实现双向绑定
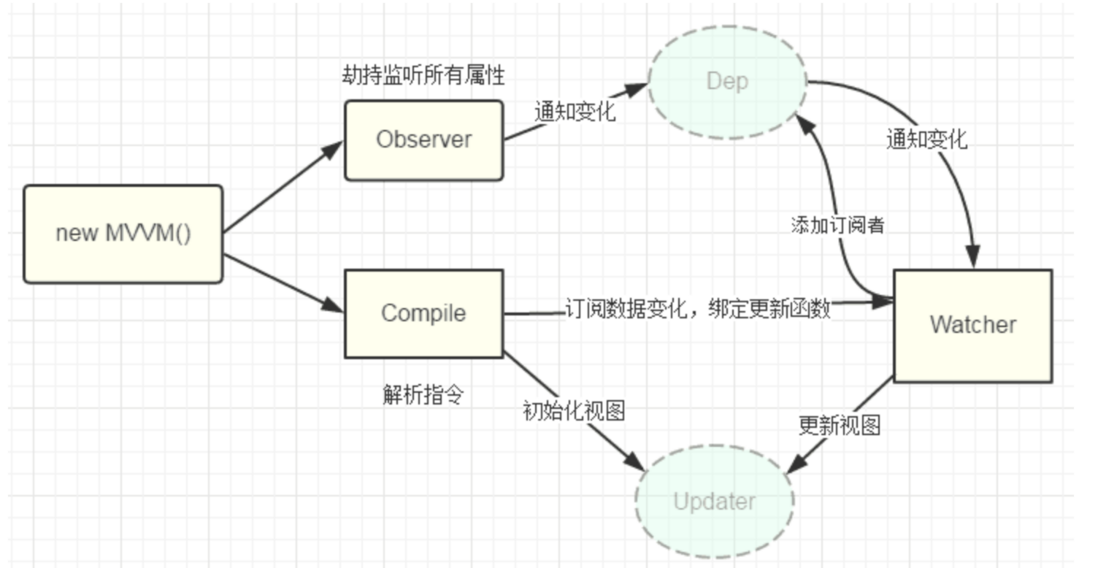
我们还是以Vue为例,先来看看Vue中的双向绑定流程是什么的
new Vue()首先执行初始化,对data执行响应化处理,这个过程发生Observe中- 同时对模板执行编译,找到其中动态绑定的数据,从
data中获取并初始化视图,这个过程发生在Compile中 - 同时定义⼀个更新函数和
Watcher,将来对应数据变化时Watcher会调用更新函数 - 由于
data的某个key在⼀个视图中可能出现多次,所以每个key都需要⼀个管家Dep来管理多个Watcher - 将来data中数据⼀旦发生变化,会首先找到对应的
Dep,通知所有Watcher执行更新函数
流程图如下:
先来一个构造函数:执行初始化,对data执行响应化处理
class Vue {
  constructor(options) {
    this.$options = options;
    this.$data = options.data;

    // 对data选项做响应式处理
    observe(this.$data);

    // 代理data到vm上
    proxy(this);

    // 执行编译
    new Compile(options.el, this);
  }
} 对data选项执行响应化具体操作
function observe(obj) {
  if (typeof obj !== "object" || obj == null) {
    return;
  }
  new Observer(obj);
}

class Observer {
  constructor(value) {
    this.value = value;
    this.walk(value);
  }
  walk(obj) {
    Object.keys(obj).forEach((key) => {
      defineReactive(obj, key, obj[key]);
    });
  }
} 编译Compile
对每个元素节点的指令进行扫描跟解析,根据指令模板替换数据,以及绑定相应的更新函数

class Compile {
  constructor(el, vm) {
    this.$vm = vm;
    this.$el = document.querySelector(el);  // 获取dom
    if (this.$el) {
      this.compile(this.$el);
    }
  }
  compile(el) {
    const childNodes = el.childNodes;
    Array.from(childNodes).forEach((node) => { // 遍历子元素
      if (this.isElement(node)) {   // 判断是否为节点
        console.log("编译元素" + node.nodeName);
      } else if (this.isInterpolation(node)) {
        console.log("编译插值⽂本" + node.textContent);  // 判断是否为插值文本 {{}}
      }
      if (node.childNodes && node.childNodes.length > 0) {  // 判断是否有子元素
        this.compile(node);  // 对子元素进行递归遍历
      }
    });
  }
  isElement(node) {
    return node.nodeType == 1;
  }
  isInterpolation(node) {
    return node.nodeType == 3 && /\{\{(.*)\}\}/.test(node.textContent);
  }
}
依赖收集
视图中会用到data中某key,这称为依赖。同⼀个key可能出现多次,每次都需要收集出来用⼀个Watcher来维护它们,此过程称为依赖收集多个Watcher需要⼀个Dep来管理,需要更新时由Dep统⼀通知

实现思路
defineReactive时为每⼀个key创建⼀个Dep实例- 初始化视图时读取某个
key,例如name1,创建⼀个watcher1 - 由于触发
name1的getter方法,便将watcher1添加到name1对应的Dep中 - 当
name1更新,setter触发时,便可通过对应Dep通知其管理所有Watcher更新
// 负责更新视图
class Watcher {
  constructor(vm, key, updater) {
    this.vm = vm
    this.key = key
    this.updaterFn = updater

    // 创建实例时,把当前实例指定到Dep.target静态属性上
    Dep.target = this
    // 读一下key,触发get
    vm[key]
    // 置空
    Dep.target = null
  }

  // 未来执行dom更新函数,由dep调用的
  update() {
    this.updaterFn.call(this.vm, this.vm[this.key])
  }
} 声明Dep
class Dep {
  constructor() {
    this.deps = [];  // 依赖管理
  }
  addDep(dep) {
    this.deps.push(dep);
  }
  notify() {
    this.deps.forEach((dep) => dep.update());
  }
} 创建watcher时触发getter
class Watcher {
  constructor(vm, key, updateFn) {
    Dep.target = this;
    this.vm[this.key];
    Dep.target = null;
  }
} 依赖收集,创建Dep实例
function defineReactive(obj, key, val) {
  this.observe(val);
  const dep = new Dep();
  Object.defineProperty(obj, key, {
    get() {
      Dep.target && dep.addDep(Dep.target);// Dep.target也就是Watcher实例
      return val;
    },
    set(newVal) {
      if (newVal === val) return;
      dep.notify(); // 通知dep执行更新方法
    },
  });
}
说说你对 proxy 的理解,Proxy 相比于 defineProperty 的优势
Object.defineProperty() 的问题主要有三个:
- 不能监听数组的变化 :无法监控到数组下标的变化,导致通过数组下标添加元素,不能实时响应
- 必须遍历对象的每个属性 :只能劫持对象的属性,从而需要对每个对象,每个属性进行遍历,如果属性值是对象,还需要深度遍历。
Proxy可以劫持整个对象,并返回一个新的对象 - 必须深层遍历嵌套的对象
Proxy的优势如下:
- 针对对象: 针对整个对象,而不是对象的某个属性 ,所以也就不需要对
keys进行遍历 - 支持数组:
Proxy不需要对数组的方法进行重载,省去了众多 hack,减少代码量等于减少了维护成本,而且标准的就是最好的 Proxy的第二个参数可以有13种拦截方:不限于apply、ownKeys、deleteProperty、has等等是Object.defineProperty不具备的Proxy返回的是一个新对象,我们可以只操作新的对象达到目的,而Object.defineProperty只能遍历对象属性直接修改Proxy作为新标准将受到浏览器厂商重点持续的性能优化,也就是传说中的新标准的性能红利
proxy详细使用点击查看(opens new window)
Object.defineProperty的优势如下:
兼容性好,支持IE9,而Proxy的存在浏览器兼容性问题,而且无法用polyfill磨平
defineProperty的属性值有哪些
Object.defineProperty(obj, prop, descriptor)

// obj 要定义属性的对象
// prop 要定义或修改的属性的名称
// descriptor 要定义或修改的属性描述符

Object.defineProperty(obj,"name",{
  value:"poetry", // 初始值
  writable:true, // 该属性是否可写入
  enumerable:true, // 该属性是否可被遍历得到(for...in, Object.keys等)
  configurable:true, // 定该属性是否可被删除,且除writable外的其他描述符是否可被修改
  get: function() {},
  set: function(newVal) {}
})
相关代码如下
import { mutableHandlers } from "./baseHandlers"; // 代理相关逻辑
import { isObject } from "./util"; // 工具方法

export function reactive(target) {
  // 根据不同参数创建不同响应式对象
  return createReactiveObject(target, mutableHandlers);
}
function createReactiveObject(target, baseHandler) {
  if (!isObject(target)) {
    return target;
  }
  const observed = new Proxy(target, baseHandler);
  return observed;
}

const get = createGetter();
const set = createSetter();

function createGetter() {
  return function get(target, key, receiver) {
    // 对获取的值进行放射
    const res = Reflect.get(target, key, receiver);
    console.log("属性获取", key);
    if (isObject(res)) {
      // 如果获取的值是对象类型,则返回当前对象的代理对象
      return reactive(res);
    }
    return res;
  };
}
function createSetter() {
  return function set(target, key, value, receiver) {
    const oldValue = target[key];
    const hadKey = hasOwn(target, key);
    const result = Reflect.set(target, key, value, receiver);
    if (!hadKey) {
      console.log("属性新增", key, value);
    } else if (hasChanged(value, oldValue)) {
      console.log("属性值被修改", key, value);
    }
    return result;
  };
}
export const mutableHandlers = {
  get, // 当获取属性时调用此方法
  set, // 当修改属性时调用此方法
};Proxy只会代理对象的第一层,那么Vue3又是怎样处理这个问题的呢?
判断当前Reflect.get的返回值是否为Object,如果是则再通过reactive方法做代理, 这样就实现了深度观测。
监测数组的时候可能触发多次get/set,那么如何防止触发多次呢?
我们可以判断key是否为当前被代理对象target自身属性,也可以判断旧值与新值是否相等,只有满足以上两个条件之一时,才有可能执行trigger
虚拟 DOM 的优缺点?
优点:
- 保证性能下限: 框架的虚拟 DOM 需要适配任何上层 API 可能产生的操作,它的一些 DOM 操作的实现必须是普适的,所以它的性能并不是最优的;但是比起粗暴的 DOM 操作性能要好很多,因此框架的虚拟 DOM 至少可以保证在你不需要手动优化的情况下,依然可以提供还不错的性能,即保证性能的下限;
- 无需手动操作 DOM: 我们不再需要手动去操作 DOM,只需要写好 View-Model 的代码逻辑,框架会根据虚拟 DOM 和 数据双向绑定,帮我们以可预期的方式更新视图,极大提高我们的开发效率;
- 跨平台: 虚拟 DOM 本质上是 JavaScript 对象,而 DOM 与平台强相关,相比之下虚拟 DOM 可以进行更方便地跨平台操作,例如服务器渲染、weex 开发等等。
缺点:
- 无法进行极致优化: 虽然虚拟 DOM + 合理的优化,足以应对绝大部分应用的性能需求,但在一些性能要求极高的应用中虚拟 DOM 无法进行针对性的极致优化。
谈谈Vue和React组件化的思想
- 1.我们在各个页面开发的时候,会产生很多重复的功能,比如element中的xxxx。像这种纯粹非页面的UI,便成为我们常用的UI组件,最初的前端组件也就仅仅指的是UI组件
- 2.随着业务逻辑变得越来多是,我们就想要我们的组件可以处理很多事,这就是我们常说的组件化,这个组件就不是UI组件了,而是包具体业务的业务组件
- 3.这种开发思想就是分而治之。最大程度的降低开发难度和维护成本的效果。并且可以多人协作,每个人写不同的组件,最后像撘积木一样的把它构成一个页面
Vue 组件间通信有哪几种方式?
Vue 组件间通信是面试常考的知识点之一,这题有点类似于开放题,你回答出越多方法当然越加分,表明你对 Vue 掌握的越熟练。Vue 组件间通信只要指以下 3 类通信:父子组件通信、隔代组件通信、兄弟组件通信,下面我们分别介绍每种通信方式且会说明此种方法可适用于哪类组件间通信。
(1)props / $emit 适用 父子组件通信
这种方法是 Vue 组件的基础,相信大部分同学耳闻能详,所以此处就不举例展开介绍。
(2)ref 与 $parent / $children 适用 父子组件通信
ref:如果在普通的 DOM 元素上使用,引用指向的就是 DOM 元素;如果用在子组件上,引用就指向组件实例$parent/$children:访问父 / 子实例
(3)EventBus ($emit / $on) 适用于 父子、隔代、兄弟组件通信
这种方法通过一个空的 Vue 实例作为中央事件总线(事件中心),用它来触发事件和监听事件,从而实现任何组件间的通信,包括父子、隔代、兄弟组件。
(4)$attrs/$listeners 适用于 隔代组件通信
$attrs:包含了父作用域中不被 prop 所识别 (且获取) 的特性绑定 ( class 和 style 除外 )。当一个组件没有声明任何 prop 时,这里会包含所有父作用域的绑定 ( class 和 style 除外 ),并且可以通过v-bind="$attrs"传入内部组件。通常配合 inheritAttrs 选项一起使用。$listeners:包含了父作用域中的 (不含 .native 修饰器的) v-on 事件监听器。它可以通过v-on="$listeners"传入内部组件
(5)provide / inject 适用于 隔代组件通信
祖先组件中通过 provider 来提供变量,然后在子孙组件中通过 inject 来注入变量。 provide / inject API 主要解决了跨级组件间的通信问题,不过它的使用场景,主要是子组件获取上级组件的状态,跨级组件间建立了一种主动提供与依赖注入的关系。
(6)Vuex 适用于 父子、隔代、兄弟组件通信
Vuex 是一个专为 Vue.js 应用程序开发的状态管理模式。每一个 Vuex 应用的核心就是 store(仓库)。“store” 基本上就是一个容器,它包含着你的应用中大部分的状态 ( state )。
- Vuex 的状态存储是响应式的。当 Vue 组件从 store 中读取状态的时候,若 store 中的状态发生变化,那么相应的组件也会相应地得到高效更新。
- 改变 store 中的状态的唯一途径就是显式地提交 (commit) mutation。这样使得我们可以方便地跟踪每一个状态的变化。
Vue 为什么要用 vm.$set() 解决对象新增属性不能响应的问题 ?你能说说如下代码的实现原理么?
1)Vue为什么要用vm.$set() 解决对象新增属性不能响应的问题
- Vue使用了Object.defineProperty实现双向数据绑定
- 在初始化实例时对属性执行 getter/setter 转化
- 属性必须在data对象上存在才能让Vue将它转换为响应式的(这也就造成了Vue无法检测到对象属性的添加或删除)
所以Vue提供了Vue.set (object, propertyName, value) / vm.$set (object, propertyName, value)
2)接下来我们看看框架本身是如何实现的呢?
Vue 源码位置:vue/src/core/instance/index.js
export function set (target: Array<any> | Object, key: any, val: any): any {
  // target 为数组
  if (Array.isArray(target) && isValidArrayIndex(key)) {
    // 修改数组的长度, 避免索引>数组长度导致splcie()执行有误
    target.length = Math.max(target.length, key)
    // 利用数组的splice变异方法触发响应式
    target.splice(key, 1, val)
    return val
  }
  // key 已经存在,直接修改属性值
  if (key in target && !(key in Object.prototype)) {
    target[key] = val
    return val
  }
  const ob = (target: any).__ob__
  // target 本身就不是响应式数据, 直接赋值
  if (!ob) {
    target[key] = val
    return val
  }
  // 对属性进行响应式处理
  defineReactive(ob.value, key, val)
  ob.dep.notify()
  return val
}
我们阅读以上源码可知,vm.$set 的实现原理是:
- 如果目标是数组,直接使用数组的 splice 方法触发相应式;
- 如果目标是对象,会先判读属性是否存在、对象是否是响应式,
- 最终如果要对属性进行响应式处理,则是通过调用 defineReactive 方法进行响应式处理
defineReactive 方法就是 Vue 在初始化对象时,给对象属性采用 Object.defineProperty 动态添加 getter 和 setter 的功能所调用的方法
参考 前端进阶面试题详细解答
你有对 Vue 项目进行哪些优化?
(1)代码层面的优化
- v-if 和 v-show 区分使用场景
- computed 和 watch 区分使用场景
- v-for 遍历必须为 item 添加 key,且避免同时使用 v-if
- 长列表性能优化
- 事件的销毁
- 图片资源懒加载
- 路由懒加载
- 第三方插件的按需引入
- 优化无限列表性能
- 服务端渲染 SSR or 预渲染
(2)Webpack 层面的优化
- Webpack 对图片进行压缩
- 减少 ES6 转为 ES5 的冗余代码
- 提取公共代码
- 模板预编译
- 提取组件的 CSS
- 优化 SourceMap
- 构建结果输出分析
- Vue 项目的编译优化
(3)基础的 Web 技术的优化
- 开启 gzip 压缩
- 浏览器缓存
- CDN 的使用
- 使用 Chrome Performance 查找性能瓶颈
Vue 中给 data 中的对象属性添加一个新的属性时会发生什么?如何解决?
<template>
   <div>
      <ul>
         <li v-for="value in obj" :key="value"> {{value}} </li>       </ul>       <button @click="addObjB">添加 obj.b</button>    </div>
</template>

<script>
    export default {        data () {           return {               obj: {                   a: 'obj.a'               }           }        },       methods: {           addObjB () {               this.obj.b = 'obj.b'               console.log(this.obj)           }       }   }
</script>
点击 button 会发现,obj.b 已经成功添加,但是视图并未刷新。这是因为在Vue实例创建时,obj.b并未声明,因此就没有被Vue转换为响应式的属性,自然就不会触发视图的更新,这时就需要使用Vue的全局 api $set():
addObjB () (
   this.$set(this.obj, 'b', 'obj.b')
   console.log(this.obj)
}
$set()方法相当于手动的去把obj.b处理成一个响应式的属性,此时视图也会跟着改变了。
Vue中组件生命周期调用顺序说一下
组件的调用顺序都是先父后子,渲染完成的顺序是先子后父。
组件的销毁操作是先父后子,销毁完成的顺序是先子后父。
加载渲染过程
父beforeCreate->父created->父beforeMount->子beforeCreate->子created->子beforeMount- >子mounted->父mounted子组件更新过程
父beforeUpdate->子beforeUpdate->子updated->父updated父组件更新过程
父 beforeUpdate -> 父 updated销毁过程
父beforeDestroy->子beforeDestroy->子destroyed->父destroyedvue 中使用了哪些设计模式
1.工厂模式 - 传入参数即可创建实例
虚拟 DOM 根据参数的不同返回基础标签的 Vnode 和组件 Vnode
2.单例模式 - 整个程序有且仅有一个实例
vuex 和 vue-router 的插件注册方法 install 判断如果系统存在实例就直接返回掉
3.发布-订阅模式 (vue 事件机制)
4.观察者模式 (响应式数据原理)
5.装饰模式: (@装饰器的用法)
6.策略模式 策略模式指对象有某个行为,但是在不同的场景中,该行为有不同的实现方案-比如选项的合并策略
Vue模版编译原理知道吗,能简单说一下吗?
简单说,Vue的编译过程就是将template转化为render函数的过程。会经历以下阶段:
- 生成AST树
- 优化
- codegen
首先解析模版,生成AST语法树(一种用JavaScript对象的形式来描述整个模板)。 使用大量的正则表达式对模板进行解析,遇到标签、文本的时候都会执行对应的钩子进行相关处理。
Vue的数据是响应式的,但其实模板中并不是所有的数据都是响应式的。有一些数据首次渲染后就不会再变化,对应的DOM也不会变化。那么优化过程就是深度遍历AST树,按照相关条件对树节点进行标记。这些被标记的节点(静态节点)我们就可以跳过对它们的比对,对运行时的模板起到很大的优化作用。
编译的最后一步是将优化后的AST树转换为可执行的代码。
Vue 中的 key 到底有什么用?
key 是给每一个 vnode 的唯一 id,依靠 key,我们的 diff 操作可以更准确、更快速 (对于简单列表页渲染来说 diff 节点也更快,但会产生一些隐藏的副作用,比如可能不会产生过渡效果,或者在某些节点有绑定数据(表单)状态,会出现状态错位。)
diff 算法的过程中,先会进行新旧节点的首尾交叉对比,当无法匹配的时候会用新节点的 key 与旧节点进行比对,从而找到相应旧节点.
更准确 : 因为带 key 就不是就地复用了,在 sameNode 函数 a.key === b.key 对比中可以避免就地复用的情况。所以会更加准确,如果不加 key,会导致之前节点的状态被保留下来,会产生一系列的 bug。
更快速 : key 的唯一性可以被 Map 数据结构充分利用,相比于遍历查找的时间复杂度 O(n),Map 的时间复杂度仅仅为 O(1)
对SSR的理解
SSR也就是服务端渲染,也就是将Vue在客户端把标签渲染成HTML的工作放在服务端完成,然后再把html直接返回给客户端
SSR的优势:
- 更好的SEO
- 首屏加载速度更快
SSR的缺点:
- 开发条件会受到限制,服务器端渲染只支持beforeCreate和created两个钩子;
- 当需要一些外部扩展库时需要特殊处理,服务端渲染应用程序也需要处于Node.js的运行环境;
- 更多的服务端负载。
Vue中如何检测数组变化
前言
Vue 不能检测到以下数组的变动:
- 当你利用索引直接设置一个数组项时,例如:
vm.items[indexOfItem] = newValue - 当你修改数组的长度时,例如:
vm.items.length = newLength
Vue 提供了以下操作方法
// Vue.set
Vue.set(vm.items, indexOfItem, newValue)
// vm.$set,Vue.set的一个别名
vm.$set(vm.items, indexOfItem, newValue)
// Array.prototype.splice
vm.items.splice(indexOfItem, 1, newValue)
分析
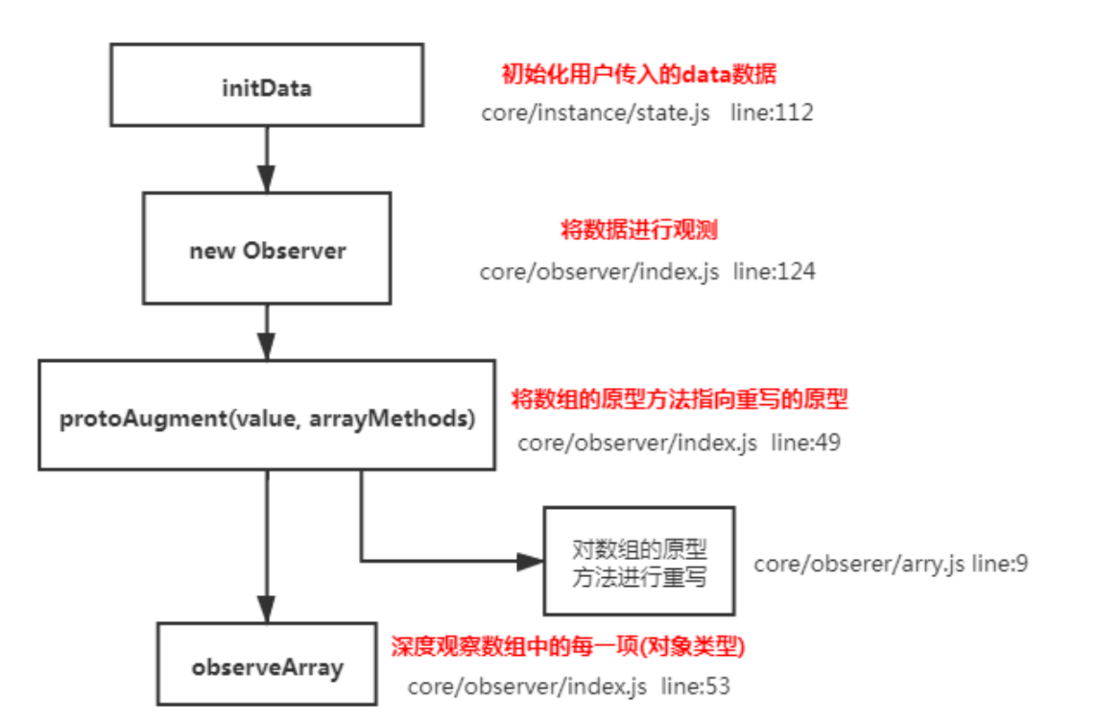
数组考虑性能原因没有用defineProperty对数组的每一项进行拦截,而是选择对7种数组(push,shift,pop,splice,unshift,sort,reverse)方法进行重写(AOP切片思想)
所以在 Vue 中修改数组的索引和长度是无法监控到的。需要通过以上 7 种变异方法修改数组才会触发数组对应的 watcher 进行更新
- 用函数劫持的方式,重写了数组方法,具体呢就是更改了数组的原型,更改成自己的,用户调数组的一些方法的时候,走的就是自己的方法,然后通知视图去更新
- 数组里每一项可能是对象,那么我就是会对数组的每一项进行观测,(且只有数组里的对象才能进行观测,观测过的也不会进行观测)
原理
Vue将data中的数组,进行了原型链重写。指向了自己定义的数组原型方法,这样当调用数组api时,可以通知依赖更新,如果数组中包含着引用类型。会对数组中的引用类型再次进行监控。
手写简版分析
let oldArray = Object.create(Array.prototype);
['shift', 'unshift', 'push', 'pop', 'reverse','sort'].forEach(method => {
    oldArray[method] = function() { // 这里可以触发页面更新逻辑
        console.log('method', method)
        Array.prototype[method].call(this,...arguments);
    }
});
let arr = [1,2,3];
arr.__proto__ = oldArray;
arr.unshift(4);
源码分析
// 拿到数组原型拷贝一份
const arrayProto = Array.prototype
// 然后将arrayMethods继承自数组原型
// 这里是面向切片编程思想(AOP)--不破坏封装的前提下,动态的扩展功能
export const arrayMethods = Object.create(arrayProto)
const methodsToPatch = [ 'push', 'pop', 'shift', 'unshift', 'splice', 'sort', 'reverse' ]

methodsToPatch.forEach(function (method) { // 重写原型方法
    const original = arrayProto[method] // 调用原数组的方法

    def(arrayMethods, method, function mutator (...args) {
        // 这里保留原型方法的执行结果
        const result = original.apply(this, args)
        // 这句话是关键
        // this代表的就是数据本身 比如数据是{a:[1,2,3]} 那么我们使用a.push(4)  this就是a  ob就是a.__ob__ 这个属性就是上段代码增加的 代表的是该数据已经被响应式观察过了指向Observer实例
        const ob = this.__ob__

        // 这里的标志就是代表数组有新增操作
        let inserted
        switch (method) {
            case 'push':
            case 'unshift':
                inserted = args
                break
            case 'splice':
                inserted = args.slice(2)
                break
        }
        // 如果有新增的元素 inserted是一个数组 调用Observer实例的observeArray对数组每一项进行观测
        if (inserted) ob.observeArray(inserted)

        ob.dep.notify() // 当调用数组方法后,手动通知视图更新

        return result
    })
})

this.observeArray(value) // 进行深度监控vue3:改用proxy,可直接监听对象数组的变化
vue和react的区别
=> 相同点:
1. 数据驱动页面,提供响应式的试图组件
2. 都有virtual DOM,组件化的开发,通过props参数进行父子之间组件传递数据,都实现了webComponents规范
3. 数据流动单向,都支持服务器的渲染SSR
4. 都有支持native的方法,react有React native, vue有wexx
=> 不同点:
 1.数据绑定:Vue实现了双向的数据绑定,react数据流动是单向的
 2.数据渲染:大规模的数据渲染,react更快
 3.使用场景:React配合Redux架构适合大规模多人协作复杂项目,Vue适合小快的项目
 4.开发风格:react推荐做法jsx + inline style把html和css都写在js了
      vue是采用webpack + vue-loader单文件组件格式,html, js, css同一个文件
Vue template 到 render 的过程
vue的模版编译过程主要如下:template -> ast -> render函数
vue 在模版编译版本的码中会执行 compileToFunctions 将template转化为render函数:
// 将模板编译为render函数const { render, staticRenderFns } = compileToFunctions(template,options//省略}, this)
CompileToFunctions中的主要逻辑如下∶ (1)调用parse方法将template转化为ast(抽象语法树)
constast = parse(template.trim(), options)
- parse的目标:把tamplate转换为AST树,它是一种用 JavaScript对象的形式来描述整个模板。
- 解析过程:利用正则表达式顺序解析模板,当解析到开始标签、闭合标签、文本的时候都会分别执行对应的 回调函数,来达到构造AST树的目的。
AST元素节点总共三种类型:type为1表示普通元素、2为表达式、3为纯文本
(2)对静态节点做优化
optimize(ast,options)
这个过程主要分析出哪些是静态节点,给其打一个标记,为后续更新渲染可以直接跳过静态节点做优化
深度遍历AST,查看每个子树的节点元素是否为静态节点或者静态节点根。如果为静态节点,他们生成的DOM永远不会改变,这对运行时模板更新起到了极大的优化作用。
(3)生成代码
const code = generate(ast, options)
generate将ast抽象语法树编译成 render字符串并将静态部分放到 staticRenderFns 中,最后通过 new Function(` render`) 生成render函数。
computed 的实现原理
computed 本质是一个惰性求值的观察者。
computed 内部实现了一个惰性的 watcher,也就是 computed watcher,computed watcher 不会立刻求值,同时持有一个 dep 实例。
其内部通过 this.dirty 属性标记计算属性是否需要重新求值。
当 computed 的依赖状态发生改变时,就会通知这个惰性的 watcher,
computed watcher 通过 this.dep.subs.length 判断有没有订阅者,
有的话,会重新计算,然后对比新旧值,如果变化了,会重新渲染。 (Vue 想确保不仅仅是计算属性依赖的值发生变化,而是当计算属性最终计算的值发生变化时才会触发渲染 watcher 重新渲染,本质上是一种优化。)
没有的话,仅仅把 this.dirty = true。 (当计算属性依赖于其他数据时,属性并不会立即重新计算,只有之后其他地方需要读取属性的时候,它才会真正计算,即具备 lazy(懒计算)特性。)
Computed 和 Watch 的区别
对于Computed:
- 它支持缓存,只有依赖的数据发生了变化,才会重新计算
- 不支持异步,当Computed中有异步操作时,无法监听数据的变化
- computed的值会默认走缓存,计算属性是基于它们的响应式依赖进行缓存的,也就是基于data声明过,或者父组件传递过来的props中的数据进行计算的。
- 如果一个属性是由其他属性计算而来的,这个属性依赖其他的属性,一般会使用computed
- 如果computed属性的属性值是函数,那么默认使用get方法,函数的返回值就是属性的属性值;在computed中,属性有一个get方法和一个set方法,当数据发生变化时,会调用set方法。
对于Watch:
- 它不支持缓存,数据变化时,它就会触发相应的操作
- 支持异步监听
- 监听的函数接收两个参数,第一个参数是最新的值,第二个是变化之前的值
- 当一个属性发生变化时,就需要执行相应的操作
监听数据必须是data中声明的或者父组件传递过来的props中的数据,当发生变化时,会触发其他操作,函数有两个的参数:
- immediate:组件加载立即触发回调函数
- deep:深度监听,发现数据内部的变化,在复杂数据类型中使用,例如数组中的对象发生变化。需要注意的是,deep无法监听到数组和对象内部的变化。
当想要执行异步或者昂贵的操作以响应不断的变化时,就需要使用watch。
总结:
- computed 计算属性 : 依赖其它属性值,并且 computed 的值有缓存,只有它依赖的属性值发生改变,下一次获取 computed 的值时才会重新计算 computed 的值。
- watch 侦听器 : 更多的是观察的作用,无缓存性,类似于某些数据的监听回调,每当监听的数据变化时都会执行回调进行后续操作。
运用场景:
- 当需要进行数值计算,并且依赖于其它数据时,应该使用 computed,因为可以利用 computed 的缓存特性,避免每次获取值时都要重新计算。
- 当需要在数据变化时执行异步或开销较大的操作时,应该使用 watch,使用 watch 选项允许执行异步操作 ( 访问一个 API ),限制执行该操作的频率,并在得到最终结果前,设置中间状态。这些都是计算属性无法做到的。
Vue 模板编译原理
Vue 的编译过程就是将 template 转化为 render 函数的过程 分为以下三步
第一步是将 模板字符串 转换成 element ASTs(解析器)
第二步是对 AST 进行静态节点标记,主要用来做虚拟DOM的渲染优化(优化器)
第三步是 使用 element ASTs 生成 render 函数代码字符串(代码生成器)
相关代码如下
export function compileToFunctions(template) {
  // 我们需要把html字符串变成render函数
  // 1.把html代码转成ast语法树  ast用来描述代码本身形成树结构 不仅可以描述html 也能描述css以及js语法
  // 很多库都运用到了ast 比如 webpack babel eslint等等
  let ast = parse(template);
  // 2.优化静态节点
  // 这个有兴趣的可以去看源码  不影响核心功能就不实现了
  //   if (options.optimize !== false) {
  //     optimize(ast, options);
  //   }

  // 3.通过ast 重新生成代码
  // 我们最后生成的代码需要和render函数一样
  // 类似_c('div',{id:"app"},_c('div',undefined,_v("hello"+_s(name)),_c('span',undefined,_v("world"))))
  // _c代表创建元素 _v代表创建文本 _s代表文Json.stringify--把对象解析成文本
  let code = generate(ast);
  //   使用with语法改变作用域为this  之后调用render函数可以使用call改变this 方便code里面的变量取值
  let renderFn = new Function(`with(this){return ${code}}`);
  return renderFn;
}
Vue-router 路由有哪些模式?
一般有两种模式:
 (1)**hash 模式**:后面的 hash 值的变化,浏览器既不会向服务器发出请求,浏览器也不会刷新,每次 hash 值的变化会触发 hashchange 事件。
 (2)**history 模式**:利用了 HTML5 中新增的 pushState() 和 replaceState() 方法。这两个方法应用于浏览器的历史记录栈,在当前已有的 back、forward、go 的基础之上,它们提供了对历史记录进行修改的功能。只是当它们执行修改时,虽然改变了当前的 URL,但浏览器不会立即向后端发送请求。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论