leetcode-82. 删除排序链表中的重复元素II
文章目录
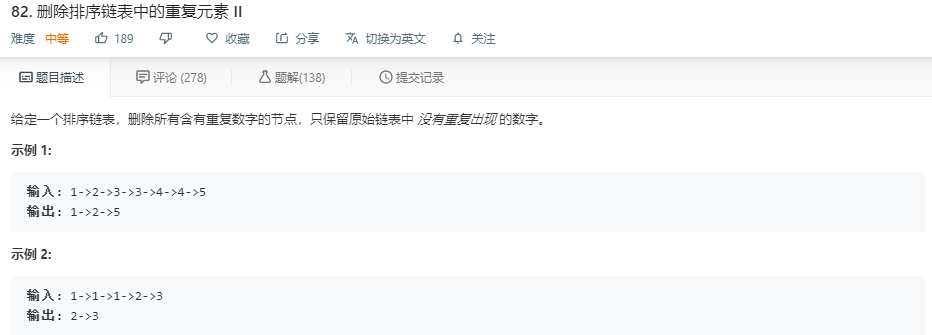
题目描述
解法分析
解法1
一上来当然是最直接的解法:
- 建立一个哑节点
- 遍历一遍,统计所有数字出现的位置
- 再遍历一遍,删除所有出现超过1次的元素
优点是:懒得深入思考,最直接。方法更通用。
缺点是:实现复杂,代码多,内存占用大,效率也不高
最重要的是我审题不严格,题目是排了序的链表,因此根本不需要这么麻烦,当然了如果是没有排序的情况下,我想我还是会用这个办法的。
class Solution {
public:
    ListNode *deleteDuplicates(ListNode *head) {
        ListNode *newHead = new ListNode(0);
        newHead->next = head;
        vector<int> duplicateIdxes;
        getDuplicateIdxes(head, duplicateIdxes);
        // 遍历vector,按照顺序删除节点
        ListNode* p = newHead;
        int nodeId = 1;
        int dupVecId = 0;
        while(p->next != nullptr && dupVecId < duplicateIdxes.size()) {
            if(nodeId == duplicateIdxes[dupVecId])
            {
                deleteNode(p);
                dupVecId++;
            }
            else{
                p = p->next;
            }
            ++nodeId;
        }

        return newHead->next;
    }

private:
    void getDuplicateIdxes(ListNode* head, vector<int>& idxes)
    {
        map<int, vector<int>> numIdxesMap;
        ListNode *p = head;
        int idx = 1;
        while (p != nullptr) {
            numIdxesMap[p->val].push_back(idx);
            ++idx;
            p = p->next;
        }

        for (auto&& item: numIdxesMap) {
            // 把所有数据放到vector中排序
            if (item.second.size() > 1) {
                for (auto&& idx : item.second) {
                    idxes.push_back(idx);
                }
            }
        }
        std::sort(idxes.begin(), idxes.end());
    }

    static void deleteNode(ListNode *postNode) {
        if(postNode && postNode->next) {
            ListNode* pTmp = postNode->next;
            postNode->next = postNode->next->next;
            delete pTmp;
            pTmp = nullptr;
        }
    }
};
解法2
既然是有序的,可以简单点:
- 依然先建立哑节点,链表必备。
- 定义
leftPre和rightPre,分别指向要比较的起始节点的前一个节点和起始节点的后一个节点的前一个节点。有点绕,为什么都是前一个节点呢,因为方便删除的时候操作。所以名字都叫xxPre。 - 使用快慢指针的方法遍历节点,发现重复的就删除。
这个解法写出来的代码我感觉思路最顺,代码也最整洁、好看。
class Solution {
public:
    ListNode *deleteDuplicates(ListNode *head) {
        if (!head) {
            return nullptr;
        }

        auto newHead = make_shared<ListNode>(0);
        newHead->next = head;

        ListNode* leftPre = newHead.get();
        ListNode* rightPre = head;

        while(rightPre && rightPre->next)
        {
            if (leftPre->next->val != rightPre->next->val) {
                leftPre = leftPre->next;
                rightPre = leftPre-> next;
            } else
            {
                while(rightPre && rightPre->next && rightPre->next->val == leftPre->next->val) {
                    deleteNode(rightPre);
                }
                deleteNode(leftPre);
                rightPre = leftPre->next;
            }
        }
        return newHead->next;
    }

private:
    static void deleteNode(ListNode *postNode) {
        if(postNode && postNode->next) {
            ListNode* pTmp = postNode->next;
            postNode->next = postNode->next->next;
            delete pTmp;
            pTmp = nullptr;
        }
    }
};
效率还不错
解法3(微重构)
在解法2的过程中,我意识到一个节点一个节点的删除是不是太慢,因为是排序的,如果重复且多个的话都是一连串的,是不是可以找到重复的头尾后一起删除。
所以我做了如下尝试
class Solution {
public:
    ListNode *deleteDuplicates(ListNode *head) {
        if (!head) {
            return nullptr;
        }

        auto newHead = make_shared<ListNode>(0);
        newHead->next = head;

        ListNode *leftPre = newHead.get();
        ListNode *right = leftPre->next->next;

        while (leftPre->next && leftPre->next->next) {
            right = leftPre->next->next;
            if (leftPre->next->val != right->val) {
                leftPre = leftPre->next;
            } else {
                while (right && leftPre->next->val == right->val) {
                    right = right->next;
                }
                deleteNode(leftPre, right);
            }
        }
        return newHead->next;
    }

private:
    // 删除 leftPre->next 到 right之前的节点
    static void deleteNode(ListNode *leftPre, ListNode *right) {
        ListNode *left = leftPre->next;
        while (left != right) {
            ListNode *pTmp = left;
            left = left->next;
            delete (pTmp);
        }
        leftPre->next = right;
    }
};
我发现比解法2还慢了2ms,分析应该是因为链表删除,我就算批量删除里面还是一个一个的删,如果是数组的话估计会快很多。
解法4(微重构)
虽然解法3是一次不太成功的尝试,但是局部代码的优化让我对于解法2的实现不是很满足,对于while循环可以做类似的优化,代码会更简洁并且易懂。
class Solution {
public:
    ListNode *deleteDuplicates(ListNode *head) {
        if (!head) {
            return nullptr;
        }

        auto newHead = make_shared<ListNode>(0);
        newHead->next = head;

        ListNode* leftPre = newHead.get();
        ListNode* rightPre = head;

        while(leftPre->next && leftPre->next->next)
        {
            rightPre = leftPre->next;
            if (leftPre->next->val != rightPre->next->val) {
                leftPre = leftPre->next;
            } else
            {
                while(rightPre && rightPre->next && rightPre->next->val == leftPre->next->val) {
                    deleteNode(rightPre);
                }
                deleteNode(leftPre);
            }
        }
        return newHead->next;
    }

private:
    static void deleteNode(ListNode *postNode) {
        if(postNode && postNode->next) {
            ListNode* pTmp = postNode->next;
            postNode->next = postNode->next->next;
            delete pTmp;
            pTmp = nullptr;
        }
    }
};
当时貌似还是比原来的解法2慢一点点。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论