Unicode 颜文字(emoji)格式和 Go 代码处理
文章目录
前几天时间测试同学在我们的前端输入了颜文字,之后软件就出 bug 了。借修 bug 机会我花了点时间学习了一下 Unicode 颜文字(emoji)的一些知识。本文记录我对 emoji 的一些认识,并且简单介绍一下我为此而做的一个 Go 语言颜文字提取库的用法。
Unicode 背景简介
我们大家都知道,为了标准化全世界所有文字的编码,诞生了 unicode。最早 unicode 的设计者们采用的是一个字(2 Bytes)来表示 unicode 值(UCS-2),以为总共 65536 个值就可以表示所有的字符了,也就是我们常见的 unicode 表示法 U+1234 。
然而汉字的博大精深(历史上的各种汉字实在是太多了)让 unicode 认识到了错误。很快,unicode 的编码空间就扩展到了21位(注意:略少于3个字节,但是实际上在内存中经常使用4字节存储,对应于 UCS-4)。在绝大部分的程序语言/软件中,使用等效的 uint32 类型就可以将 unicode 字符一一保存。
比如对应于 MySQL 的 utf8mb4 就是可以使用最大 4 个字节来保存 unicode 字符。我们的 bug 就是出在 DB 中,解决方法很简单,改成 utfmb4 就行了。
Emoji 编码格式简介
使用了3个字节来保存 unicode,这让很多刚接触 unicode 的程序员很容易误以为:那么一个字肯定不会超过 int32 类型了吧?从计算机程序的角度而言,确实如此。但是从文字和语言学的角度而言,一个字,其实在程序中并不一定仅对应着一个程序字符。
首先从传统的 unicode 字符而言,就存在着 "修饰字符" 和 “组合字符” 的概念,修饰字符和组合字符配合基本字符,可以组成一个我们从视觉上看到的单一字符。比如下面这个让你不会读的 a,是由五个 unicode 字符组成的;但在视觉和语言学角度上,这只是一个字:
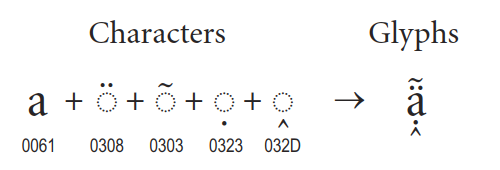
我们具体到 emoji 而言,也是类似的情况:一个视觉上的文字单元,在底层可能是由多个 unicode 字符所组成的。比如大家最经常拿来举例的、表示一家四口的文字 "👨👩👧👦"(<-- 如果你的浏览器看到的是四个分离的头像,那说明你的终端不支持 E2.0 版本 emoji),实际上在底层是由丧心病狂的七个 unicode 字符组成,分别为:U+1F468、U+200D、U+1F469、U+200D、U+1F467、U+200D、U+1F466。
如无特殊说明,下文采用 “字符” 一词表示一个 unicode 值,而 “文字” 一词则表示视觉上的一个单一文字。
当然,emoji 的连字规则并不是随意拼接、完全自由的。Unicode 标准里针对 emoji 也规定了几种格式。下面以本文成文时最新的 unicode 13.0(2020-01-28 发布)说明如下:
基本 emoji
这里对应着Emoji Sequences 标准书的 “Basic_Emoji” 小节,其中每一行后面都包括了该字符被引入的标准版本。如果读者在哪一行看到了方块,那就说明你的系统不支持该版本。基本 emoji 字符包含了两种类型:
- 单一 unicode 字符所组成的一个视觉字符。按照 unicode 的规定,终端在展示这些文字时,默认应该以颜文字版(也就是彩色动态版)进行展示。
- 以单一 unicode 字符,后接
U+FE0E或U+FE0F所表示的一个文字。其中如果后加U+FE0F,则与上一规则相同,表示以颜文字模式展示。如果以U+FE0E,则表示以 text 黑白文本模式展示该文字(但实际上不少终端压根不理这条规则,亦或者是支持不完全)。
并不是所有的基本 emoji 字符都包含两种显示模式,应按照 unicode 标准中列出的组合为准。总共有 1329 个组合。
Emoji 键帽序列(Emoji Keycap Sequence)
这里对应着Emoji Sequences 标准书的 “Emoji_Keycap_Sequence” 小节,这一类序列总共有12组,这里其实就对应着电话上的12个按钮,分别是 0~9 十个字符,外加 # 和 * 开头,然后后面紧跟着 U+FE0F 和 U+20E3 两个字符组成的。比如我们可以很方便地摆出一个电话键盘出来:
1️⃣2️⃣3️⃣
4️⃣5️⃣6️⃣
7️⃣8️⃣9️⃣
*️⃣0️⃣#️⃣
Emoji 国家/地区旗序列
这里则对应着Emoji Sequences 标准书的 “RGI_Emoji_Flag_Sequence” 小节。其中 RGI 表示 Recommended for General Interchange,推荐可在日常的交互/交流中使用。
这一组文字均由两个 unicode 字符组成,字符的值为 U+1F1E6 到 U+1F1FF 的26个字符,一一对应着 A 到 Z。这一组 unicode 文字对应着使用两个字母的国家/地区码所对应的国家/地区旗帜,以及用 UN 表示的联合国旗和 EU 表示的欧盟旗。
合法的旗帜总共有 258 个组合,标准中完整地列出了。需要注意的是,U+1F1E6 到 U+1F1FF 这26个字符不能单独出现,它们是专门用于这一类旗帜所使用的特殊 unicode 字符。
国家/地区码可参见 ISO 3166-1。
Emoji 标记序列
这一组其实是 unicode 预留的扩展类别,虽然在 emoji 中定义了所谓 “tag latin letter” 用于此类别,但是目前只有三个合法文字,从展示效果上分别是 英格兰、苏格兰、威尔士旗帜(北爱尔兰:喵喵喵?)。而 “tag” 字符也是不单独出现的。
打趣一下,以英格兰旗为例,七个字符分别为:U+1F3F4 U+E0067 U+E0062 U+E0065 U+E006E U+E0067 U+E007F,分别对应以下含义:
- 黑色旗帜
- 拉丁字母 g
- 拉丁字母 b
- 拉丁字母 e
- 拉丁字母 n
- 拉丁字母 g
- DELETE 字符
难道这意思是:“黑化的英国英格兰(划去)” ?
Emoji 修饰符序列
Unicode 定义了五个用于 emoji 的肤色字符,分别是:U+1F3FB U+1F3FC U+1F3FD U+1F3FE U+1F3FF,在 unicode 标准中分别表示:
- light skin tone
- medium-light skin tone
- medium skin tone
- medium-dark skin tone
- dark skin tone
用于与部分基本 emoji 经字符搭配,用于调整相应文字中的肤色。常用在需要西方式 “政治正确” 的场合。
这五个字符按照标准而言是不会单独出现的,必然是跟在一个基本 emoji 后面。这对应着Emoji Sequences 标准书的 “RGI_Emoji_Modifier_Sequence” 小节。
Unicode 总共定义了 580 个 modifier sequences,也就是说有 116 个基本 emoji 字符可以搭配肤色字符使用。
Emoji ZWJ 序列
ZWJ 也即 Zero Width Joiner,也就是零宽度连接符。ZWJ 的 unicode 代码为 U+200D,它不会被显示出来。它的作用是用于连接两个 unicode 字符,组成可视的文字。前文所述的 “👨👩👧👦” 文字,就是使用 ZWJ 将一个男人头像、一个女人头像、一个男孩头像、一个女孩头像连接起来的文字。
并不是所有的 emoji 都可以任意连接。Unicode 定义了 1122 个 Emoji ZWJ 序列类型的文字。在 Emoji ZWJ Sequences 标准书可以查阅完整的列表。
在 Go 中提取 unicode emoji 文字
通过前文描述,我们如果需要从一段 string 中一个个提取出单一、独立的一个个 emoji 文字(注意是文字而不是分离的 unicode 字符),那么我们其中的一个思路,就是按照前文的几种规则,对 unicode 字符串中的每一个子串进行检查,看是否会出现符合 emoji 规则的子串。
目前我在 Github 上看到有一个 emoji 提取库用的是正则表达式的方法来提取出字符串中的 emoji 段落。但是这个库太慢、太老了(2015年),而且并不支持 ZWJ 序列。于是我自己写了一个。
基本原理其实很简单。让我们看看 unicode 官方的两个主要文档 Emoji Sequence 和 Emoji ZWJ Sequence 可以看出,实际上官方已经把全部合法的、可以组成单一 emoji 文字的 unicode 组合序列全部列出来了。因此,我们只需要将这两个文件的全部序列导出来,然后在匹配字符串的时候,按照导出来的结果进行匹配就可以了。
我的代码中,将所有合法的序列全部导出成为一棵树。当检查字符串子串的时候,匹配树中所代表的合法的子串就可以了。示例代码如下:
package main
import (
"log"
"fmt"
"github.com/Andrew-M-C/go.emoji"
)
func main() {
printf := log.Printf
s := "👩👩👦🇨🇳"
i := 0
final := emoji.ReplaceAllEmojiFunc(s, func(emoji string) string {
i++
printf("%02d - %s - len %d", i, emoji, len(emoji))
return fmt.Sprintf("%d-", i)
})
printf("final: <%s>", final)
return
}
// Output:
// 2009/11/10 23:00:00 01 - 👩👩👦 - len 18
// 2009/11/10 23:00:00 02 - 🇨🇳 - len 8
// 2009/11/10 23:00:00 final: <1-2->
参考资料
- 转-写给程序员的 Unicode 入门介绍
- 简单来谈谈Unicode与emoji
- Emoji, 没想到你是这样的...
- “组合字符”和“修饰字母”有什么区别?
- Unicode® 13.0 Emoji
- emojipedia
- 空白修饰字母 Unicode字符表
- 修改MySQL的字符集为utf8mb4
本文章采用 知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议 进行许可。
- 原作者: amc,欢迎转载,但请注明出处。
- 原文标题:Unicode 颜文字(emoji)格式和 Go 代码处理
- 发布日期:2020-03-21
- 原文链接:https://cloud.tencent.com/developer/article/1602547。

评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论