paper | 时空大数据管理 | 2018-SIGMOD-DITA
文章目录
论文题目:DITA: Distributed In-Memory Trajectory Analytics
- 作者|单位:Zeyuan Shang, Guoliang Li | Tsinghua University
- 发表时间:2018年
- 期刊/会议:SIGMOD
- 原文地址:https://shangzeyuan.com/stati...
1. DITA简介
DITA是一种支持多种轨迹相似性算法查询和Join的新框架。
2. 轨迹相似性算法简介
以DTW相似性算法为例:
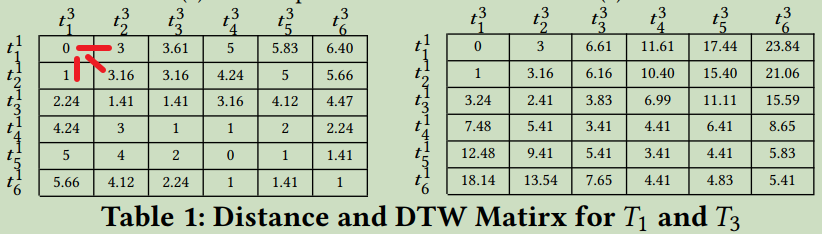
轨迹相似性算法是NP-Hard问题,因此只能采用近似计算方法。
3. 本文算法
3.1. 轨迹简化与轨迹对齐
- 提出了三种轨迹简化的算法,主要思想是提取轨迹的K个关键点
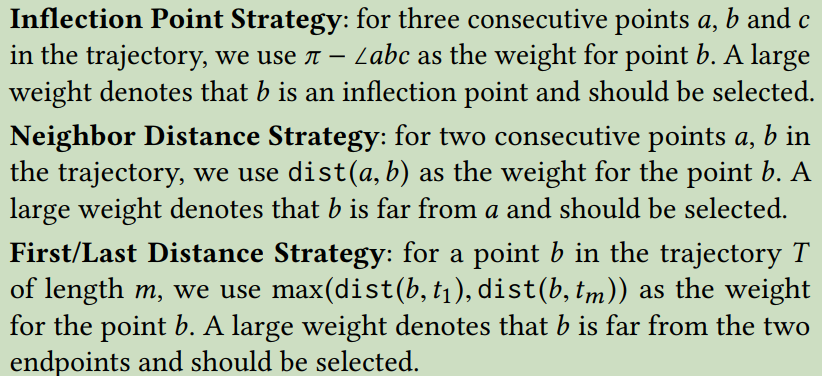
- 轨迹对齐
每个轨迹提取了K个关键点,所以裁剪后的轨迹点数量一致,最终轨迹组成first Point+last Point+K个关键点,共K+2个点; - 3.2. 全局索引与本地索引
分区:使用所有轨迹的first points做第一次切分,生成N个分区;再在每个分区内根据last Points 做第二次切分,生成N个分区;共生成N*N个分区。
全局索引:在每个分区中会生成两个MBR:所有轨迹第一个点的MBR,所有轨迹最后一个点的MBR;当一条轨迹与两个MBR的距离都小于阈值时,则该轨迹分到此区。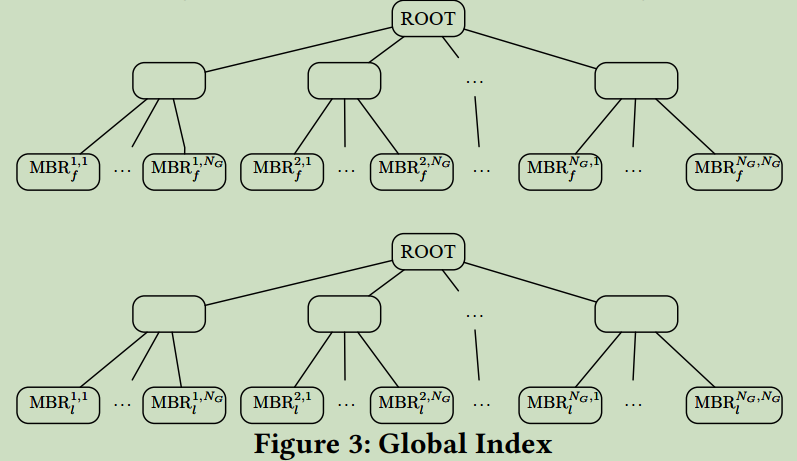
本地索引:生成了K+2层的本地索引,每一层都使用相同位次的轨迹点集合MBR划分。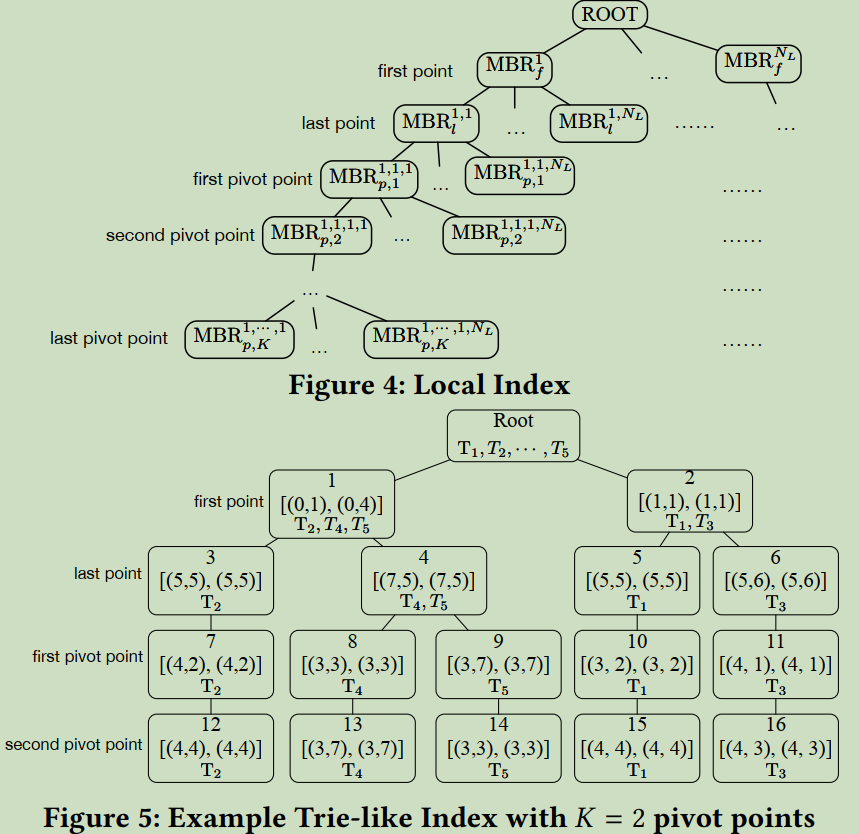
- 3.3. 查询算法
扩展MBR过滤:将查询轨迹MBR四个方向向外各扩展T(阈值)的宽度,生成EMBR;然后遍历轨迹集的轨迹,如果轨迹的MBR与EMBR不相交就过滤,相交的进入候选集;
Cell过滤:对候选集进行Cell过滤;将每个轨迹点转化为一个cell,将点与点的距离计算转化为cell距离计算。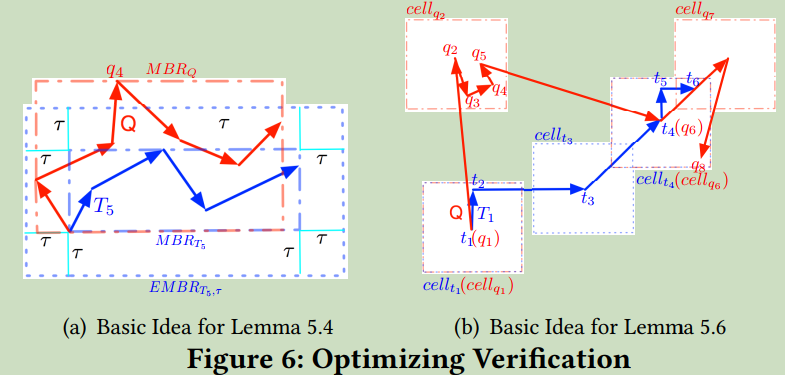
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论