编写可读性代码的艺术--万字总结,看到即学到
文章目录
编写可读性代码的艺术
最近阅读了《编写可读代码的艺术》一书,感觉很有收获,现在结合自己的理解再来总结编写可读性代码的技巧,会用 js 举例,并且针对日常开发中常见的代码异味给出改我的进建议。
学会该书的大部分技巧并付诸实践,不能保证保证你写出完美的代码,但是能保证你写出能读的代码,保证你的码德下限。
可读性 = 可测试性 = 设计良好 = 可维护 = 代码质量 = ...,衡量代码的各种指标,都是正相关的,开发程序的大部分时间是在阅读代码(自己的和他人的),所以保证了可读性,其他指标也不会差。
衡量代码的可读性
大部分程序员,全靠自觉、灵感和经验编写代码,往往很难一步到位写出可读性高的代码。
我看过一些前端组长(猪长)、前端架构师(加狗屎)写的代码,简直惨不忍睹,让人有骂娘的冲动。
比如这种: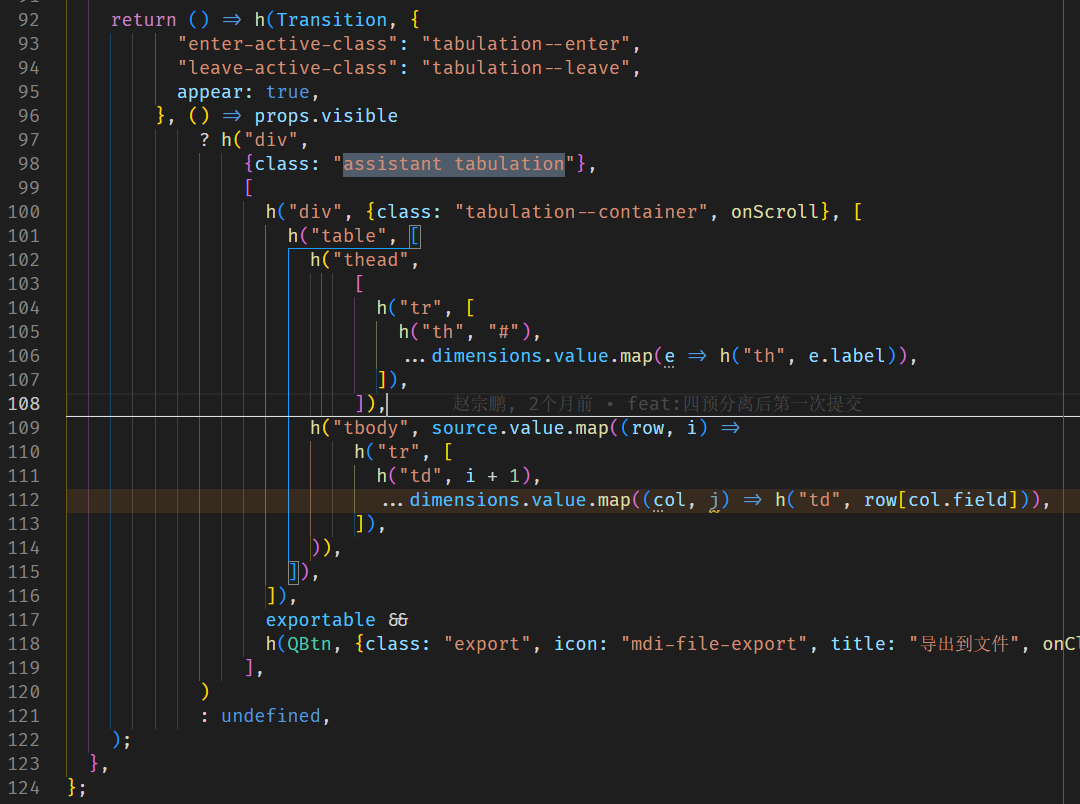
除了手写 render 函数,毫无可读性之外,行宽过大,编辑器都出现滚动条了,也会让人不想读。
不可读的代码往往都会有这样或那样的问题。
软件的成本由开发成本和维护成本组成,而往往维护成本要远高于开发成本,维护成本主要花在理解代码和修改代码上,可读性高、设计良好的代码可大大降理解和修改代码的成本。
可见代码的可读性至关重要。
如何衡量代码的可读性呢?
代码可读性和代码被他人理解的时间成正比,即他人理解代码的时间越少,可读性越高。
如何定义他人?根据我的经验,高年级本科生或者研究生或者工作 2 年内的程序员,又或者,你的一个普通同事。
同事是和你协作的人,让和你协作的人能快速地理解你的代码,至关重要。
如何定义理解?
理解是一个非常高的标准。真正理解了,就应该能改动它、找出缺陷且明白它与外部代码交互的规则。
可读性的标准可以降低吗?
当可读性和其他约束条件冲突时,比如性能、代码行数,如何取舍?
大部分情况,可读性优先,那些可能会经常被他人阅读、改动的代码,可读性再怎么强调都不为过。
编写可读性的代码很难吗?
编写可读性高的代码很难。如果一个程序员放弃了可读性这一目标,那么他一定不会成为更好的程序员。
编写可读性高的代码,前人已经总结了诸多技巧和经验,学习并实践这些经验,可以让代码的可读性不至于很糟糕。
命名的技巧
好的代码,从好的命名开始。
把信息放在名字里
选择专业的词汇,使得意思更加清晰和精确。
比如 fetchData 比 getData 好;
| 单词 | 更多的选择 |
|---|---|
| send | deliver、dispatch(派发)、announce(声明)、distribute(分配、广播)、route(按照指定路径投送) |
| find | search、extract(提取)、locate(定位)、recover(还原) |
| start | launch、create(创建)、begin、open |
| make | create、setup(就绪)、build、generate(生成)、compose、add、new |
技巧:如果存在两个相对或者相反的操作,取名使最好能让他人知道一个,便能直接的猜到有一个操作。
start 和 stop 相对, pause 和 resume 相对。
技巧:取名符合生活或者数学的习惯。比如count一般为正数,num使可正可负,complexNumber复数。
避免宽泛的名字,除非有特别的理由
避免使用 tmp 、 retval 这类宽泛的名字。好的名字应该描述变量的目的或者它承载的值, tmp_file 比如 tmp 好。
const euclidean_norm = arr => {
  let retval = 0
  for (let i = 0 i < arr.length; i++) {
    retval += arr[i] * arr[i]
  }
  return Math.sqrt(retval)
}
这函数在累加数组中元素的平方,把
retval改成sum_squares更好。sum_squares 包含它的目的,如果累加代码不小心写成
retval += arr[i],就非常容易发现缺陷。使用 tmp、it 和 retval 等这些空范的名字时,你需要有足够好的理由。
使用具体的名字,避免抽象的名字
力求把实体描述得更具体,而非抽象,越具体,会越明确。serverCanStart() 没有 canListenOnPort 具体。
技巧:名字里名字和形容词时,会比较具体。感觉不够具体时,不妨加入名字和形容词。
使用前缀或者后缀把重要的信息附加到名字上
常见的可以附加的信息:
<br/>
① 单位
| 函数参数 | 参数带单位 |
|---|---|
| start(delay) | delay -> delay_secs |
| createCache(size) | size -> size_mb |
| throttleDownload(limit) | limit -> max_kbps |
| rotate(angle) | angle -> degrees_cw |
angle 角度,单位度。cw(circular_measure),弧度。
在一个项目遇到一个函数的参数对象属性为 rotate :
someFunction({
  rotate: rotate_value
})
它接收一个从后台接口返回的值,采用的单位是度,产品经理一直说不对,但是我们也找不到问题,就把这个问题放了很久。产品经理有一天又去找人确认是否正确,给的答复没问题。<br/> <br/>
产品又来找我,说那边反馈数据对的。我才猛然想到采用的单位是不是弧度,于是我把角度转成了弧度,产品就说对了。如果给属性加上单位,那么就一眼看出来了。
我们这个项目还涉及角度的方向,最后几经测试,需要做两件事情:角度转为弧度;三维地图下,旋转方向为逆时针。
把单位加入参数。
someFunction({
  route_cw: cw_value // 顺时针的弧度 anticlockwise/counterclockwise 逆时针
})
如果把三维地图下逆时针也加入,参数就长了,选择不加,可通过函数注释的方式告知使用者。
② 变量存在危险或者意外
| 情形 | 变量 | 更好的选择 |
|---|---|---|
| 纯文本的密码 | password | plaintext_password |
| 用户提供的注释,需要转义后才能显示 | comment | unescaped_comment |
| 安全的 html 代码 | html | html_safe\ html_escaped |
变量作用域大小决定名字长短
小作用域,使用段名字,大作用域,使用长名字。
const numList = [1, 2, 3]
let sum = 0
for (let i = 0; i < array.length; i++) {
  sum += array[i];
}
i 的作用域很小,即使取名很短,也一眼能看出它的目的。
再看一例:
for (i = 0; i < clubs.size(); i++) {
  for (j = 0; j < clubs[i].members.size(); j++) {
    for (k = 0; k < users.size(); k++) {
      // do something
    }
  }
}
i j k 的作用域也很小,但是这里涉及到多层嵌套,当嵌套里操作复杂时,就很容易混淆它们,此时可以适当让各自的下标变长,以做区分。
for (club_i = 0; club_i < clubs.size(); club_i++) {
  for (member_i = 0; member_i < clubs[club_i].members.size(); member_i++) {
    for (user_i = 0; user_i < users.size(); user_i++) {
      // do something
    }
  }
}
长名字不好打,而不使用?
有人会因为长名字需要输入更多字符而不想使用,现在而 IDE、AI 编程助手已经能自动补全了,不存在这个问题。
避免随意缩写,造单词。
随意缩写很让人费解。
技巧:开启编辑器拼写检查,可防止写错单词。
众所周知的缩写是可以使用的,比如
# 名词和形容词
button -> btn
background -> bg
backgroundColor -> bgColor
image -> img
document -> doc
string -> str
number -> num
evaluation -> eval
index -> i
column -> col
hexadecimal -> hex
binary -> bin
octal -> oct # 八进制
decimal -> dec # 十进制
to -> 2 # to 在中间可,可缩写为 2, 比如 bin2dec 二进制转为十进制
address -> addr
application -> app
average -> avg # 平均数
command -> cmd
organization -> org # 组织
original -> orig
destination -> dest/des
resource -> res # 资源
source -> src # 源数据
ascending -> asc # 升序
descending -> desc # 降序
device -> dev # 设备
different -> diff # 区别
directory -> dir # 目录
environment -> env # 环境
error -> err
library -> lib # 库
information -> info # 信息
message -> msg
number -> num
object -> obj
parameter -> param
parameters -> params # 实参 参数
arguments -> args # 实参 参数
argument -> arg # 形参 参数
package -> pkg # 包 n 打包 v
position -> pos # 位置
configuration -> config # 配置
array -> arr
previous -> pre
next -> next
middle -> mid # 中间
current -> cur # 当前的
password -> pwd
reference -> ref
summation -> sum
system -> sys # 系统
temporary -> temp # 临时 或者 tmp
text -> txt # 纯文本
variable -> var
character -> char
status -> stat # 状态
standard -> std # 标准
trigger -> trig # 触发
user -> usr # 用户
length -> len # 长度
administrator -> adm # 管理员
database -> db # 数据库
coordinates -> coord # 坐标
longitude -> lng # 经度
latitude -> lat # 维度
angle -> ng # 角度
circularMeasure -> cw # 弧度
dictionary -> dic # 字典
link -> lnk # 链接
window -> win/wnd # 窗口
horizontal -> horz # 水平
public -> pub

# 动词
delete -> del
decrease -> desc # 减少
increase -> inc # 增加
increment -> inc # 增加
execute -> exec # 执行
maximum -> max # 最大
minimum -> min # 最小
calculate -> calc
initialization -> init # 初始化的
initialize -> init # 初始化
generate -> gen # 生成
synchronization -> sync
asynchronization -> async
control -> ctr # 控制
escape -> esc # 退出
insert -> ins # 插入
extend -> ex/ext # 扩展
vertical -> vert # 垂直
instance -> ins # 实例
multiply -> mul # 乘
禁止拼音缩写
拼写的缩写意思很多。
# 书本
shuBen -> sb
# 想表示 book,却变成傻逼
# 价格
jiaGe -> jg
# 想表示 price,却变成鸡哥
使用缩写的经验法则:当新成员能理解这个缩写时,即可使用。
删除没用的词
拿掉某个词,不会损失信息,就删除它。
比如
convertToStr -> toStr # 意思一样
doStop -> stop #
有多个意思一样的动词,往往只需保留一个。
使用格式表示含义
把特定的格式放在变量里,使得一眼能看出不同变量的区别。
常用的格式有: _ 、 - 、 # 、 $ 和 大小写 等。
const YYYYMMDD = '2023-03-23' // 这个变量,就能一眼推断出表示一个时间遵循编程语言或者团队的约定,且保持一致。
对前端来说,构造函数使用大坨峰(PascalCase/UpperCamelCase),普通函数使用小驼峰(lowerCamelCase)。
const person = new Person()
const age = getAge()
jquery 对象使用 $ 开头,事件处理器使用 onXxx 或者 handleXxx
技巧:onXxx作为属性或者参数,而handleXxx作为函数,会更好。
const $allImages = $('img')DOM 的 ID 属性值使用 _ 连接,类名使用 - 或者 -- 。
<span class="icon-container" id="icon_edit"></span>vue 和 react 组件中: _ref 表示模板引用:
const div_ref = ref() // 表示引用一个 div
const com_ref = ref() // 表示引用一个 组件
不要使用有歧义的名字
名字容易歧义吗?当命名时,多问问自己,主动找到可能歧义的词语。filter 就是一样容易有歧义的词语,可以是挑出一些,也可以是删除一些,剩下一些。
用 min 和 max 表示极限
const CART_TOO_BIG_LIMIT = 10 // 购物车最多10个物品
const MAX_ITEMS_IN_CART = 10 //  ✅  better
用 first 和 last 表示包含末尾
const str = 'abcd' // first = 0 last = 3 包含 d用 start/begin 和 end 表示不包含末尾
const str = 'abcd' // start = 0 end = 3 不包含 d更好地给变量加否定前缀
英文中表示否定前缀的有很多,比如 un 、 de 、 dis ,如何选择呢?
| 前缀 | 后缀 | 描述 | 例子 |
|---|---|---|---|
| non | 名词、动词、形容词 | 表相反的意思 | editedRows->nonEditedRows |
| de | 动词 | 表相反的动作 | encodeURIComponent->decodeURIComponent |
| un | able 结尾的形容词或者一动词 | founded->unfounded known -> unknown |
non 最通用,搞不清楚,一律 non 就行了。
给布尔变量命名
当命名布尔变量或者返回布尔值的函数命名时,要确保阅读者一眼明确(返回)值的范围是 true 或者 false 。
const read_password = true // bad ❌ 两种理解:1. 读取密码,动作 2. 已经读取了密码
const need_password = true // ok 👌
const has_password = true // best  ✅
const edit = true // bad ❌
const shouldEdit = true // ok 👌
const enableEdit = true // better 😄
const canEdit = true // best ✅通过使用is、can、should、enable和has前缀或包含表示布尔变量。
这些词在英语中常常使用来引导疑问句,而疑问句的回答一般是 yes 或者 no ,对应 true 或者 false 。
| 前缀 | 常见的搭配 | 描述 | 例子 | 补充 |
|---|---|---|---|---|
| is | is + 形容词 | 是否具备某种属性或者状态 | isOk、isHidden | 单独的形容词,也能猜到是布尔变量,但是不够明确,比如 hidden、sortable |
| is | is + 动词过去式 | 是否完成了某个动作或者某件事 | isConnected、isFilled、isSorted | |
| is | is + 名词 | 是否是某个东西 | isAdmin、isVIP、isEditing、isProUser | |
| has | has + 名字 | 是否存在某物 | hasKey、hasError、hasOnlineUser | 名字一般使用单数,复数也无伤大雅 |
| can | can + 动词原型 | 是否启用某种能力 使其具备某种功能 | canEdit、canRemove | |
| enable | enable + 动词原型 | 是否启用某种能力 使其具备某种功能 | enableEdit、enableLoad | 还能用于命名函数 |
| should | should + 动词原型 | 是否执行某个操作,一般用于命名函数 | shouldRemoveBlank、shouldFillTable |
不关注数量。全部、所有,使用 every 或者 each, 比如 isEachUserActive,isEveryOrderClosed,存在至少一个,搭配 some、any 或者 has, 比如 isSomeUserLogin、isAnyUserOnLine、hasOnlineUser。
或者直接使用复数,虽然英文语法错误,但是无伤大雅,比如 isOrdersClosed。不要使用 are。
// `is` + 形容词 或者直接形容词,具有某写属性
// `is` + 动词过去式,表示完成了某个都行 做完xxx
const isGood = true //
const good = true // ok 👌 但是不够明确
const isFinished = true
const sortable = false // ok
const isSorted = true // ok
const hidden = true // ok
// `is` + 名字 表示是不是某个东西
const isSon = true
const isRiver = true
// 名词 + `is` + 形容词
const orders_is_closed = true
// 也可以 `is` + 名词 + 形容词
const isOrdersClosed = true

// `has` + 名词 存在某些东西
const hasKey = true // 存在 key
const hasValue = true // 有值

// `should` + 动词原型 是否需要执行某个动作
const shouldCloseDB = true
// `can` + 动词 具备某种能力
const canEdit = true // 有编辑权限
// `enable` + 动词, 表示是否开启某种能力 是具备某个能力
const enableEdit = true
const enableRemove = true
应该关注人称、单复数和时态的变化吗?
只需要关注动词时态,动词和 has 、 is 搭配,使用过去式就行,和 should 、 can 和 enable 搭配,使用原型。
技巧:should 往往用来命名返回布尔值的函数。
function shouldRemoveBlank(remove) {
  //
}
避免使用反义
不使用反义的词,比如 no 、 not 、 disabled 、 never 、 won't 和 dont ,因为含有反义,容易有双重否定,认知负担大。
const hasNoValue = arr.length === 0
// bad ❌
if (hasNoValue) {
  // do something
}
if (!hasNoValue) {
  // 不是没有值,产生双重否定
  // do something
}
改成这样,更加容易理解,因为不会产生双重否定:
// ok 👌
const isEmpty = arr.length === 0
if (isEmpty) {
  // do something
}
数组为空,执行条件,也符合直觉:
// best ✅
const hasValue = arr.length > 0
if (!hasValue) {
  // do something
}
没有值时,执行条件,非常自然。
全称变量和存在变量的命名
数学上表示所有的的量词叫我全称量词,表示存在的量词叫存在量词。如何命名呢?
举例说明:
// 全称变量 对应数学上的全称量词
const isUsersActive = users.every(user => user.isActive) // ❌ 英文语法错误  is 和复数搭配了, 模糊
const areUsersActive = users.every(user => user.isActive) // ❌ 自定义前缀
const isEachUserActive = users.every(user => user.isActive) // ✅ better 语法正确
const isEveryUserActive = users.every(user => user.isActive) // ✅ best 语法正确 every 符合 every 函数的语义
// 存在量词
const isUsersActive = users.some(user => user.isActive) // ❌ 英文语法错误 is 和复数搭配了, 模糊
const isAtLeastOneUserActive = users.some(user => user.isActive) // ❌ 太长
const isOneUserActive = users.some(user => user.isActive) // ❌ 只有一个,和语义不符
const isAnyUserActive = users.some(user => user.isActive) // ✅ better
const isSomeUserActive = users.some(user => user.isActive) // ✅ best 语法正确 some 还反映到 some 语义上取反的情况
const isAnyUserOffline = users.some(user => !user.isOnline)

if (isAnyUserOffline) {
  // 有人离线
}
// 使用 every
const isEveryUserOnLine = user.every(user => user.isOnline)
if (!isEveryUserOnLine) {
  // 不是每个人都在线
}
第一种更加好理解,而且数据量大的时候,性能更好。
如果可能,布尔变量的默认值为 false ,尤其是在函数参数中。很多 html 的属性就是这样的。
autofocus
checked
disabled
readonly
required
selected
draggable
formnovalidate
nowrap
参考
Naming guidelines for boolean variables<br/>
why-am-i-seeing-more-boolean-naming-conventions-where-is-is-used-as-the-first<br/>
Tips on naming boolean variables - Cleaner Code
采用使用者的期望的名字
有些名字之所以会让人误解,是因为人们对它们的含义有先入为主的印象,就算你的本意并非如此。此时,你最好放弃这个名字,而采用一个不会被误解的名字。
<br/>
很多程序员都习惯了使用 get* 作为轻量访问器的用法,它只是简单的返回一个内部成员变量,如果违背了这个习惯,就会误导使用者。
class StatisticCollector {
  addSample(x) {
    //
  }
  getMean() {
    // 遍历所有的 samples 返回平均数
  }
}
上述例子中, getMean 的实现是遍历所有数据,然后求和,就个数,再求平均。如果有大量数据,就有很大的代价。但是使用者会以为没有什么代价,就随意调用。 computeMean 或者 calcMean 就个更加好,它更想有代价的操作。
然而,很多英语单词是多义的,要做到不让人误解或者误用,很难,很多程序员不是英语母语者,更加难了。好在我有一个做法,可以缓解它:
经验做法:不希望被频繁使用的变量,采用长一点的名字,难书写的名字,可以降低这个变量的使用频率。
比如 vue3 的 getInstance ,就是一个不那么常见的名字,vue3 的开发者们不希望使用者频繁使用它。
美观的格式
好的代码在格式上应该具备美观的排版、合理的留白和符合认知的顺序。这一节探讨如何使用留白、对齐和顺序,让代码更加易读。
<br/>
<br/>
排版的三原则:
<br/> 01. 使用一致的布局,让读者快速习惯这种风格;<br/> 02. 让功能相似的代码排版相似;<br/> 03. 代码按照一定的逻辑分组,形成代码块。<br/>
为什么美观非常重要?
有一个类:
class StackKeeper {
  // A class for keeping track of a series of doubles
  add(d) {
    /*
        and methods for quick statistics about them.
       */
  }
  _minimum = 10
  /* how many so
     for
     */
  average() {}
}
相比一个整洁的版本:
// A class for keeping track of a series of doubles
// and methods for quick statistics about them.
class StackKeeper {
  add(d) {}
  _minimum = 10 // how many so for
  average() {}
}
你需要更多的时间去理解排版混乱的版本。
编程的大部分时间花在阅读代码上,阅读得越快,理解越快,代码越容易使用。
让代码变得难以阅读的手段之一:加入无关的混乱的注释,让代码排版混乱是常用的手段,希望你不要采用。
让换行保持一致和紧凑
有一个类 TCPConnectionSimulator ,评估程序在不同网络速度下的行为,构造函数有 4 个参数:
网速 -- kbps
平均时延 -- ms
时延抖动 -- ms
丢包率 -- %
调用三个不同的实例:
class PerformanceTester {
  wifi = new TCPConnectionSimulator(
    500, /*kbps*/
    80, /*millisecs latency*/
    200, /*jitter*/
    1 /*packet loss  %*/ )
  t3_fiber =
    new TCPConnectionSimulator(
      45000, /*kbps*/
      10, /*millisecs latency*/
      0, /*jitter*/
      0 /*packet loss  %*/
    )
  cell = new TCPConnectionSimulator(
    100, /*kbps*/
    400, /*millisecs latency*/
    250, /*jitter*/
    5 /*packet loss  %*/
  )
}
t3_fiber 后的换行很突兀,违背了相似的代码看上去也要相似,且参数的注释产生了更多换行,很不美观。
调整一下:
class PerformanceTester {
  // new TCPConnectionSimulator(throughput,latency,jitter,packet_loss)
  //                               [kbps]    [ms]   [ms]   [percent]
  wifi = new TCPConnectionSimulator(500, 80, 200, 1)
  t3_fiber = new TCPConnectionSimulator(45000, 10, 0, 0)
  cell = new TCPConnectionSimulator(100, 400, 250, 5)
}
把注释都放在上面了,更加紧凑,参数排成一行,参数像表格一样,看上去像一个紧凑的表格。
需要时使用列对齐
整齐的变和列可快速浏览,而且很容易发现代码中的拼写错误,因为排整齐了,就有了对比。
把参数调用排整齐。
checkFullName('Doug Adams', 'Mr. Douglas Adams', '')
checkFullName(' Jake Brown', 'Mr. Jake Brown III', '')
checkFullName('No such Guy', '', 'no match found')
checkFullName('John', '', 'more than one results')
因为我的编辑器做不到这一点,可看图片的而情况:

应该使用列对齐吗?
列对齐给代码提供了可见的边界,也符合让功能相似的代码看起来也相似。
<br/>
<br/>
但是有些程序员不喜欢,主要两个原因:
<br/> 01. 列对齐,有的编辑器不支持; <br/> 02. 列对齐会导致额外的改动,让代码的历史记录变得混乱。<br/>
经验法则:列对齐不必强求,保证项目成员之间一致即可。
让代码的排序有意义
要是代码的顺序不影响功能,不要随机的排序,而是选一个有意义的顺序,让认知负担更小。
<br/>
常见的有意义的排序: <br/>
- 对象中的 key 的顺序和 html 中表单的顺序一致;<br/>
- 使用者最关心的在前,不太关心的在后,比如 css 属性;<br/>
- 必需的在前,可选的在后,比如后端接口验证前端提交的数据;<br/>
- 和代码的生命周期一致,有些代码有生命周期,比如 vue 组件,调用这些声明周期钩子函数时,最好按照生命周期的顺序调用;<br/>
按照字母排序。
<br/>
<br/>
以第二条排序建议为例,看看顺序是如何影响可读性的:
.page {
  flex-direction: column;
  box-shadow: 0 1px 5px 0 rgb(0 0 0 / 0.2), 0 2px 2px 0 rgb(0 0 0 / 0.14),
    0 3px 1px -2px rgb(0 0 0 / 0.12);
  flex: 1;
  display: flex;
  align-items: center;
}
这一个段 css 代码,有一点前端开发经验的人,就会发现属性的出现顺序非常奇怪: display 和 flex-direction 相关的属性,中间却多了一个 box-shadow ,display 的值为 flex 时,flex 相关的属性才会生效,但是 flex-direction 却在最前面,很费解。
在阅读 css 代码时,我们关注的顺序是:定位 -> 尺寸 -> 动画 -> 字体 -> 背景 -> 其他,因为这些属性的顺序对布局影响依次减弱。
按照这个顺序,重新排版上面的代码:
.page {
  display: flex;
  flex: 1;
  align-items: center;
  flex-direction: column;
  box-shadow: 0 1px 5px 0 rgb(0 0 0 / 0.2), 0 2px 2px 0 rgb(0 0 0 / 0.14),
    0 3px 1px -2px rgb(0 0 0 / 0.12);
}
这样就好理解多了,可以快速知道哪些属性影响了页面的布局。
关于 css 属性顺序的最佳实践:使用 stylelint 的stylelint-order插件让属性的顺序按照对布局的影响大小排列。
在看一个 js 例子:
import hoverIntent from 'hoverintent'
import {
  ref
} from 'vue'
type InAndOut = {
  in ? : (target: HTMLElement) => void
  out ? : (target: HTMLElement) => void
}
const options = {
  in: target => undefined,
  out: target => undefined,
}
/**
 * 鼠标移入移出 hook,可设置鼠标停留时间。
 * 为何不使用 hover 事件:hover 事件瞬间触发,不能设置停留时间
 * @param target 目标元素
 * @param inAndOut 移入移除回调
 * @param inAndOut.in 移入回调
 * @param inAndOut.out 移出回调
 * @param updateTarget 是否更新 hover 的目标元素
 * @param opts hoverIntent配置
 * @link https://www.npmjs.com/package/hoverintent
 */
function useHover(inAndOut: InAndOut = options, updateTarget = false, opts = undefined) {
  const isHover = ref(false)
  const target = ref(null)
  watch(
    target,
    (target, oldTarget) => {
      if (target && target !== oldTarget) {
        detectHover(target)
      }
    }, {
      flush: 'post'
    }
  )

  function detectHover(target) {
    const _target = isRef(target) ? target.value : target
    if (!_target) return
    const {
      in: inTarget, out
    } = inAndOut
    opts &&
      hoverIntent(
        _target,
        () => {
          inTarget?.(_target)
          isHover.value = true
        },
        () => {
          out?.(_target)
          isHover.value = false
        }
      ).options(opts) !opts &&
      hoverIntent(
        _target,
        () => {
          inTarget?.(_target)
          isHover.value = true
        },
        () => {
          out?.(_target)
          isHover.value = false
        }
      )
  }
  return {
    isHover,
    setHoverTarget: ele => {
      if (!updateTarget && target.value) return
      target.value = ele
    },
  }
}
export {
  useHover
}阅读一个函数时,我们更加关注函数的名字、参数和返回值,因为这三个要素决定了函数的用法。useHover 函数没有把返回值放在前面,需要滚动到后面才知道返回值,把返回值提前,让阅读者快速知道它的存在。
function useHover(inAndOut: InAndOut = options, updateTarget = false, opts = undefined) {
  const isHover = ref(false)
  const target = ref(null)
  watch(
    target,
    (target, oldTarget) => {
      if (target && target !== oldTarget) {
        detectHover(target)
      }
    }, {
      flush: 'post'
    }
  )
  return {
    isHover,
    setHoverTarget: ele => {
      if (!updateTarget && target.value) return
      target.value = ele
    },
  }

  function detectHover(target) {
    const _target = isRef(target) ? target.value : target
    if (!_target) return
    const {
      in: inTarget, out
    } = inAndOut
    opts &&
      hoverIntent(
        _target,
        () => {
          inTarget?.(_target)
          isHover.value = true
        },
        () => {
          out?.(_target)
          isHover.value = false
        }
      ).options(opts) !opts &&
      hoverIntent(
        _target,
        () => {
          inTarget?.(_target)
          isHover.value = true
        },
        () => {
          out?.(_target)
          isHover.value = false
        }
      )
  }
}
这个例子中,return 语句之前的代码只是一个函数,代码行输不是很多,把 return 语句放在最后,可读性提高不大,但是当 return 语句之前有很多代码时,这种改变,可让阅读快速了解到返回值,而不用滚动到下面。
js 使用
function定义函数,定义可在后面,调用在前面,使用const let和函数声明定义函数,不支持调用在前,声明在后。经验法则:使用 function 定义函数,因为它的声明可以在调用之后,function 也一眼能让读者知道它是一个函数,而不是其他类型的变量。
经验法则:一个 js 文件有多于3 个以上的导出,统一放在文件底部导出。
经验法则:相似的代码,选择一个有意义的顺序,并保持一致。一段代码中
A、B和C,在另一段代码中C、A和B会降低可读性。这样的做法,也符合让功能相似的代码看起来也相似的原则。
把代码拆分成段落
把文字分段的原因: 01. 分段是一种把相似的想法放在一起,与其他想法分开的方式,方便组织写作思路; 02. 分段提供了可见的边界,没有边界,读者很容易不知道读到哪儿了; 03. 分段便于段落之间导航。
类似的原因,代码也应该分段。
个人风格和一致性
相当一部分代码格式,是程序员的个人偏好,比如类的大括号是否应换行,缩进是两个 2 个 tab,还是 4 个空格等,但是两种偏好不应该同时出现在代码中,会降低可读性。
一致风格比正确的风格更加重要。
关于格式的最佳实践
项目开始之前,和团队成员讨论,指定编码规范,不花精力制定规范的,采用社区的最佳实践即可,并借助 eslint + prettier + stylelint + gitHook 等工具在代码提交前,检查代码质量,统一格式。
当有新成员加入时,先让他熟悉规范。
言简意赅的注释
当你根据直觉写下一段代码,几周甚至几天后在阅读它时,不会有你写下代码时的直觉。注释可以在代码中记录写代码时的想法,让阅读代码的人快速理解你的想法。
注释的目的是帮助读者快速了解作者写代码时的想法。
何时不需要注释
注释会占用阅读时间和屏幕空间,应该编写必要的注释,错误的或者不必要的注释,不能给出有用的信息,反而可能误导他人。
经验法则:能从代码本身快速推断的信息,不需要注释。
不要给不好的名字添加注释
注释不应掩盖不好的命名,而是应该把名字改好。
好代码 > 坏代码 + 好注释 >> 坏代码 + 坏注释。
需要怎样的注释
好的代码往往能反映你写下代码时的想法,以帮助他人理解你的想法
加入代码评论
在注释中,加入一些有价值的见解,可以帮助他人理解为何这么写。
一些例子:
// 出乎意料的是,对于这些数据使用二叉树比哈希表快 40%
// 哈比运算的代码比左/右比较大得多
这个注释告诉了读者,为何使用使用二叉树,防止它们为谓的优化而浪费时间。
// 作为整体,可能会丢掉几个词。目前没发现bug,想要 100% 解决,太难了。没有这段注释,你的队友可能会过于负责,尝试修复它。
// 这个函数很混乱
// 也许需要另外一种方案,不如提取部分代码到新的函数中
这个注释,给出代码的问题和改进建议。
为代码中的瑕疵写注释
项目一直在迭代,代码一直在演进,难以存在瑕疵。应该把这些瑕疵记录下来,方便他人或者自己改进。
| 标记 | 意义 |
|---|---|
| TODO | 还没完成的事件 |
| BUG | 存在缺陷 |
| FIXME | 需要改进的代码 |
| NOTE | 读者需要特别留意 |
经验法则:以上标记可借助编辑器,可注释显示不同的颜色,方便快速阅读和统计,比如 vscode 的Todo Tree扩展。
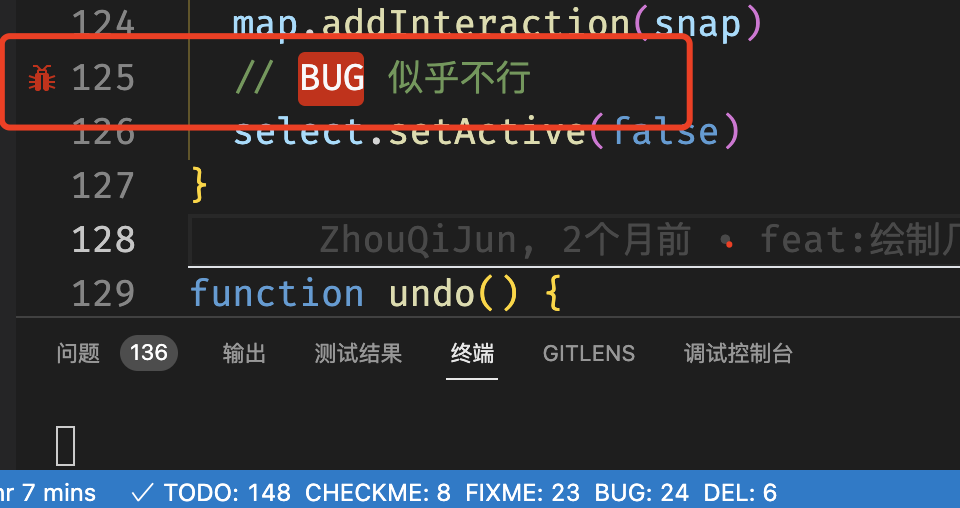
在编辑器左侧显示不同的 icon,状态栏也有统计信息。
给常量添加注释
// as long as it is >= 2 * num_processors, its enough.
const MUN_THREADS = 8
有些常量名字本身足够见名知义,可不加注释。
const SECONDS_1DAY = 24 * 60 * 60;站在读者的角度给出注释
意料之中的提问
他人阅读你的代码时,可能会产生各种疑问:为何这样?为何不使用简便的写法?
当你预料到读者的问题时,最好在注释中给出回答。
公布可能的陷阱
在注释中说出可能的陷阱,可以防止使用者误用。
全局的注释
全局的注释,可以帮助项目新成员快速了解项目或者文件。
// 这个文件包含了一些辅助函数,为我们的文件系统提供了边界的接口
// 它处理了文件权限以及其他基本细节
经验法则:文件级别的注释,告诉这个文件的目的。vscode 可使用koroFileHeader 插件快速插入文件头注释。
使用效果:

总结性注释
在大块代码的之间写一些总结性注释,可帮助读者快速了解代码之间的联系。
如何写好注释
你可能听过这种说法: 注释应该回答为什么,而不是做什么。这种总结过于粗暴。
能帮助读者快速理解代码的注释,都可以写。
写好注释需要的技巧
让注释精简
// This int is the CategoryType
// The first float in the inner pair is the 'score',
// the second is the weight.
typedef hash_map<int,pair<float,float> > ScoreMap
更加精简的注释
// CategoryType -> (score,weight)
typedef hash_map<int,pair<float,float> > ScoreMap
避免指代不明
说明特殊的输入和输出
在函数注释中说明特殊的例子。
简化控制流程
好的命名、美观的排版和精简的注释,只是代码表面上的改进,代码的控制结构对可读性也有巨大影响,优化代码代码结构,让代码具备更好的设计,可以有效提高可读性。
条件结构中的参数顺序
下面的条件语句哪个更加易读?
if (length > 10) {
  //
}
还是
if (10 < length) {
  //
}
第一个更加易读,因为它和英文和中文用法一样,"长度大于 10"。
通用的指导原则:
| 比较的左侧 | 比较的右侧 |
|---|---|
| 变量,不变的变化的 | 用来做比较的表达式,它的值更加倾向于常量 |
优化 if else 的顺序
下面两种等价代码,哪儿更加易读?
if (a === b) {
  //  do a
} else {
  // do b
}
还是
if (a !== b) {
  // do b
} else {
  // do a
}第一种更加可读,因为它先处理正逻辑。if else 顺序问题,经验法则:
- 首先处理正逻辑;
- 先处理简单情况;
- 先处理有趣的或者意外的情况。
三种法则冲突时,只能靠你的判断了。
避免复杂的三目运算符
?: 是 if-else 简写形式,复杂的三目运算符会降低可读性。
避免使用 do {} while 循环
do while 的奇怪之处,是先执行代码块,再判断继续的条件。通常来说,先判断条件,再执行代码块,更加符合直觉。
C++ 的创建者 Bjarne Stroustrup 说:
我的经验是,do语句是困惑的来源...... 我倾向于把条件放在前面我能看到的地方。其结果是,我倾向于避免使用do语句。
善用提前返回
经验法则:把判断简单条件,提交返回,复杂操作放在后面,避免头重脚轻。
function doSomeThing(value) {
  if (!value.includes()) return null
  // do something
  // ...
  return someValue
}
减少 try...catch 语句
很多编程语言都有 try...catch ,用来处理抛出的错误,应该要减少使用它,它有诸多缺点:
- 让函数变得不纯;
- 中断程序控制流,从而会中断理解思路,可读性不高,难以推理程序执行流程;
- 语法冗余,模板代码多;
- 程序中断后无法恢复。
那应该如何处理错误?
程序错误时,不抛出错误,而是给变量设置一个 可理解的 提示信息,或是设置默认值。比如 undefined 、 Invalid user input 。
抛错的例子:
const greet = ({
  firstName,
  lastName
}) => {
  if (firstName === undefined || lastName === undefined) {
    throw new Error("Invalid user");
  }
  return `Hello, ${firstName} ${lastName}`
}
不抛错的改进:
// 设置默认值
const greet = ({
    firstName = "Guest",
    lastName = "User"
  }) =>
  `Hello, ${firstName} ${lastName}`
使用空值合并,设置默认值
抛错的例子:
const getUserName = user => {
  if (
    user !== undefined &&
    user.profile !== undefined &&
    user.profile.name !== undefined
  ) {
    return user.profile.name
  }
  throw new Error("Invalid user")
}
不抛错的例子:
const getUserName = user => user?.profile?.name ?? "Guest"
// 或者
const getUserName = user => user?.profile?.name ?? "user no name"
程序错误时,给一个友好的可理解的默认值,比抛错好得多。
参考:
使用策略模式改善消除多个语句分支或者 switch case
有一个函数如下:
function checkOneVar(greet) {
  if (greet === 'hello') {
    console.log('字符串 hello', 'zqj log')
  } else if (typeof greet === 'number' && greet === 1) {
    console.log('数值 1', 'zqj log')
  } else if (typeof greet === 'boolean' && greet) {
    console.log('布尔值 true', 'zqj log')
  } else {
    console.log('其他值', 'zqj log')
  }
}
这段代码,对同一个变量进行多个条件判断,可使用策略模式改善。
function checkOneVar(greet) {
  function whenHello() {
    console.log('字符串 hello', 'zqj log')
  }

  function whenUndefined() {
    console.log('undefined undefined', 'zqj log')
  }

  function whenNull() {
    console.log('null null', 'zqj log')
  }

  function when1() {
    console.log('数值 1', 'zqj log')
  }

  function whenTrue() {
    console.log('数值 1', 'zqj log')
  }

  const obj = {
    hello: whenHello,
    1: when1,
    true: whenTrue,
    undefined: whenUndefined,
    null: whenNull,
  }
  obj[greet]?.()
}策略模式简化对同一个变量不同值的检查,尤其是对枚举值的检查。
使用 map 的的策略模式:
function checkOneVar(greet) {
  function whenHello() {
    console.log('字符串 hello', 'zqj log')
  }

  function whenUndefined() {
    console.log('undefined undefined', 'zqj log')
  }

  function whenNull() {
    console.log('null null', 'zqj log')
  }

  function when1() {
    console.log('数值 1', 'zqj log')
  }

  function whenTrue() {
    console.log('数值 1', 'zqj log')
  }
  const map = new Map()
  map.set('hello', whenHello)
  map.set(1, when1)
  map.set(undefined, whenUndefined)
  map.set(null, whenNull)
  map.set(true, whenTrue)

  map.get(greet)?.()
}
使用 || 过滤假值,简化多个条件语句
有一个从对象中提取地址的函数:
function calcPlace(location_info) {
  const {
    country,
    state,
    city,
    local
  } = location_info

  let first_part = 'middle-of-nowhere'
  let second_part = 'planet earth'
  if (country === 'USA') {
    if (city) {
      first_part = city
    }
    if (local) {
      first_part = local
    }
    second_part = 'USA'
    if (state) {
      second_part = state
    }
  } else {
    second_part = 'planet earth'
    if (country) {
      second_part = country
    }
    if (state) first_part = state
    if (city) first_part = city
    if (local) first_part = local
  }

  return `${first_part},${second_part}`
}
两层条件语句嵌套,理解时还要考虑条件语句的优先情况,认知负担大,改用 || 可改善:
function calcPlace(location_info) {
  const {
    country,
    state,
    city,
    local
  } = location_info

  let first_part
  let second_part
  if (country === 'USA') {
    // 先处理正逻辑
    first_part = local || city || 'middle-of-nowhere'
    second_part = state || 'USA'
  } else {
    first_part = local || city || state || 'middle-of-nowhere'
    second_part = country || 'planet earth'
  }

  return `${first_part},${second_part}`
}思考:||和??有何不同?该如何选择?
相同点:
都可用于多个变量的存在性检查,获取第一个存在的变量,可简化多个 if 语句。都需要注意短路效应或者说变量取值的优先级。
不同点:?? 用于过滤空值,获取第一个非空值 undefined 和 null , 常用来获取非空值,特别小心 NaN 。
|| 用于过滤假值( undefined 、 null 、 0 、 false 、 '' 、 NaN ),获取第一个真值。
常用来获取 非空字符串 、 非零数值 和 true ,当 0 和 false 有意义时,要特别小心。
最小化嵌套
嵌套很深的代码难以理解,因为每个嵌套都会让读者思考嵌套结束的地方。
if (e.rainMetrics && JSON.stringify(e.rainMetrics) !== '{}') {
  let arr = Object.getOwnPropertyNames(e.rainMetrics)
  if (arr.length !== 0) {
    if (e.rainPeriod && e.rainPeriod.length > 0) {
      e.rainPeriod.map(field => {
        if (e.rainMetrics[field].length > 0) {
          let oneObj, twoObj
          e.rainMetrics[field].forEach(b => {
            if (b.warnName === '准备转移') {
              twoObj = assign({}, oneObj, {
                intv: field,
                warnName: b.warnName,
                warnGradeId: b.warnGradeId,
                period: b.period,
                crp: b.crp,
              })
              tetList.push(twoObj)
            }
            if (b.warnName === '立即转移') {
              oneObj = assign({}, b, {
                intv: field,
                warnName: b.warnName,
                warnGradeId: b.warnGradeId,
                period: b.period,
                crp: b.crp,
              })
              tetList.push(oneObj)
            }
          })
        }
      })
    }
    tetList.forEach(v => {
      if (v.warnName === '准备转移') {
        threeObj['prepareTime' + v.period] = v.crp
      }
      if (v.warnName === '立即转移') {
        threeObj['immediatelyTime' + v.period] = v.crp
      }
    })
  }
}
基本无可读性可言。
深层嵌套往往都是逐渐累积的,当修改修改一个已经有嵌套的代码时,整体考虑这个代码片段,当嵌套比较深时,就要思考有没有可改进的方法。
衡量嵌套的复杂度,圈复杂度,嵌套越深,圈复杂度越高,代码可读性越低。
避免过深的嵌套的方式有哪些呢?
提前返回或者提前抛错
if (user_result === 'SUCCESS') {
  if (permission_result !== 'SUCCESS') {
    reply.WriteErrors('error reading permission.')
    reply.Done()
    return
  }
  reply.WriteErrors('')
} else {
  reply.WriteErrors(user_result)
}
reply.Done()
使用提前返回改进它:
if (user_result !== 'SUCCESS') {
  reply.WriteErrors(user_result)
  reply.Done()
  return
}
if (permission_result !== 'SUCCESS') {
  reply.WriteErrors('error reading permission.')
  reply.Done()
  return
}
reply.WriteErrors('')
reply.Done()
通过改进,可读性显著提高了。
再看一个提前抛错的例子:
async function getBook(params) {
  const {
    id
  } = params;
  if (id) { // not an empty string
    const idAsInt = parseInt(id);
    if (!isNaN(idAsInt)) { // is it a number?
      const book = await findBook(idAsInt);
      return Response.ok(JSON.stringify(book));
    } else {
      throw Error("Id must be numeric");
    }
  } else {
    throw Error("Id must be present");
  }
}
两个抛错的条件,可以提前:
async function getBook(params) {
  const {
    id
  } = params;
  if (!id) {
    throw Error("Id must be present");
  }

  const idAsInt = parseInt(id);
  if (Number.isNaN(idAsInt)) {
    throw Error("Id must be numeric");
  }

  const book = await findBook(idAsInt);
  return Response.ok(JSON.stringify(book));
}
这样处理,抛错的两个条件语句提前了。
代码来源 -- Invariant - a helpful JavaScript pattern
不要滥用抛错,因为它有诸多缺点,比如处理错误的可读性差、排错困难、程序被中断、理解代码的思考被中断、使得函数不纯等。
嵌套的条件语句,只有一个操作,可合并
有一段这样的代码:
data.value?.resources.forEach(itemOne => {
  itemOne?.subs.forEach(itemTwo => {
    // 只在三维下执行:行政区划,行政驻地
    const is3DList = ['listen_id_371', 'listen_id_372']
    if (is3DList.includes(itemTwo.name)) {
      if (isCesium()) {
        if (itemTwo.checked === 1) {
          // 两个条件下,只有一个操作,可把条件合并
          cacheChecksData[itemTwo.id] = itemTwo
          onLayerCheck(itemTwo, true)
        }
      }
    } else {
      if (itemTwo.checked === 1) {
        cacheChecksData[itemTwo.id] = itemTwo
        onLayerCheck(itemTwo, true)
      }
    }
  })
})
经过观察, itemTwo.checked === 1 和 isCesium() 可合并,减少嵌套:
data.value?.resources.forEach(itemOne => {
  itemOne?.subs.forEach(itemTwo => {
    // 只在三维下执行:行政区划,行政驻地
    const is3DList = ['listen_id_371', 'listen_id_372']
    if (is3DList.includes(itemTwo.name)) {
      if (isCesium() && itemTwo.checked === 1) {
        cacheChecksData[itemTwo.id] = itemTwo
        onLayerCheck(itemTwo, true)
      }
    } else {
      if (itemTwo.checked === 1) {
        cacheChecksData[itemTwo.id] = itemTwo
        onLayerCheck(itemTwo, true)
      }
    }
  })
})
经过合并条件,嵌套少了一层。
调整条件语句的顺序
当条件语句顺序不影响代码执行时,可调整顺序,减少嵌套。
上面的例子,经过观察,有两个条件语句 itemTwo.checked === 1 ,可把它提到外层。
// 只在三维下执行: 行政区划, 行政驻地
const is3DList = ['listen_id_371', 'listen_id_372']
data.value?.resources.forEach(itemOne => {
  itemOne?.subs.forEach(itemTwo => {
    if (itemTwo.checked === 1) {
      if (is3DList.includes(itemTwo.name) && isCesium()) {
        cacheChecksData[itemTwo.id] = itemTwo
        onLayerCheck(itemTwo, true)
      } else if (!is3DList.includes(itemTwo.name)) {
        cacheChecksData[itemTwo.id] = itemTwo
        onLayerCheck(itemTwo, true)
      }
    }
  })
})
这样调整以后,嵌套虽然没有减少,但是条件语句不再重复,更加容易理解。
下一个办法,继续改进它。
减少循环或者迭代中的嵌套
使用 break 或者 continue 可减少循环内的嵌套。
for (let i = 0; i < result.length; i++) {
  if (result[i]) {
    count++
    if (result[i].name !== '') {
      // do something
    }
  }
}
改进:
for (let i = 0; i < result.length; i++) {
  if (!result[i]) continue
  count++
  if (result[i].name === '') continue
  // do something
}
continue 和 break,还能用于
for of迭代。如何跳出
forEach循环?
return 跳出本轮循环。
const arr = [
  [1, 2, 3],
  ['1', '2', '3'],
]

arr.forEach(ele => {
  ele.forEach(item => {
    if (item === '2') return /*跳出本次循环*/
    console.log(item)
  })
})
输出 1 2 3 '1' '3' 。
forEach 不能使用continue和break,希望跳出整个循环,使用try...catch,在内部抛出错误。但是不推荐这么使用。
使用 for of 改写上面的例子:
const arr = [
  [1, 2, 3],
  ['1', '2', '3'],
]

for (const value of arr) {
  for (const _value of value) {
    if (_value === '2') continue /*跳出本次迭代*/
    console.log(_value)
  }
}注意:在for of中不能使用return,可以使用continue和break。
使用 return 再次改进前面的例子:
const is3DList = ['listen_id_371', 'listen_id_372']
data.value?.resources.forEach(itemOne => {
  itemOne?.subs.forEach(itemTwo => {
    // 跳出本轮循环
    if (itemTwo.checked !== 1) continue

    if (is3DList.includes(itemTwo.name) && isCesium()) {
      cacheChecksData[itemTwo.id] = itemTwo
      onLayerCheck(itemTwo, true)
    } else if (!is3DList.includes(itemTwo.name)) {
      cacheChecksData[itemTwo.id] = itemTwo
      onLayerCheck(itemTwo, true)
    }
  })
})
优化以后,内层循环的嵌套,只有一层了。😄
避免回调地狱
使用 await 或者 promise.then 避免回调地狱问题。
让执行流程更容易理解
除了把循环、条件和其他跳转语句写得简单,更应该从高层次来考虑执行流程,让执行流程更容易理解。在实践中,有些代码结构会让流程难以了理解和难以调试,应该避免滥用它们。
| 代码结构 | 对程序的影响 |
|---|---|
| 异常 | 会从多个函数调用中向上冒泡地执行 |
| 线程、异步回调 | 不清楚何时执行代码 |
| 信号量、中断处理 | 可能随时执行 |
拆分超长表达式
表达式越长,越难以理解,且容易出现 bug,要把超长表达式拆分成小块。
将表达式存入描述性变量
if (line.split(':')[0].strip() === 'root') {
  // do something
}
// 引入描述性变量
const usrName = line.split(':')[0].strip()
if (usrName === 'root') {
  //
}
多次使用的表达式存在描述性变量:
if (request.user.id === document.owner_id) {
  //
}
if (request.user.id !== document.owner_id) {
  // do
}
即使表达式很短,把它存入描述性变量,会更加容易理解。
const user_own_doc = request.user.id === document.owner_id
if (user_own_doc) {
  //
}
if (!user_own_doc) {
  // do
}
使用可选链 ?. 简化存在性检查
value?.key ,当 value 为 null 或者 undefined 时,表达式返回 undefined 。善用它,简化对象深层属性的判断。
const objDeep = {
  a: {
    b: {
      c: 'hello',
      d: 'a'
    }
  }
}
if (objDeep.a && objDeep.a.b && objDeep.a.b.c) {
  // 当 c 的值为真
  // do something
}
// 使用可选链简化
if (objDeep.a?.b?.c) {
  // 当 c 的值为真
  // do something
}
技巧: ?. 还可以用于函数和数组。const ele = arr?.[4] // arr 存在,才获取下标为 4 元素
obj.methodName?.() // obj.methodName 方法,才执行善用德摩根定律
const result = !(a && b)
const result2 = !a || !b
// 这两个表达式等价转换技巧:分别取反,&和||互换。
可以使用这个定律使得表达式更加可读。
if (!(file_exist && !is_protected)) {
  // 不易读
}
if (!file_exist || is_protected) {
  // 更加可读
}
避免赋值语句再包含其他操作
if (!(bucket = findBucket(key))) {
  //
}
// 包含两个操作
// 1. 取出 key 对应的 bucket
// 2. 判断 bucket 是否不存在
一个语句或者表单式具有多个操作,虽然代码量少了,显得很智能,但是容易让人困惑。
分成两步写,可读性更高。
const bucket = findBucket(key)
if (!bucket) {
  //
}
简写的箭头函数只有一条语句也容易出现这种情况:
const myFn = (value) => result = doSomeThing(value)返回值和赋值语句混合了,难以确定写代码的人是刻意为之还是不小心写错了。
const myFn = (value) => {
  return doSomeThing(value)
}
这样更加可读。
避免任何智能的代码,它会让人困惑。
拆分巨大语句
一个语句包含两个以上操作,也容易让人困惑。
function update_highlight(message_num) {
  if ($("#vote_value" + message_num).htm1() === "Up") {
    $("#thumbs_up" + message_num).addClass("highlighted")
    $("#thumbs_down" + message_num).removeClass("highlighted")
  } else if ($("#vote_value" + message_num).htm1() === "Down") {
    $("#thumbs_up" + message_num).removeClass("highlighted")
    $("#thumbs_down" + message_num).addClass("highlighted")
  } else {
    $("#thumbs_up" + message_num).removeClass("highighted")
    $("#thumbs_down" + message_num).removeClass("highlighted")
  }
}
代码中每个语句都包含了两个操作,不好理解,把它们拆分成描述性变量:
function update_highlight(message_num) {
  const $thumbs_up = $("#thumbs_up" + message_num)
  const $thumbs_down = $("#thumbs_down" + message_num)
  const vote_value_html = $("#vote_value" + message_num).htm1()
  const hi = 'highlighted'
  if (vote_value_html === "Up") {
    $thumbs_up.addClass(hi)
    $thumbs_down.removeClass(hi)
  } else if (vote_value_html === "Down") {
    $thumbs_down.removeClass(hi)
    $thumbs_down.addClass(hi)
  } else {
    $thumbs_up.removeClass(hi)
    $thumbs_down.removeClass(hi)
  }
}这样一改进,可读性有明显的提高。const hi = 'highlighted' 不是必需的,但是鉴于这个变量使用了多次,提取成单独的变量,有诸多好处: 01. 避免输入错误。第一个版本有一个单词写错了(highighted 少了一个字母 l) 02. 当名字需要修改,只改一处。 03. 降低了行宽。
经验法则:当一个值使用超过 2 次,就应该把它提取成变量。
复杂逻辑反向操作
有一个表示区间的类:
class Range {
  begin
  end
  isOverlapsWith(otherRange) {
    // 判断是否和range 重叠 [0,5) 和 [3,8) 有重叠
  }
}
正向思考,需要判断当前的区间端点是否是否在另一个端点的范围内
const isOverlap = (begin >= otherRange.begin && begin <= otherRange.end) || (end >= otherRange.begin && end <= otherRange.end)这个表达式就太复杂了,不易理解,且容易错误,它忽略了 begin 和 end 完全包含的情况。反向思考,更加简单:AB 无重叠,A 在 B 开始之前结束,或者 A 在 B 结束后开始,从而达到简化判断的目的。
isOverlapsWith(otherRange) {
  if (otherRange.end <= begin) return false
  if (otherRange.begin >= end) return false
  return true
}
减少变量和收缩作用域
变量的随意使用会让程序变的难以理解: 01. 变量越多,就越难以跟踪它们的动向; 02. 变量的作用域越大,就需要跟踪它们的动向越久; 03. 变量改变得越频繁,就越难以跟踪它当前的值。
减少变量
前面我们增加描述性变量来保存复杂表达式,并且它们可作为某种形式的文档。但是我们需要减少不能改进可读性的变量,从而让代码更加精简和容易理解。
删除没有价值的零时变量
const now = datetime.datetime.now()
const root_msg_last_view_time = now
now 是值得保留的变量吗?不是,因为它: <br/> 01. 没有拆分复杂表达式; <br/> 02. 没有做更多的澄清 -- datetime.datetime.now() 已经很清楚了;<br/> 03. 只用了一次-- 没有压缩冗余代码。
<br/>
<br/>
没 now ,代码更容易理解。
减少中间结果
一个例子:
function remove_one(array, value_to_remove) {
  let index = -1
  for (let i = 1; i < array.length; i++) {
    if (array[i] === value_to_remove) {
      index = i
      break
    }
  }
  if (index > -1) {
    array.splice(index, 1)
  }
}
index 只是保存中间的临时结果,这种变量可以通过得到后立即处理它而被删除。
function remove_one(array, value_to_remove) {
  for (let i = 1; i < array.length; i++) {
    if (array[i] === value_to_remove) {
      array.splice(i, 1)
      return
    }
  }
}
不再用 index ,代码精简多了,可读性也提高了。
减少控制流变量
常见到循环中有如下模式:
let done = false
while (!done) {
  // do something
  if (someCondition) {
    done = true
    continue
  }
}
这种变量,称为控制流变量,它不包含任何程序数据,仅仅用于控制程序流程变化,它们可以通过良好的设计而被消除。
具体的例子后面会有。
使用声明式代码是消除控制流变量的重要方式
有一段求和的代码:
const arr = [1, 2, 3, 4]
let sum = 0
for (let i; i < arr.length; i++) {
  sum += arr[i]
}
这段代码每次累加,都要维护下标 i ,非常容易出错。使用声明式的代码可消除 i :
const arr = [1, 2, 3, 4]
const sum = arr.reduce((pre, next) => {
  return pre + next
}, 0)
或者使用 forEach 或者 for of :
const arr = [1, 2, 3, 4]
const sum = 0
arr.forEach(item => {
  sum += item
})
声明式代码告诉你做什么,往往不需要知道太多细节,命令式代码告诉你怎么做,会包含很多细节。
再看一个例子,找到第一个大于3的元素:
命令式代码:
const arr = [1, 2, 5, 4, 3, 5, 5, 6, 0]
let greatThan3
let len = arr.length
let i = 0
while (i < len) {
  if (arr[i] > 3) {
    greatThan3 = arr[i]
    break
  }
  i++
}
需要计算数组下标、数组长度,然后跳出循环,需要控制的变量很多,认知负担大。
声明式代码:
const arr = [1, 2, 5, 4, 3, 5, 5, 6, 0]
const greatThan3 = arr.find(ele => ele > 3)
使用声明式代码不仅消除了两个变量,可读性也提高了。
js 中有哪些声明式的代码呢?
数组方法: forEach 、 filter 、 every 、 some 、 map 、 find 、 findIndex 等。
缩小变量的作用域
缩写变量作用域是提高可读性的重要手段,常说的减少全局变量的使用,就是缩小变量作用域的常见手段。
让变量的作用域越小越好,作用域越大,越容易出现命名冲突,越难以跟踪变化。
js 中常见的作用域: 01. 全局作用域; 02. 局部作用域:模块作用域、函数作用域、块作用域。
最佳实践:使用 let 和 const 声明变量,它们有块级作用域。
禁止使用 var 或者不使用任何关键字声明变量 ,因为它不会产生块级作用域。
最佳实践:在即将使用的地方声明,能有效缩写变量的作用域。
经验法则:使用闭包,可缩小变量作用域在某个函数中,也实现了防止命名冲突。
使用常量或者不变性变量
不断变化的变量会导致难以跟踪它的值,难以推理程序的状态,非常容易出 bug。
一个例子;
const numbers = [1, 2, 3, 4, 5, 6]
numbers.splice(0, 3) // [1,2,3]
// numbers 被修改成 [4,5,6]
numbers.splice(0, 3) // [4,5,6]
// numbers 被修改成 []
numbers.splice(0, 3) // []
// numbers 被修改成 []
splice 的三次调用参数相同,得到的结果却不同,而且还修改了 numbers,就非常难以推理 splice 的返回值和当前的 numbers 的值。
使用 slice 就没有这种问题
const numbers = [1, 2, 3, 4, 5, 6]
// 纯的,多次调用,返回值相同,且不会修改 numbers
numbers.slice(0, 3) // [1, 2, 3]
numbers.slice(0, 3) // [1, 2, 3]
numbers.slice(0, 3) // [1, 2, 3]
三次调用,参数相同,结果相同,且不会修改 numbers。
副作用(side effect):除了代码单元的返回值对表达式产生影响外,还有其他影响,比如上面的例子中,splice 修改了 numbers。
副作用往往是 bug 的来源, 可变数据和赋值操作是非常常见的副作用。
几种方案可使变量不可变:
- 使用
immutable.js等不可变的数据结构; - 使用 js 库(比如 lodash)来执行不可变的操作;
- 使用 es6 中执行不可变操作;
- 赋值一次,不再赋值的变量,使用
const声明; - 编写无副作用的函数:① 函数不改变参数;② 不抛错;③ 必需有返回值;
- 涉及到传递对象和数组时,传入深度复制后的数据(严格来说,不是不可变)。
前两种不在此介绍,主要看看后面三种是如何避免可变的。
ES6 中的不可变操作
const a = {
  name: 'js',
  age: 20
}
const b = Object.assign({}, a) // assign 合并浅层属性
b.name = 'python' // 修改 b,不影响 a

const c = {
  ...a
} // 扩展运算符 ... 也是不可变操作
使用 const 声明不再变化的变量
比如,上面的例子中, a 初始化后不再赋值,使用了 const ,当不小心赋值时,编辑器会报错。
编写无副作用的函数
副作用常常是 bug 的来源,编写函数时,不要让函数有副作用。
function remove_one(array, value_to_remove) {
  for (let i = 1; i < array.length; i++) {
    if (array[i] === value_to_remove) {
      array.splice(i, 1)
      return
    }
  }
}
remove_one 就是一个有副作用的函数,它改变了参数。改成无副作用的版本:
function remove_one(array, value_to_remove) {
  return array.filter(item => item !== value_to_remove)
}
技巧:1. 不改变参数和全局变量,2. 保证函数有返回值,遵循这两个原则就能写出无副作用的函数。
js 中有副作用的函数,要谨慎使用。
这些数组函数有副作用
const array = [1, 2, 3, 4]
array.splice(0, 1) // array [1,2,3]
array.reverse() // array [3,2,1]
array.sort()
多使用无副作用的函数,它们都返回一个新的数组:
const array = []
array.reduce()
array.reduceRight()
array.filter()
array.map()
array.some()
array.every()
array.slice()
array.toReversed()
array.toSorted()
array.toSpliced()
array.flat()
array.flatMap()
array.with() // 修改某个位置的元素
深度复制避免意外改变变量
这个不多阐述,有开发经验的人都理解。
最后的一个例子
有如下的 html 代码:
<input type="text" id="input1" value="Dustin">
<input type="text" id="input2" value="Trevor">
<input type="text" id="input3" value="">
<input type="text" id="input4" value="Melissa">
<!-- ...还有很多 input -->
编写一个函数 setFirstEmptyInput(valueStr) ,给第一个 value 值为空的 input 设置值,并返回修改后的 input,没有为空的 input, 返回 null。
我的实现:
function setFirstEmptyInput(valueStr) {
  const inputs = document.querySelectorAll('input')
  const firstEmptyInput = Array.from(inputs).find(input => input.value === '')
  if (!firstEmptyInput) return null
  firstEmptyInput.value = valueStr
  return firstEmptyInput
}
其他实现:
function setFirstEmptyInput(valueStr) {
  let found = false
  let i = 1
  let ele = document.getElementById('input' + i)
  while (ele !== null) {
    if (ele.value === '') {
      found = true
      break
    }
    i++
    ele = document.getElementById('input' + i)
  }
  if (found) ele.value = valueStr
  return ele
}
found 是循环控制变量,可消除。
function setFirstEmptyInput(valueStr) {
  let i = 1
  let ele = document.getElementById('input' + i)
  while (elem !== null) {
    if (elem.value === '') {
      elem.value = valueStr
      return ele
    }
    i++
    ele = document.getElementById('input' + i)
  }
  return null
}
这个循环类似 do...while 循环,且 document.getElementById 调用了两次,希望避免使用 do...while ,消除 document.getElementById 的重复:
function setFirstEmptyInput(valueStr) {
  let i = 1
  while (true) {
    let ele = document.getElementById('input' + i)
    if (ele === null) {
      return null
    }
    if (ele.value === '') {
      ele.value = valueStr
      return ele
    }
    i++
  }
}
这个版本的,更加好了,相比之下,还是我的实现最好,它没有涉及到循环,即没有代码嵌套,也没有冗余的变量。
一次只做一件事
简单来说,就是保持代码单元(函数、类、代码段落)的职责单一。
工程学的思想:把大问题拆分成小问题,再把小问题的解决方案组合成大问题的解决方案。
保持职责单一的技巧:拆分任务,相同的任务聚集到同一个代码快中。
写代码也一样,在解决一个复杂问题时,可把它拆分成解决简单问题的组合。
提取可复用的操作
一个例子:
找到距离给定点最近的点
// Return which element of 'array'
// is closest to the given latitude / longitude.
// Models the Earth as a perfect sphere.
function findClosestLocation(lat, lng, array) {
  let closest
  let closest_dist = Number.MAX_VALUE
  for (let i = 0; i < array.length; i = 1) {
    // 计算球面距离 start
    // Convert both points to radians.
    const lat_rad = radians(lat)
    const lng_rad = radians(lng)
    const lat2_rad = radians(array[i].latitude)
    const lng2_rad = radians(array[i].longitude)
    // use the "Spherical law of Cosines" formula.
    const dist = Math.acos(
      Math.sin(lat_rad) * Math.sin(lat2_rad) +
      Math.cos(lat_rad) * Math.cos(lat2_rad) * Math.cos(lng2_rad - lng_rad)
    )
    // 计算球面距离 end
    if (dist < closest_dist) {
      closest = array[i]
      closest_dist = dist
    }
  }
  return closest
}
循环中计算球面距离的代码可提取成独立的函数:
function findClosestLocation(lat, lng, array) {
  let closest
  let closest_dist = Number.MAX_VALUE
  for (let i = 0; i < array.length; i = 1) {
    // 计算球面距离
    const dist = sphericalDistance(lat, lng, array[i].lat, array[i].lng)

    if (dist < closest_dist) {
      closest = array[i]
      closest_dist = dist
    }
  }
  return closest
}

function sphericalDistance(lat1, lng1, lat2, lng2) {
  const lat_rad = radians(lat1)
  const lng_rad = radians(lng1)
  const lat2_rad = radians(lat2)
  const lng2_rad = radians(lng2)
  // use the "Spherical law of Cosines" formula.
  const dist = Math.acos(
    Math.sin(lat_rad) * Math.sin(lat2_rad) +
    Math.cos(lat_rad) * Math.cos(lat2_rad) * Math.cos(lng2_rad - lng_rad)
  )
  return dist
}
提取之后,可读性提高, sphericalDistance 还就可以单独测试,复用更加容易了。
保持函数短小,职责单一,有诸多好处。
再看一个例子:
从对象中抽取值:
const locationInfo = {
  country: 'USA',
  state: 'California',
  city: 'Los Angeles',
  local: 'Santa Monica'
}
从这个对象中提取友好的地址字符串,形成 city,country ,比如 Santa Monica, USA ,找到每个属性都可能缺失。提取方案:
- 选择 city 的值时,先取 local,没有,再取 city, city 还是没有,再取 state,还是没有,取默认值
middle-of-nowhere; - 选择 country 的值,country 不存在,取默认值
planet earth。
第一个实现了版本:
const locationInfo = {
  country: 'USA',
  state: 'California',
  city: 'Los Angeles',
  local: 'Santa Monica',
}

function calcPlace(location_info) {
  // 取值 + 更新第一部分
  let place = location_info['local'] //  e.g. "Santa Monica"
  if (!place) {
    // 取值 + 更新第一部分
    place = location_info['city'] //  e.g. "Los Angeles"
  }
  if (!place) {
    // 取值 + 更新第一部分
    place = location_info['state'] //  e.g. "California"
  }
  if (!place) {
    // 取值 + 更新第一部分
    place = 'middle-of-nowhere'
  }

  if (location_info['country']) {
    // 取值 + 更新第二部分
    place += ', ' + location_info['CountryName'] //  e.g. "USA"
  } else {
    // 取值 + 更新第二部分
    place += ',planet earth'
  }

  return place
}
代码有点乱,但是能工作。过几天,新的需求又来了:美国之内的地点,要显示州,而不是国家名。
第二个版本:
function calcPlace(location_info) {
  // 1. 取值
  const {
    country,
    state,
    city,
    local
  } = location_info

  // 2. 计算第一部分
  let first_part = 'middle-of-nowhere'
  if (state && country !== 'USA') {
    first_part = state
  }
  if (city) {
    first_part = city
  }
  if (local) {
    first_part = local
  }
  // 3. 计算第二部分
  let second_part = 'planet earth'
  if (country) {
    second_part = country
  }
  if (state && country === 'USA') {
    second_part = state
  }
  // 4. 组合成新地址
  return `${first_part},${second_part}`
}
第一个版本的不同操作,分散在不同的代码区域,而第二个版本,相同的操作,更加聚集,4 个不同的任务,聚合在 4 个代码块中,可读性和可维护性,第二个版本更加好。
第二个版本中,对 country 的判断分散在两个代码块中,和其他逻辑交织在一起,可读性还是不够理想,希望对 country 的判断更加聚集,可以提高可读性。
function calcPlace(location_info) {
  const {
    country,
    state,
    city,
    local
  } = location_info

  let first_part
  let second_part
  if (country === 'USA') {
    // 先处理正逻辑
    first_part = local || city || 'middle-of-nowhere'
    second_part = state || 'USA'
  } else {
    first_part = local || city || state || 'middle-of-nowhere'
    second_part = country || 'planet earth'
  }

  return `${first_part},${second_part}`
}
第三个版本的可读性又有很大的提升。
技巧:从多个值中获取第一个真值,使用 const result = a||b||c||'default value' ,可简写多个 if 语句。提取工具函数代码
每个项目都有一些可复用的工具代码,可提取出来。
常见的工具函数:
- 表单验证函数;
- 日期格式化函数;
- 深度复制;
- 数组去重;
- 下载文件
简化已有接口
参数少,不需要很多设置就能使用的库,总是让人爱不释手。如果你嫌正在使用的库不够简洁,就可以再封装一下,让它更加优雅易用。
比如 jQuery 就封装了复杂难用的 DOM 操作,堪称封装的典范,即使十多年过去,它依然被很多网站采用。
js 处理 cookie,浏览器只提供了 document.cookie :
document.cookie = 'key1=value1'
document.cookie = 'key2=value2' // NOTE 追加 cookie,而不是覆盖
删除 cookie 更加奇怪,需要设置一个过去的时间。
符合直觉的用法:
removeCookie(key)
// 或者
cookie.remove(key)
封装一个优雅的 cookie 操作函数:
希望的接口:
const {
  get,
  set,
  remove
} = cookie()
// 还可以这样使用
cookie.get()
cookie.set()
cookie.remove()
function cookie() {
const enable = window.navigator.cookieEnabled
cookie.get = get
cookie.set = set
cookie.remove = remove
cookie.enable = enable
return {
remove,
set,
get,
enable,
}
function set(name, value, {
age_in_mins = 7,
...rest
} = {}) {
const options = {
path: '/',
domain: '*.' + window.location.hostname,
'max-age': age_in_mins * 60,
...rest,
}
if (options.expires instanceof Date) {
options.expires = options.expires.toUTCString()
}
let updatedCookie = encodeURIComponent(name) + '=' + encodeURIComponent(value)
for (let optionKey in options) {
updatedCookie += '; ' + optionKey
let optionValue = options[optionKey]
if (optionValue !== true) {
updatedCookie += '=' + optionValue
}
}
document.cookie = updatedCookie
}
function get(name) {
let cookie = {}
const decodeCookie = decodeURIComponent(document.cookie)
decodeCookie.split(';').forEach(function(el) {
let [k, v] = el.split('=')
cookie[k.trim()] = v
})
return cookie[name]
}
function remove(name) {
if (!name) return false
set(name, '', {
age_in_days: -1,
})
return true
}
}少写代码
最好读的代码是没有代码。多写多错,不写不错,写下的每一行代码,没充分的测试,都可能引入 bug。
如何少写代码呢?
转化你的需求
产品经理说需要一个 google, 经过分析,他其实只是需要一个能让用户搜索的功能。
当产品理解提出难以实现或者离谱的需求时,积极了解他的目的,实现困难时,就换一种方式满足用户。
简化函数的参数
参数越多,易用性越差,可读性也越差。
- 位置参数超过4个,使用对象代替
函数参数不应该超过4个,超过4个,就难以理解和使用。超过4个,使用对象代替。
// 位置参数太对,难以使用和理解
function person(name, age, city, salary, job){}
// 使用对象代替 5个参数被放在一个对象里
function person2({name, age, city, salary, job}){}
- 多使用默认参数和剩余参数
提供默认参数和剩余参数,可提高函数的易用性。
function testFn(name,age=18,job='coder'){
//
}
testFn('Jack')
testFn('Tom',20)
testFn('Tim',34,'PM')
对象的默认参数,善用解构
function person({ name = 'Tim', age = 28, ...restProps } = {}) {
  console.log(restProps)
}
person()
person({
  name: 'Tim',
  age: 30,
  salary: '$30000',
  addr: 'ShangHai, China',
  job: 'rust dev',
})
当知道了对象会具备的属性时,使用对象默认参数是非常好的方法。
比如需要给一个div设置style样式:
function setDivStyle({width='200px',height='100px',display='flex',...restProps}={}){}- 剩余参数
function testFn(name, age, city, ...restParams) {}避免滥用剩余参数,因为剩余参数也是位置参数的一种。函数不能同时具备剩余参数和默认参数。
- 柯里化实现减少形参和复用实参
柯里化的基本形式:函数A返回另函数B,B使用A的参数参与计算。
function outerFn(greet) {
  return function innerFn(name) {
    console.log(`${greet},${name}`)
  }
}
再看一个例子
function sum(a, b) {
  return a + b
}
// 参数 10 重复 3 参数
sum(10, 1)
sum(10, 10)
sum(10, 100)
使用柯里化复用参数:
function currySum(a) {
  return function add(b) {
    return a + b
  }
}

const tenAdd = currySum(10)
tenAdd(1) // 复用之前的参数 10
tenAdd(10) // 同上
tenAdd(100) // 同上
柯里化不仅可以返回函数,还能返回包含函数的对象,有时候这种方式会更加实用。
function counter(initValue) {
  return {
    add,
  }

  function add(n) {
    return initValue + n
  }
}
const {
  add
} = counter(10)
add(1)

const {
  add: add100and
} = counter(100)
add100and(1000)
// 像不像 react 的 useState ? 😄通过柯里化,把两个形参拆分到了两个函数中,从而实现了实参复用。 通用的柯里化函数,读者可自行实现或者谷歌。
通过柯里化拆分形参,实现了实际参数的复用,函数功能不仅得到加强,易用性和可读性也提高了。
看一个综合的例子,封装一个 vue3 的useHttp:
type Method = 'post' | 'get'
type MaybeRef<T> = Ref<T> | T

type Options = {
  method?: Method
  enableWatch?: boolean
  immediate?: boolean
  autoAbort?: boolean
}

function useHttp(
  url: string,
  params: MaybeRef<Record<string, any>> = ref({}),
  { enableWatch = true, immediate = true, autoAbort = true, method = 'get' }: Options = {}
) {
  const _params = unref(params)
  const data = ref()
  const loading = ref(false)

  enableWatch &&
    watch(
      params,
      newParams => {
        sendHttp(newParams)
      },
      {
        deep: true,
      }
    )

  onMounted(() => {
    immediate && sendHttp(unref(params))
  })

  let abortController = null // new AbortController()
  onBeforeUnmount(() => {
    autoAbort && abortHttp()
  })

  type SendHttp = (params?: Record<string, any>) => Promise<any>

  return [data, loading, sendHttp] as [Ref<any>, Ref<boolean>, SendHttp]

  function sendHttp(params: Record<string, any> = _params) {
    let path = url
    let body = undefined
    if (method === 'get') {
      let query = Object.keys(params)
        .map(k => `${encodeURIComponent(k)}=${encodeURIComponent(params[k])}`)
        .join('&')
      path += `?${query}`
    } else if (method === 'post') {
      body = JSON.stringify(params)
    }

    abortController = new AbortController()
    const options = { body, signal: abortController.signal }

    loading.value = true

    return fetch(path, options)
      .then(res => {
        // 请求不成功,不抛错
        if (!res.ok) {
          return Promise.resolve({
            success: false,
            msg: ` httpCode is ${res.status}`,
          })
        }
        return res.json()
      })
      .then(res => {
        data.value = res
        return res
      })
      .finally(() => {
        loading.value = false
        abortController = null
      })
  }

  function abortHttp() {
    abortController?.abort()
  }
}

export { useHttp }
使用方式:
// 立即请求 todo
const [todo] = useHttp('/todos/120')

const params = ref({
  date: '2023-10-10'
})
// 立即请求订单,当 params 改变,会自动再次请求
const [orderList, loading] = useHttp('/orders', params)

// 自动请求,需要再次更新 userList 时,
// 手动调用,fetchUsers({job:'pm'}),会复用 url 和 method
const [userList, loadIngUsers, fetchUsers] = useHttp('/users', {
  job: 'coder'
})
还可以给 useHttp 添加泛型,提供设置请求头等功能。
善用周边库
很多时候,程序员不知道现有的库能解决他们的问题,就自己造轮子,但很可能造出一个方的轮子 -- 问题轮子。又或者,他们不熟悉周边库的使用技巧,写出难以阅读的代码。
了解常用的周边库,掌握使用技巧,使很有必要的。使用广泛的库,经过社区千锤百炼,不太可能出现大问题,能帮你又快又好的解决问题。
如何选择你使用的库?或者如何做技术选型?这个话题可单独写一篇文章了。
删除无用的和重复的代码,保持项目轻量
代码量越大,维护成本就越高,保持代码库轻量,可以让项目更加容易维护。
删除无用的代码,不要过度设计等,可让项目轻量。
团队成员水平各异,随着人员流动,没有项目负责人统筹规划公共复用的代码时,极易出现各自重复造轮子的情况,相同的功能,不管是组件还是函数,都会重复存在。反正保持代码库轻量,关键在于项目的管理上。
让测试用例更加可读
测试代码应该具有可读性,方便他人舒服地改变或者添加测试用例。
站在使用者的角度编写用例
隐去具体细节,只给出测试的输入和输出。
有 vue 组件 Counter.vue :
<template>
  <button role="increment" @click="increment" />
  <button role="submit" @click="submit" />
</template>

<script>
  import {
    ref
  } from 'vue';
  export function submitValidator(value) {
    if (typeof value !== 'number') {
      throw Error(`Count should be a number. Got: ${count}`)
    }
    return true
  }
  export default {
    emits: {
      submit: submitValidator
    },
    setup(props, ctx) {
      const count = ref(0)
      // NOTE 触发自定义事件的方法命名
      // 1. onCustomEvent 和 触发的事件保持一致
      // 2. handleCustomEvent
      function submit() {
        ctx.emit('submit', this.count)
      }

      function increment() {
        count.value++
      }
      return {
        count,
        submit,
        increment
      }
    },
  }
</script>
测试用例:
// Counter.test.jsx
import {
  render
} from '@testing-library/vue'
import userEvent from '@testing-library/user-event'
import Counter, {
  submitValidator
} from './Counter.vue'

describe('Counter.vue', () => {
  it('emit with current count', async () => {
    // Arrange
    const {
      getByRole,
      user,
      emitted
    } = setup(<Counter/> )

    // Action
    await user.click(getByRole('increment'))
    await user.click(getByRole('submit'))

    // Assert
    expect(emitted('submit')[0]).toEqual([1])
  })
})

function setup(component) {
  const result = render(component)
  return {
    user: userEvent.setup(),
    ...result,
  }
}
组件挂载过程,封装了 setup ,隐去了挂载细节。
更好的组织测试代码
- 上面的组件测试,遵循了
3A法则编写用例,可读性更高。
① 准备测试环境(Arrange),比如挂载组件、模拟定时器、测试数据等。<br/>
② 执行相关操作(Action),比如点击按钮、输入表单等。<br/>
③ 断言结果(Assert)。<br/>
④ 以上代码,使用空行分割,保证可读性。<br/>
- 为特殊的输入,常见的 bug,编写用例,让使用者了解意外情况。
比如测试封装的浏览器存储:
// storage.ts
type StorageType = 'local' | 'session'

function set<V = unknown>(key: string, value: V, type: StorageType = 'session') {
  if (!key || typeof key !== 'string') throw new Error('必须有一个字符串参数 key')
  const jsonValue = JSON.stringify(value)
  if (type === 'local') {
    localStorage.setItem(key, jsonValue)
  } else if (type === 'session') {
    sessionStorage.setItem(key, jsonValue)
  } else {
    throw new Error('不支持的存储类型')
  }
  // NOTE  stringify 支持的值
  // 1, 对象 {...}
  // 2, 数组 [...]
  // 3, 字符串
  // 4, 数字
  // 5, 布尔值
  // 6, null

  // 被忽略的属性值
  // 1, undefined
  // 2, Symbol
  // 3, 函数
}

function get<V = string | null | unknown>(key: string, type: StorageType = 'session'): V {
  if (!key || typeof key !== 'string') throw new Error('必须有一个字符串参数 key')

  if (type === 'local') {
    try {
      let value = JSON.parse(localStorage.getItem(key)!)
      return value
    } catch (error) {
      return localStorage.getItem(key) as any
    }
  } else if (type === 'session') {
    try {
      let value = JSON.parse(sessionStorage.getItem(key)!)
      return value
    } catch (error) {
      return sessionStorage.getItem(key) as any
    }
  } else {
    throw new Error('不支持的存储类型')
  }
}

function clear(type: StorageType = 'session') {
  if (type === 'local') {
    localStorage.clear()
  } else if (type === 'session') {
    sessionStorage.clear()
  } else {
    throw new Error('不支持的存储类型')
  }
}

function remove(key: string, type: StorageType = 'session') {
  if (!key || typeof key !== 'string') throw new Error('必须有一个字符串参数 key')
  if (type === 'local') {
    localStorage.removeItem(key)
  } else if (type === 'session') {
    sessionStorage.removeItem(key)
  } else {
    throw new Error('不支持的存储类型')
  }
}

const storage = {
  get,
  set,
  clear,
  remove,
}

export { storage }
测试用例:
// storage.test.ts
import { storage } from './storage'
describe('storage', () => {
  describe('默认是 sessionStorage', () => {
    beforeEach(() => {
      sessionStorage.clear()
    })
    it('storage.set', () => {
      const value = 'hello'
      const key = 'sessionKey'
      storage.set(key, value)
      expect(sessionStorage.getItem(key)).toEqual(JSON.stringify(value))

      const key2 = 'sessionKey2'
      const value2 = {
        name: 'zqj',
      }
      storage.set(key2, value2)

      expect(storage.get(key2)).toEqual(value2)
    })

    it('storage.get', () => {
      const value = JSON.stringify('hello')
      const key = 'sessionKey'
      sessionStorage.setItem(key, value)

      expect(sessionStorage.getItem(key)).toEqual(value)
      expect(storage.get(key)).toEqual(JSON.parse(value))
    })
    it('storage.remove', () => {
      const key = 'sessionKey'
      const value = ['hello']
      storage.set(key, value)

      expect(storage.get(key)).toEqual(value)

      storage.remove(key)

      expect(storage.get(key)).toBeNull()
    })
    it('storage.clear', () => {
      const key = 'sessionKey'
      const value = ['hello']
      storage.set(key, value)
      const key2 = 'sessionKey2'
      const value2 = {}
      storage.set(key2, value2)

      expect(storage.get(key)).toEqual(value)
      expect(storage.get(key2)).toEqual(value2)

      storage.clear()

      expect(storage.get(key)).toBeNull()
      expect(storage.get(key2)).toBeNull()
    })
  })
  describe('设置 localStorage', () => {
    beforeEach(() => {
      localStorage.clear()
    })
    it('storage.set', () => {
      const value = 'hello'
      const key = 'sessionKey'
      storage.set(key, value, 'local')
      expect(localStorage.getItem(key)).toEqual(JSON.stringify(value))

      const key2 = 'sessionKey2'
      const value2 = {
        name: 'zqj',
      }
      storage.set(key2, value2, 'local')

      expect(storage.get(key2, 'local')).toEqual(value2)
    })

    it('storage.get', () => {
      const value = JSON.stringify('hello')
      const key = 'sessionKey'
      localStorage.setItem(key, value)

      expect(localStorage.getItem(key)).toEqual(value)
      expect(storage.get(key, 'local')).toEqual(JSON.parse(value))
    })
    it('storage.remove', () => {
      const key = 'sessionKey'
      const value = ['hello']
      storage.set(key, value, 'local')

      expect(storage.get(key, 'local')).toEqual(value)

      storage.remove(key, 'local')

      expect(storage.get(key, 'local')).toBeNull()
    })
    it('storage.clear', () => {
      const key = 'sessionKey'
      const value = ['hello']
      storage.set(key, value, 'local')
      const key2 = 'sessionKey2'
      const value2 = {}
      storage.set(key2, value2, 'local')

      expect(storage.get(key, 'local')).toEqual(value)
      expect(storage.get(key2, 'local')).toEqual(value2)

      storage.clear('local')

      expect(storage.get(key, 'local')).toBeNull()
      expect(storage.get(key2, 'local')).toBeNull()
    })
  })
  describe('设置错误的 type', () => {
    it('storage.set throw', () => {
      expect(() => storage.set('key', 'error', 'errorType' as any)).toThrowError()
    })
    it('storage.get throw', () => {
      storage.set('key', 'error')

      expect(() => storage.get('key', 'errorType' as any)).toThrowError()

      const value = 'error'
      sessionStorage.setItem('key2', value)
      expect(storage.get('key2')).toBe(value)

      // 不是一个合法的 json 字符串
      const valueObj = '{name: "zqj"}}'
      localStorage.setItem('key2', valueObj)
      // 部署合法的 JSON 字符串,返回原字符串,不进行 JSON.parse
      expect(storage.get('key2', 'local')).toBe(valueObj)
    })
    it('storage.remove throw', () => {
      storage.set('key', 'error')

      expect(() => storage.remove('key', 'errorType' as any)).toThrowError()
    })
    it('storage.clear throw', () => {
      expect(() => storage.clear('errorType' as any)).toThrowError()
    })
  })
  describe('没有提供 key', () => {
    it('storage.set() throw', () => {
      expect(() => storage.set('', 'value')).toThrowError()
      expect(() => storage.set(undefined as any, 'value')).toThrowError()
      expect(() => storage.set(null as any, 'value')).toThrowError()
    })
    it('storage.get() throw', () => {
      expect(() => storage.get('', 'session')).toThrowError()
      expect(() => storage.get(undefined as any, 'session')).toThrowError()
      expect(() => storage.get(null as any, 'session')).toThrowError()
      expect(() => storage.get(1 as any, 'session')).toThrowError()
    })
    it('storage.remove() throw', () => {
      expect(() => storage.remove('', 'session')).toThrowError()
      expect(() => storage.remove(undefined as any, 'session')).toThrowError()
      expect(() => storage.remove(null as any, 'session')).toThrowError()
      expect(() => storage.remove(1 as any, 'session')).toThrowError()
    })
  })
})
对没有 key 和错误的 type ,都是编写了用例。
给用例取一个好名字
如下的例子,都给 describe 和 it,取了一个好名字。
describe('submitValidator', () => {
  it('throw error when count is not number', function() {
    const actual = () => submitValidator('1')
    expect(actual).toThrowError()
  })

  it('return true when count is number', function() {
    const actual = () => submitValidator(1)
    expect(actual).not.toThrowError()
    expect(actual()).toBe(true)
  })
})
构造良好的测试输入
最好的输入,能覆盖所有的边界情况,同时保持输入最小。
上面的测试例子,两个用例就覆盖了所有情况。
让错误消息更加可读
代码的错误消息越具体,越可读,调试越容易,越容易修复。
美化错消息的输出格式
让代码可测试
代码设计良好,依赖越少,越容易测试。
可测试性差的代码特征:
| 特征 | 可测试性问题 | 设计问题 |
|---|---|---|
| 使用全局变量 | 每个用例都要重置全局变量,否则用例之间有影响 | 难以理解副作用 |
| 大作用域变量 | 和全局变量的类似 | 和全局变量的类似 |
| 外不依赖多 | 需要很多模拟代码 | 系统可能因为某个依赖失败而失败 |
| 代码有不确定性行为(随机数、时间戳) | 测试不可靠 | 程序难以推理,难以验证,难以调试 |
可测试性好的代码特征:
| 特征 | 对测试的好处 | 对设计的好处 |
|---|---|---|
| 类中只有少量和没有状态 | 容易编写测试 | 容易理解 |
| 类的接口简单正交,定义明确 | 有明确的行为可测试,用例少 | 易用 |
| 代码块只做一件事 | 用例更加少 | 耦合低,容易理解和组合 |
| 外部依赖少 | 模拟少,测试稳定 | 容易修改 |
| 函数少,参数正交 | 容易测试 | 容易使用 |
正交:数学上的概念,指两个向量垂直,不管它们如何变化,内积总是为零。
软件设计上的正交:两种变化不会相互影响。比如参数 a 的变化,不会影响参数 b 的效果。
正交系统的好处:系统设计达到了正交,说明达到了高内聚,低耦合,它是高内聚和低耦合原则的具体度量。系统的里依赖,可任意替换。
N 个函数和 M 个函数的功能正交,组合起来就能做 N*M 件事情,可见正交的设计,代码重用容易。
正交的设计,还可以有效避免被误用。好的设计应该正确使用很容易,错误使用很困难。
正交的设计易于测试和调试,因为很容易把问题定位到局部范围。
正交性是最重要的属性之一,可以帮助使复杂的设计紧凑。在纯正交设计中,操作没有副作用; 每个操作(无论是 API 调用、宏调用还是语言操作)只更改一件事,而不会影响其他操作。只有一种方法可以更改您正在控制的任何系统的每个属性。---《UNIX 编程艺术》
设计正交的系统非常难,不追求整体正交,但是一定要做到局部正交,比如函数的参数尽量要正交。
正交设计的四原则:
- 消除重复
不推荐彻底消除重复,实际上无法做到。适当重复,可保证代码可读性,重复是值得的。
- 分离关注点
- 缩小依赖范围
依赖范围小,意味着依赖容易替换,越容易修改。
全局变量,就是一种全局性的依赖,尽量避免。
纯函数的依赖只有参数,因此非常容易测试、推理。
- 向稳定的方向依赖
耦合点的变化,会导致依赖方跟着变化。耦合点稳定,依赖方受到耦合点变化的影响越小。
如何让依赖更趋于稳定:
站在需求的角度,而不是实现的角度定义依赖点(API),会让 API 更加稳定。
需求是不断变化的,必须对需求进行抽象和建模,找出其中本质的东西,才能使 API 更加稳定。
依赖的版本要稳定,属于这个原则吗?属于。
总结
从表面上提高代码的可读性
- 见名知义的名字
- 美观的排版
- 精简的注释
从代码结构上提高可读性
- 优化条件语句
- 减少嵌套
- 拆分超长表达式和语句
- 减少变量和缩小变量作用域
组织好代码
- 提取可复用的操作
- 保持代码块(函数、类、代码段落)的职责单一
- 善用周边库少造轮子
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论