CS224N-2017-笔记:04 Word Window分类与神经网络
文章目录
CS224N-2017-笔记:04 Word Window分类与神经网络
课程官网:http://web.stanford.edu/class...CS224N:深度自然语言处理课程(Natural Language Processing with Deep Learning)
个人学习的视频来自B站上雷锋字幕组的翻译,在此感谢课程的分享、翻译人员。
“Computers do not solve problems, they execute solutions.” --Laurent Gasser
- Lecture4 介绍了分类问题的背景与词窗口在其上的应用,并介绍了单层神经网络、反向传播和Max-Margin损失函数等内容。
1. 分类(Classification)问题介绍
分类问题的符号表示
- 训练集由样本组成: $\{x_i,y_i\}^N_{i=1}$
- $x_i$:$d$-维向量,表示输入,如词(指针或向量)、上下文窗口、句子、文档等。
- $y_i$:$C$-维独热向量,表示期待的预测结果。
分类问题的一般求解
-
简单的方法
- 词向量是固定的;
- 使用逻辑回归(logistic regression)方法;
- 一般是线性的决策边界(linear decision boundary)。
-
一般的机器学习方法
- 假设输入$x$是固定的,来训练逻辑回归的权重$W$;
- 只改变决策边界,而不改变词向量。
- 目标:对每个输入预测 $p(y|x)=\frac{\exp(W_y.x)}{\sum^C_{c=1}\exp(W_c.x)}$, $W\in \mathbb{R}^{C\times d}$
softmax和交叉熵损失函数
-
softmax的细节
- softmax:$p(y|x)=\frac{\exp(W_y.x)}{\sum^C_{c=1}\exp(W_c.x)}$
- 步骤一:$W$上的某行与输入$x$相乘,$W_y.x=\sum^d_{i=1}W_{yi}x_i=f_y$。
- 步骤二:进行归一化得到概率。
-
交叉熵损失 (cross-entropy error)
- 对每个输入例子$\{x,y\}$,目标是最大化输出正确的概率
- 即,最小化概率的负对数:$-\log p(y|x)=-\log(\frac{\exp(f_y)}{\sum^C_{c=1}\exp(f_c)})$
-
等价于交叉熵:$H(p,q)=-\sum^C_{c=1}p(c)\log q(c)$
- $p$为真实分布,即$y_i $,注意其为独热的;
- $q$为非真实分布,即$p(y|x)$。
$$ \begin{aligned} H(p,q)&=-\sum^C_{i=1}y_i\log(\frac{\exp(W_i.x)}{\sum^C_{c=1}\exp(W_c.x)})\\ &=-\log(\frac{\exp(f_y)}{\sum^C_{c=1}\exp(f_c)})\\ &=-\log(p(y|x)) \end{aligned} $$
-
KL-散度 (KL divergence)
- $D_{KL}(p||q)=\sum^C_{c=1}p(c)\log\frac{p(c)}{q(c)}$
分类问题
-
对全部N个样本:$J(\theta)=\frac{1}{N}\sum^N_{i=1}-\log(\frac{e^{f_{y_i}}}{\sum^C_{c=1}e^{f_c}})$
- $f_y=f_y(x)=W_{y.}x=\sum^d_{j=1}W_{yi}x_j$
- 即,$f=Wx$
- $J(\theta)=-\frac{1}{N}\sum_{i=1}^N\log(\frac{e^{Wx}}{\sum^C_{c=1}e^{Wx}})$
-
加上正则化(regularization)
- $J(\theta)=\frac{1}{N}\sum^N_{i=1}-\log(\frac{e^{f_{y_i}}}{\sum^C_{c=1}e^{f_c}})+\lambda\sum_k\theta^2_k$
- 加入正则化,防止过拟合(overfitting)
2. 词向量的改变
- 通过介绍上面分类问题中的传统机器学习方法,我们会发这些方法只是改变边界,而并没有学习、改变词向量,那么词向量的改变有什么必要,以及改变词向量有何难点呢?
机器学习&深度学习
- 在传统的机器学习问题中,参数矩阵的维度不会太大,但在深度学习中,需要同时学习权值矩阵和词向量,参数过多,容易发生过拟合。
-
一般的机器学习:
- 需要学习的$\theta$仅由权值矩阵$W$的每一列组成:$\theta=\begin{bmatrix}W_{.1}\\.\\.\\.\\W_{.d}\end{bmatrix}=W(:)\in\mathbb{R}^{Cd}$
- 只需要更新决策边界即可:$\triangledown_\theta J(\theta)=\begin{bmatrix}\triangledown_{W_{.1}\\.\\.\\.\\\triangledown_{W_{.d}}}\end{bmatrix}\in\mathbb{R}^{Cd}$
-
在深度学习中:
- 既要学习权值矩阵$W$,又要学习词向量$x$
- $\triangledown_\theta J(\theta)=\begin{bmatrix}\triangledown_{W_{.1}}\\.\\.\\\triangledown_{W_{.d}}\\\triangledown_{x_{aaradvark}}\\.\\.\\\triangledown_{x_{zebra}}\end{bmatrix}\in\mathbb{R}^{Cd+Vd}$
- 其中,由于$Vd$很大,使得容易发生过拟合(对小数据量的情况,不必再重新训练词向量,否则容易导致过拟合。如telly、TV、television中,如果训练集只含有telly和TV,会导致televison被分离开)。
词向量相关
-
词向量矩阵$L$也被称为Lookup table。
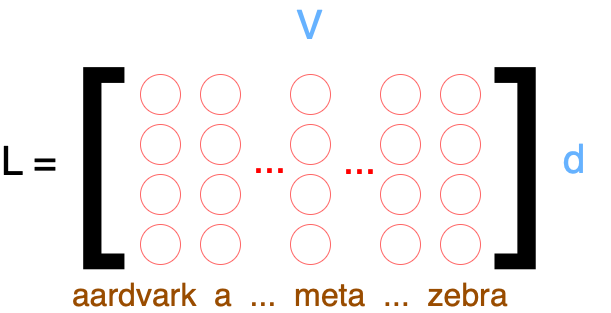
- 词向量(word vectors) = 词嵌入(word embeddings) = 词表示(word representations, mostly)
- 大部分使用和word2vec和Glove相似的方法(新的模型,基于字母的模型,character models)。
3. 基于窗口的分类(Window Classification)
基于上下文窗口的分类
- 由于在上下文中产生的歧义(ambiguity)问题,对单个词进行分类很少使用。所以,我们通过一个词的上下文窗口来进行分类(如在命名实体识别任务中,分成四个类Person, location, organization, none)。
-
训练一个分类器(classifier),通过给中心词加上标签并将其周围的词向量连接起来,如,

- $x_{window}=x\in\mathbb{R}^{5d}$,是个列向量。
最简单的窗口分类器:Softmax
- 对$x=x_{window}$,使用Softmax分类器:$\hat y_y=p(y|x)=\frac{\exp(W_{y.}x)}{\sum^C_{c=1}\exp(W_{c.}x)}$
- 交叉熵损失:$J(\theta)=\frac{1}{N}\sum^N_{i=1}-\log(\frac{e^{f_{y_i}}}{\sum^C_{c=1}e^{f_c}})$,其中$f_{y_i}=W_{y.}x$
-
更新词向量的方法:使用梯度(derivatives)
$$ \begin{aligned} \triangledown_xJ=\frac{\partial J}{\partial x}&=\frac{\partial}{\partial x}-\log softmax(f_y(x))\\ &=\sum^C_{c=1}-\frac{\partial\log softmax(f_y(x))}{\partial f_c}\cdot\frac{\partial f_c(x)}{\partial x}\\ &=\begin{bmatrix}\hat y_1\ ...\ \hat y_y-1\ ...\ \hat y_C\end{bmatrix}^T\cdot\frac{\partial f_c(x)}{\partial x}\\ &=[\hat y-t]\cdot\frac{\partial f_c(x)}{\partial x}\\ &=\delta\cdot\frac{\partial f_c(x)}{\partial x}\\ &=\sum^C_{c=1}\delta_cW_c^T\\ &=W^T\delta\in\mathbb{R}^{5d} \end{aligned} $$
-
所以,
- 对 $\triangledown_xJ=W^T\delta=\delta_{x_{window}}$, $x_{window}=[x_{museums}\ x_{in}\ x_{Paris}\ x_{are}\ x_{amazing}]$
- 有 $\delta_{window}=\begin{bmatrix}\triangledown _{x_{museums}}\\\triangledown_{x_{in}}\\\triangledown _{x_{Paris}}\\\triangledown _{x_{are}}\\\triangledown _{x_{amazing}}\end{bmatrix}\in\mathbb{R}^{5d}$, $\triangledown_\theta J(\theta)=\begin{bmatrix}\triangledown _{W_{.1}}\\.\\.\\\triangledown_{W_{.d}}\\\triangledown_{x_{aardvark}}\\.\\.\\\triangledown_{x_{zebra}}\end{bmatrix}\in\mathbb{R}^{Cd+Vd}$
- 这样就可以用梯度进行更新了
- 其中矩阵计算$f=Wx$和指数运算代价最大。
-
-
单独Softmax (= logistic regression) 的局限性
- 在数据空间中,Softmax只给出了一个线性决策边界;
- 只有较少数据下效果才能比较好,但对大量数据,仍是局限。
4. 神经网络
- 神经网络相比softmax可以学习更加复杂的函数和非线性(nonlinear)的决策边界。
从逻辑回归到神经网络
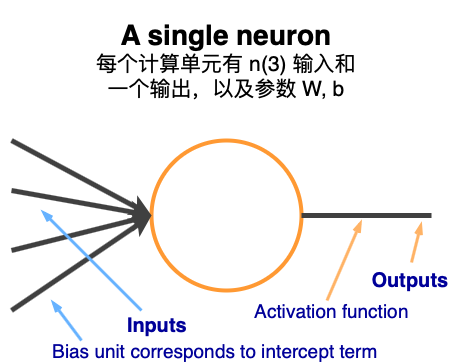
- 单个神经元:
-
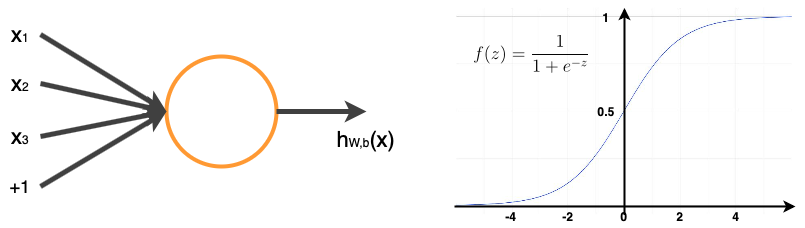
每个神经元都是一个二分类逻辑回归单元(binary logistic regression unit):
- $h_{w,b}(x)=f(w^T+b)$, $f(z)=\frac{1}{1+e^{-z}}$
- $b$:偏差项;$W,b$:神经元的参数
-
神经网络 = 同时运行多个逻辑回归
- 将一组向量为给一组逻辑回归函数,然后得到一组向量输出。
- 不是由我们提前决定这些逻辑回归函数具体要预测什么,而是由损失函数直接决定要得到什么结果。
- 就有如下的多层网络:
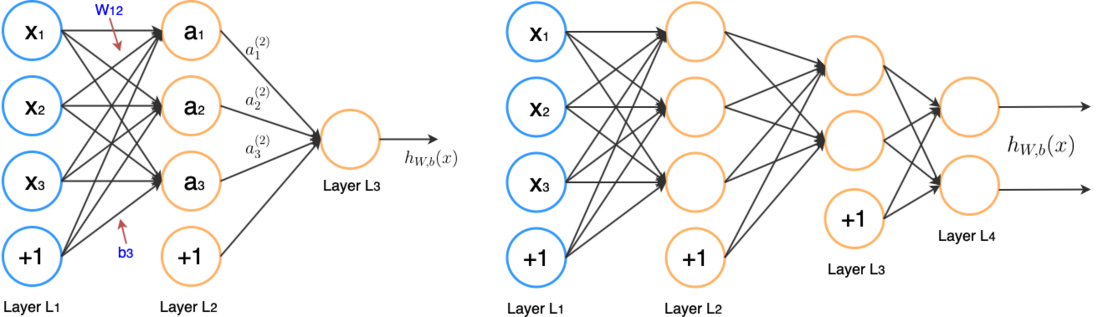
-
其中:
- $a_1=f(W_{11}x_1+W_{12}x_2+W_{13}x_2+b_1)$
- $a_2=f(W_{21}x_1+W_{22}x_2+W_{23}x_2+b_2)$
- etc.
- 用矩阵符号表示:$z=Wx+b$, $a=f(z)$
- $f([z_1,z_2,z_3])=[f(z_1),f(z_2),f(z_3)]$
非线性函数(Non-linearities)
- 如果不使用非线性函数,那么深度网络将等效于线性转换。
- 使用非线性函数,是因为如果使用线性函数,那么所有层都等效为一层:$W_1W_2x=Wx$
- 更多层,可以更好地拟合复杂的函数。
单层神经网络(Single Layer Neural Network)
- 一个单层神经网络由一个线性层($z=wx+b$)和一个非线性($a=f(z)$)组成。
-
其中,神经激活(neural activations)$a$可以用来计算一些输出。
- 如,通过softmax计算可能性:$pyx=softmax(Wa)$
- 或,非规范的分数(unnormalized score):$score(x)=U^Ta\in\mathbb{R}$
-
前向传播网络(Feed-forward)
- 计算一个三层的神经网络:$s=score($museums in Paris are amazing$)$

- $U$:隐藏层到class的权值矩阵;$a$:激活函数
间隔最大损失函数(max-margin loss)
-
得分:
- 正确分类的得分:$s=score($museums in Paris are amazing$)$
- 错误分类的得分:$s=score($Not all museums in Paris$)$
- 训练想法:最大化正确得分,最小化错误得分。
-
即最小化$J=\max(0,1-s+s_c)$
- 损失函数连续的,使用随机梯度下降(SGD)求解
- $s=U^Tf(Wx+b)$;$s_c=U^Tf(Wx_c+b)$
- $+1$使得位于中心的词能够比不在中心的词得分高
5. 反向传播(Backpropagation)
-
$J=\max(0,1-s+s_c) $
- $s=U^Tf(Wx+b)$
- $s_c=U^Tf(Wx_c+b)$
-
反向传播的推导
- $\frac{\partial s}{\partial U}=\frac{\partial}{\partial U}U^Ta$, $\frac{\partial s}{\partial U}=a$
- $\frac{\partial s}{\partial W}=\frac{\partial}{\partial W}U^Ta=\frac{\partial}{\partial W}U^Tf(z)=\frac{\partial}{\partial W}U^Tf(Wx+b)$
-
$W_{ij}$的导数:$\frac{\partial}{\partial W_{ij}}U^Ta\rightarrow \frac{\partial}{\partial W_{ij}}U_ia_i$
$$ \begin{align} U_i\frac{\partial}{\partial W_{ij}}a_i &=U_i\frac{\partial a_i}{\partial z_i}\frac{\partial z_i}{\partial W_{ij}}\\ &=U_i\frac{\partial f(z_i)}{\partial z_i}\frac{\partial z_i}{\partial W_{ij}}\\ &=U_if'(z_i)\frac{\partial z_i}{\partial W_{ij}}\\ &=U_if'(z_i)\frac{\partial W_{i.}x+b_i}{\partial W_{ij}}\\ &=U_if'(z_i)\frac{\partial}{\partial W_{ij}}\sum_kW_{ik}x_k\\ &=U_if'(z_i)x_j\\ &=\delta_ix_j \end{align} $$
- $\delta_i$: local error signal, $x_j$: local input signal
- $f'(z)=f(z)(1-f(z))$ for logistic $f$
-
用反向传播训练
- 用更高层的计算梯度的结果来计算低层的梯度。
-
推导:
$$ \begin{align} \frac{\partial s}{\partial x_j} &=\sum^2_{i=1}\frac{\partial s}{\partial a_i}\frac{\partial a_i}{\partial x_j}\\ &=\sum^2_{i=1}\frac{\partial U^Ta}{\partial a_i}\frac{\partial a_i}{\partial x_j}\\ &=\sum^2_{i=1}U_i\frac{\partial f(W_{i.}x+b)}{\partial x_j}\\ &=\sum^2_{i=1}U_if'(W_{i.}x+b)\frac{\partial W_{i.}x}{\partial x_j}\\ &=\sum^2_{i=1}\delta_iW_{ij}\\ &=W_{.j}^T\delta \end{align} $$
- 可以发现$\delta$(error message)到达隐藏层和这层的相同。
-
$U$的求导:
- $\frac{\partial J}{\partial U}=1\{1-s+s_c>0\}(-f(Wx+b)+f(Wx_c+b))$
- $\frac{\partial J}{\partial U}=1\{1-s+s_c>0\}(-a+a_c)$
关于反向传播,下一节还有更深入的讲解,所以这里的推导不清楚也不用慌张。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论