pandas_merge函数_内存开销过大

文章目录
问题描述
这两天在处理数据时需要将两个表进行相关合并,很自然的想到用merge函数进行合并,两个数据分别为
- 训练集

- 测试集
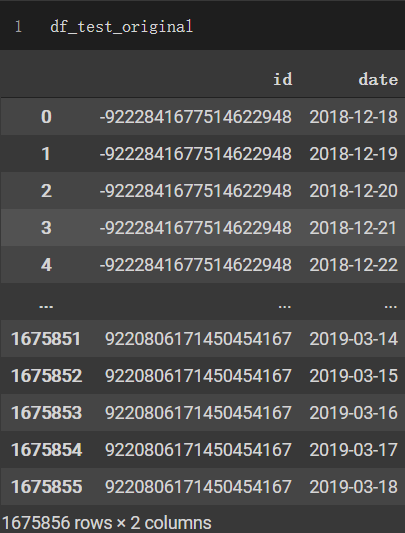
我们的任务需求时将训练集中节点id对应的type转换到测试集当中。这是用merge函数来写的话,代码为
df_test_original.merge(df_train_original, how='left', on='id')其中how代表以左边表格为标准,将右边表格中键值相同的value拼接过来。on代表拼接的键值。 这个代码本身是没错的,但碍于内存限制(测试用的16G),会出现内存溢出的报错。
解决方案
- 训练集
出现上述问题最主要的原因是要拼接的训练集当中重复数据太多。对于每一个id我们只需要直到一行数据,即可以得到其对应的type值,而在1000万行数据中仅仅只有1万多个不同的id值,因此我们在拼接之前首先作删重处理。然后再进行拼接,代码为
df_train = df_train_original.drop_duplicates(subset=
['id'],keep='first',inplace=False)
处理过后的训练集为

这样我们再进行拼接
既可以得到最终的结果。
总结
以后用到merge时,首先想到将需要补充的信息表进行去重操作。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论