伪元素 content 出现中文乱码
文章目录
伪元素的 content 使用中文字符在某些浏览器可能会出现乱码:
代码如下:
.test:before {
  content: '计算结果=';
}
解决方法
首先,确认 charset 为 utf-8
确保 HTML 的 META 属性设置为 charset='utf-8'。
经测试,还是会出现乱码。
然后,将中文字符转成 Unicode 编码
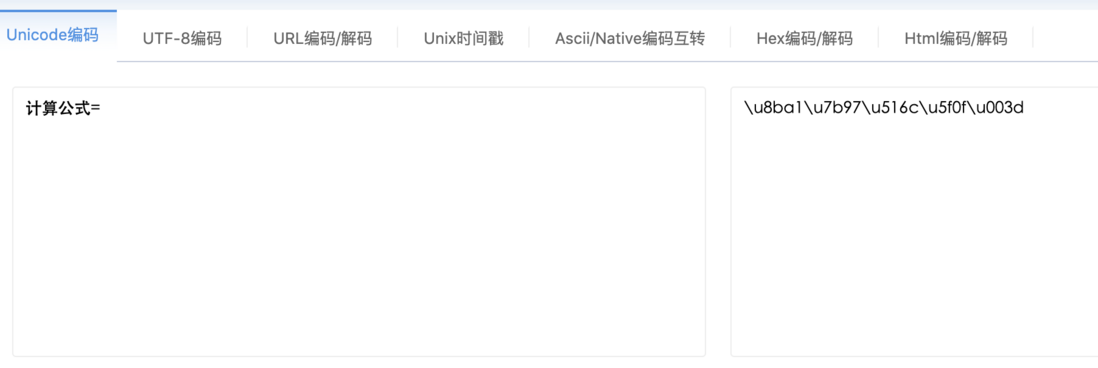
拿到转化后的 Unicode 编码,去掉 u:
.test:before {
  content: '\8ba1\7b97\7ed3\679c\003d';
}
经测试,还是会出现乱码。
然后,通过 attr 获取元素属性内容
<div class='test' data-before='计算结果=' />

.test:before {
  content: attr(data-before);
}
如果还会出现乱码, 就放弃使用伪元素吧.......
attr
属性函数 attr() 用于获取 HTML 元素里面的属性值并用于样式中。MDN文档
attr() 理论上能用于所有的 CSS 属性但目前支持的仅有伪元素的 content 属性,其他的属性和高级特性目前是实验性的。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论