CS224N-2017-笔记:06 句法分析
文章目录
CS224N-2017-笔记:06 句法分析
课程官网:http://web.stanford.edu/class...CS224N:深度自然语言处理课程(Natural Language Processing with Deep Learning)
个人学习的视频来自B站上雷锋字幕组的翻译,在此感谢课程的分享、翻译人员。
I think that it's extraordinarily important that we in computer science keep fun in computing. When it started out, it was an awful lot of fun. -- Alan J. Perlis, SICP序言
- Lecture 6 介绍了句法分析和依存句法解析器。
1. 句法结构
一致与依赖
- 描述语法结构(Phrase Structure)有两种观点,一致(constituency)和依存(dependency)。
-
一致
- 术语:一致 Constituency = 短语结构文法 phrase structure grammar = 上下文无关文法 context-free grammars (CFGs)
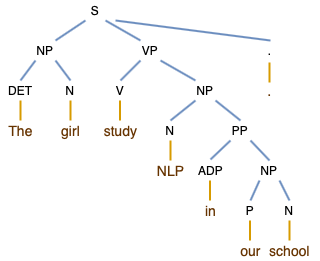
- 短语结构使用规则把单词组成为嵌套成分(nested constituents)
- 一个短语结构树示例如下,
-
依存
- 依存结构展示一个词和其他词的依赖关系,即一个词如何修饰另一个词,而非嵌套关系。
- 示意图如下,

歧义(Ambiguity)
-
示例:介词短语依附(PP attachments)

-
依附歧义(Attachment Ambiguities)
- 语法解析的一个关键点是:如何将不同的成分加上(attach),如介词短语、状语/分词短语、不定式、连词等。
-
示例
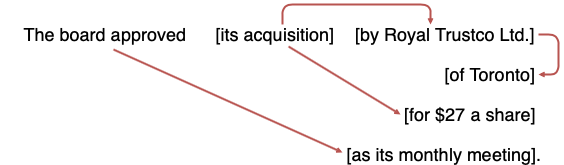
- 依附可能性为卡兰特数(Catalan number):$C_n=(2n)!/[(n+1)!n!]$
标注数据集:Universal Dependencies treebanks
- [Universal Dependencies: http://universaldependencies.... ; cf. Marcus et al. 1993, The Penn Treebank, Computational Linguistics]
- 建立这样的树库比建立一个文法看似慢得多,也没有很大用处;
-
但这样的树库具有以下优点:
- 可重用性
- 更广的覆盖率,而不只是一种直觉认知
- 更频繁、更广泛的信息
- 提供一种评估系统的方式
2. 依存语法(Dependency Grammar)
依存语法和依存结构
-
依存语法(dependency syntax)假设语法结构由词汇项(lexical items)之间的关系构成,通常这种二元非对称(binary asymmetric)的关系被称为依存关系(dependencies),箭头表示。
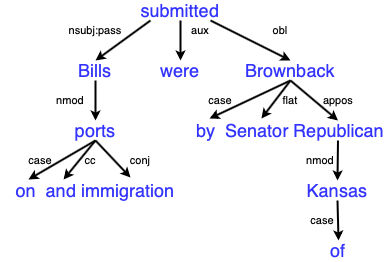
- 箭头上表示的是语法关系(grammatical relations)。
- 箭头包含head(被修饰的对象)和dependent(修饰词)。
- 绘制方法可能不同,一半会增加一个fake ROOT。
依存语法/解析的历史
-
依存结构思想的起源可以追溯到:
- Pāṇini’s grammar (c. 5th century BCE)
- 公元1000年左右的阿拉伯文法学家
- 而上下文无关语法是20世纪的发明(R. S. Wells, 1947)
- 现代依存文法工作的建立人是 L. Tesnière (1959),是东方语言(俄语、汉语等)的主要方法,对更自由的语言效果更好。
- 自然语言处理早期的解析器,也是依存解析器(David Hays, 1962)
依存解析的信息来源
- 双词汇亲和(Bilexical affinities):两个词之间的关系,如discussion与issues;
- 词语间距(Dependency distance):一般依存关系位于相邻词之间;
- 中间物质(Intervening material):以来很少跨越位于中间的动词或标点;
- 箭头的价(? Valency of heads):一个head的依赖个数一般是有限的。
依存解析(Dependency Parsing)
- 一句话的解析通过逐一选择每个词,然后分析其它词和它的依存关系(包括ROOT)。
-
一般分析的约束:
- 只有一个词依赖ROOT;
- 不出现环,无环 (即依赖结构是一棵树)。
- 若箭头可以交叉则为non-projective,反之为non-projectice。
依存解析的方法
- 动态规划 (Dynamic Programming):Eisner于1996年提出的一种复杂度为$O(n^3)$的方法,通过在末尾产生head而不是在中间产生;
- 图算法 (Graph algorithms):McDonald等人在2005年提出的MSTParser使用ML分类器对依赖项单独评分(他使用了MIRA来在线学习,但也可以使用其他的方法);
- 约束适应 (Constraint Satisfaction):Karlsson于1990年提出,去除不满足硬约束的边;
- Transition-based parsing 或 "deterministic dependency parsing":Nivre等人在2008年提出的MaltParser,指导贪婪算法,被证明很有效。
3. 基于转移的依存解析
Greedy transition-based parsing [Nivre 2003]
- 是贪婪判别依存解析器(greedy discriminative dependency parser)的一种简单形式。
- 执行一系列的bottom-up操作:大致类似于移入-规约解析器(shift-reduce parser)中的移入、规约操作,但规约操作专门用于创建head左或右的依存项。
-
解析器含有:
- 栈$\sigma$,以ROOT符号开始,右边为栈顶;
- 缓存$\beta$,以输入序列开始,左边为顶部;
- 依存弧集合(dependency arcs)$A$,一开始为空;
- 一组操作(actions)
-
基本基于转移的依存解析器
开始:$\sigma=[ROOT]$, $\beta=w_1,w_2, ..., w_n$, $A=\emptyset$
-
移入 shift: $\sigma,w_i|\beta,A\rightarrow\sigma|w_i,\beta,A$
将缓存中第一个词移入到栈上
- Left-Arc$_r$: $\sigma|w_i|w_j,\beta,A\rightarrow\sigma|w_j,\beta,A\cup\{r\{w_j,w_i\}\}$
- Right-Arc$_r$: $\sigma|w_i|w_j,\beta,A\rightarrow\sigma|w_i,\beta,A\cup\{r\{w_i,w_j\}\}$
终止:$\sigma=[w]$, $\beta=\emptyset$
-
移入 shift: $\sigma,w_i|\beta,A\rightarrow\sigma|w_i,\beta,A$
-
弧标准的基于转移的解析器(Arc-standard transition-based parser)示例

- 也可以用其他方法
MaltParser [Nivre and Hall 2005]
- 对下一个动作的选择进行预测
-
每个动作都由独立的分类器(一般是SVM,也可以是感知机perceptron、最大熵分类器MaxEnt Classifier等)对每个合法移动进行预测
- 最多三种无类型的选择,有类型时最多$|R|\times2+1$种;
- 特征:栈顶单词,POS;缓存中第一个单词,POS;等。
- 在最简单的形式中没有搜索,但也可以用beam search(速度慢但效果更好)
- 很快的线性解析时间
- 模型的精度略低于最好的依存解析,但速度快,接近于最好的解析表现
特征表示
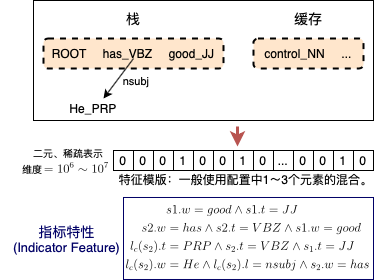
依存解析的评价:带标记的依存精度
-
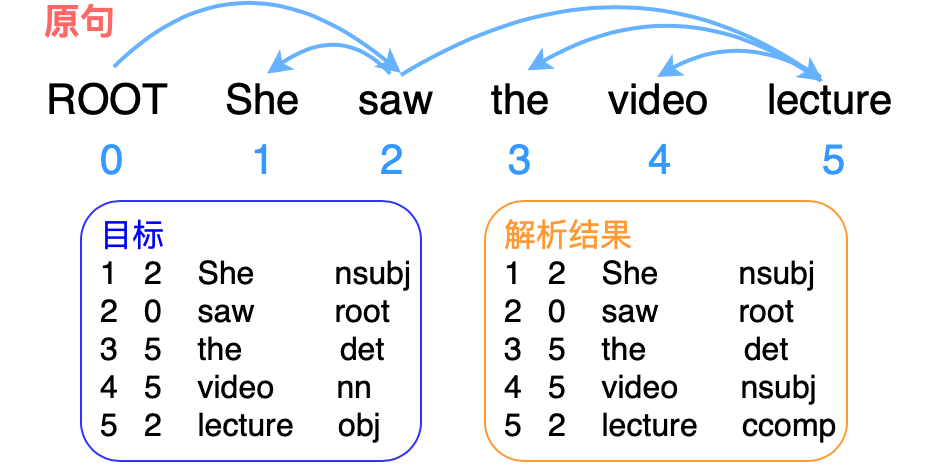
原句和结果示例
-
评价
- 精度:$Acc=\frac{\#\ correct\ deps}{\#\ of\ deps}$
- 无标记依存正确率(unlabeled attachment score):$UAS=4/5=80\%$
- 有标记依存正确率(labeled attchment score):$LAS=2/5=20\%$
投射(projectivity)和非投射(non-projectivity)
- 依存弧识别语义关系的例子--判断蛋白质的相互作用[Erkan et al. EMBLP 07, Fundel et al. 2007, etc.]
-
投射性(projectivity)
- 与CFG相近的依存树一定是投射性的(在单词线性顺序排布时,没有交叉的弧);
- 但依存理论也允许非投射的结构
-
非投射性(non-projectivity)的处理
- 弧标准(arc-standard)算法只能构建投射性的依存树。
- head可能的方向(emmm,这里就不记了)
4. 神经网络依存解析器
使用神经网络依存句法解析器的原因
- 传统指标特性稀疏;
- 指标不完全;
- 计算复杂(超过95%的解析时间花在了特征计算)
- 解决方法:学习一种稠密(dense)、复杂(compact)的特征表示。
神经网络依存句法解析器
- A neural dependency parser [Chen and Manning 2014]
- 优势:以更快的速度极为接近最好的结果。
-
分布式表示(Distributed Representations)
- 用一个$d$维的稠密向量表示每个词(如词嵌入),相近的词被表示为相近的向量;
- 词性标签(part-of-speech tags, POS)和依存标签(dependency labels)也表示为$d$维向量,较小的离散集也表现出许多语义上的相似性。
- NNS(复数名词)和NN(单数名词)相近;num(数值修饰符)和amod(形容词修饰符)相近。
-
向量表示
- 基于栈/缓存位置提取一系列令牌(tokens)
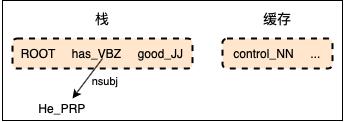
-
拼接单词、词性、依存标签的向量表示(传统方法拼接原内容)
$$ \begin{aligned} &\quad\ word\quad\quad\quad\ \ POS\quad\quad\quad\ dep. \\ \begin{bmatrix}s_1\\s_2\\b_1\\l_c(s_1)\\r_c(s_1)\\l_c(s_2)\\r_c(s_2)\end{bmatrix} \rightarrow &\begin{bmatrix}good\\has\\control\\\emptyset\\\emptyset\\He\\\emptyset\end{bmatrix}+ \begin{bmatrix}JJ\\VBZ\\NN\\\emptyset\\\emptyset\\PRP\\\emptyset\end{bmatrix}+ \begin{bmatrix}\emptyset\\\emptyset\\\emptyset\\\emptyset\\\emptyset\\nsubj\\\emptyset\end{bmatrix} \end{aligned} $$
- 基于栈/缓存位置提取一系列令牌(tokens)
-
模型结构(Model Archicture)
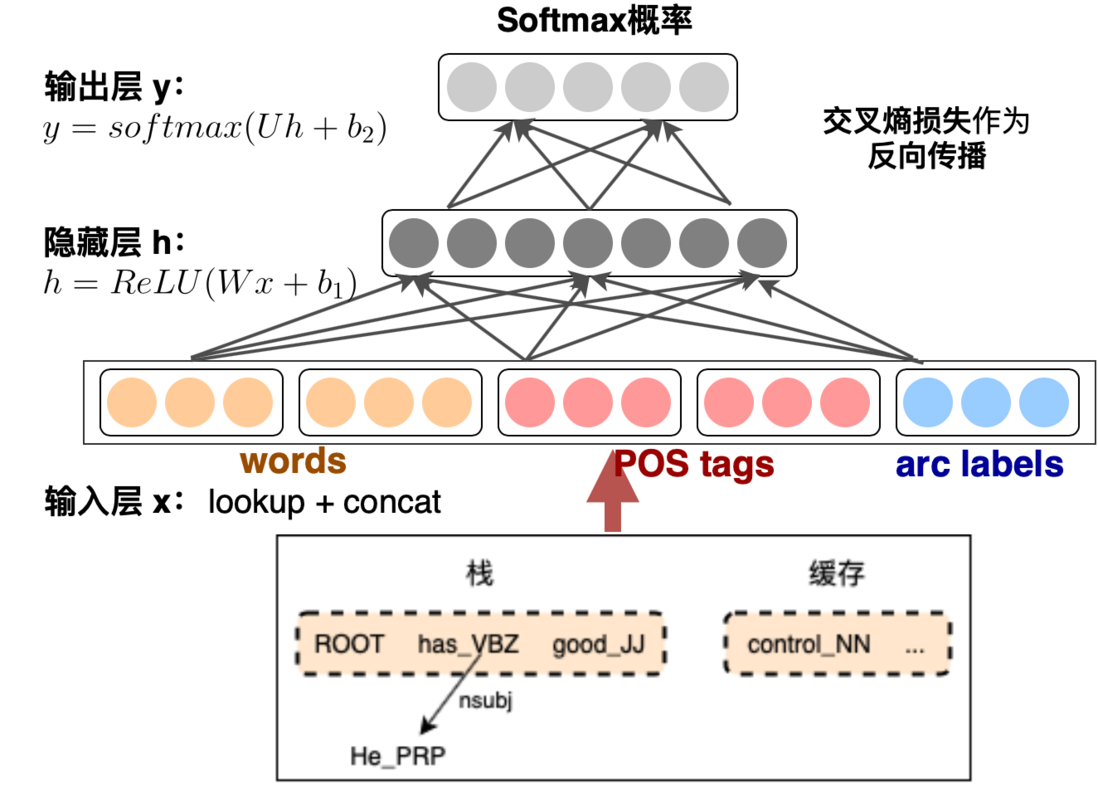
-
各层间的非线性函数
-
使用原因:
- 如果不使用非线性函数,那么深度网络将等效于线性转换。
- 使用非线性函数,是因为如果使用线性函数,那么所有层都等效为一层:$W_1W_2x=Wx$
- 更多层,可以更好地拟合复杂的函数。
-
非线性函数

-
未来工作
- 更大更深的网络与更好调参的超参数;
- Beam Search;
- 在决策序列全局进行CRF(conditional random field)。
间隔了一段时间后的整理,在被CV烦恼一段时间后再回看NLP,舒服~一些解析器应该还要实际实现后才能更清楚。
参考资料:
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论