elasticsearch的配置解析
文章目录
一些基础性配置
################################### 集群相关配置 ###################################
# cluster.name可以确定你的集群名称,当你的elasticsearch集群在同一个网段中elasticsearch会自动的找到具有相同cluster.name的elasticsearch服务.
# 所以当同一个网段具有多个elasticsearch集群时cluster.name就成为同一个集群的标识.,可以手动指定也可以自动生成
# cluster.name: elasticsearch

#################################### 节点相关配置 #####################################
# 节点名称同理,可自动生成也可手动配置.
# node.name: node-1

# 允许一个节点是否可以成为一个master节点,es是默认集群中的第一台机器为master,如果这台机器停止就会重新选举master.
# node.master: true

# 允许该节点存储数据(默认开启)
# node.data: true

# 默认情况下,多个节点可以在同一个安装路径启动,如果你想让你的es只启动一个节点,可以进行如下设置
# node.max_local_storage_nodes: 1

#################################### 索引相关配置 ####################################
# 设置索引的分片数,默认为5
#index.number_of_shards: 5

# 设置索引的副本数,默认为1:
#index.number_of_replicas: 1

# 配置文件中提到的最佳实践是,如果服务器够多,可以将分片提高,尽量将数据平均分布到大集群中去
# 同时,如果增加副本数量可以有效的提高搜索性能
# 需要注意的是,"number_of_shards" 是索引创建后一次生成的,后续不可更改设置
# "number_of_replicas" 是可以通过API去实时修改设置的

#################################### 路径相关配置 ####################################
# 配置文件存储位置
# path.conf: /path/to/config

# 数据存储位置(单个目录设置)
# path.data: /path/to/data
# 多个数据存储位置,有利于性能提升
# path.data: /path/to/data1,/path/to/data2

# 临时文件的路径
# path.work: /path/to/work

# 日志文件的路径
# path.logs: /path/to/logs

# 插件安装路径
# path.plugins: /path/to/plugins


################################### 内存相关配置 ####################################
# 当JVM开始写入交换空间时(swapping)ElasticSearch性能会低下,你应该保证它不会写入交换空间
# 设置这个属性为true来锁定内存,同时也要允许elasticsearch的进程可以锁住内存,linux下可以通过 `ulimit -l unlimited` 命令
# bootstrap.mlockall: true
# 确保 ES_MIN_MEM 和 ES_MAX_MEM 环境变量设置为相同的值,以及机器有足够的内存分配给Elasticsearch
# 注意:内存也不是越大越好,一般64位机器,最大分配内存别才超过32G
############################## 网络相关配置 ###############################
# 设置绑定的ip地址,可以是ipv4或ipv6的,默认绑定本机ip
# network.bind_host: 192.168.0.1
# 设置其它节点和该节点交互的ip地址,如果不设置它会自动设置,值必须是个真实的ip地址
# network.publish_host: 192.168.0.1
# 同时设置bind_host和publish_host上面两个参数
# network.host: 192.168.0.1    #绑定监听IP
# 设置节点间交互的tcp端口,默认是9300
# transport.tcp.port: 9300
# 设置是否压缩tcp传输时的数据,默认为false,不压缩
# transport.tcp.compress: true
# 设置对外服务的http端口,默认为9200
# http.port: 9200
# 设置请求内容的最大容量,默认100mb
# http.max_content_length: 100mb
# 使用http协议对外提供服务,默认为true,开启
# http.enabled: false

# 集群中其他主机所在的ip
# discovery.zen.ping.unicast.hosts: [ "10.179.100.148", "10.179.100.212", "10.179.100.42"]

如果网络的故障导致一个集群被划分成两片,每片都有多个node,以及一个master。因为master是维护集群状态,以及shard的分配。如果出现了两个master,可能导致数据破损。
discovery.zen.minimum_master_nodes的作用是只有足够的master候选节点时,才可以选举出一个master。该参数必须设置为集群中master候选节点的quorum数量。
quorum的算法=master候选节点数量/2+1
# Prevent the "split brain" by configuring the majority of nodes (total number of master-eligible nodes / 2 + 1): 一定要过半数

discovery.zen.minimum_master_nodes: 2
discovery.zen.minimum_master_nodes参数解析
脑裂的成因分析
如果因为网络的故障,导致一个集群被划分成了两片,每片都有多个node,以及一个master,那么集群中就出现了两个master了。
但是因为master是集群中非常重要的一个角色,主宰了集群状态的维护,以及shard的分配,因此如果有两个master的化,可能会导致破坏数据。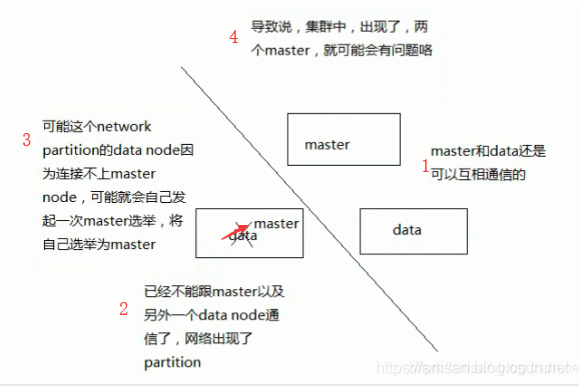
重要参数:discovery.zen.minimum_master_nodes
discovery.zen.minimum_master_nodes参数对于集群的可靠性来说,是非常重要的。这个设置可以预防脑裂问题,也就是一个集群中存在两个master。
配置文件中的注释如下: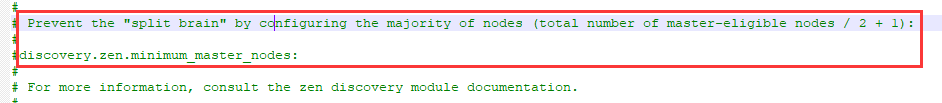
Prevent the "split brain" by configuring the majority of nodes (total number of master-eligible nodes / 2 + 1):
discovery.zen.minimum_master_nodes:
这个参数的作用,就是告诉es直到有足够的master候选节点时,才可以选举出一个master,否则就不要选举出一个master。
这个参数必须被设置为集群中master候选节点的quorum数量,也就是大多数。至于quorum的算法,就是:master候选节点数量 / 2 + 1。
举例说明
比如我们有10个节点,都能维护数据,也可以是master候选节点,那么quorum就是10 / 2 + 1 = 6。
如果我们有三个master候选节点,还有100个数据节点,那么quorum就是3 / 2 + 1 = 2
如果我们有2个节点,都可以是master候选节点,那么quorum是2 / 2 + 1 = 2。此时就有问题了,因为如果一个node挂掉了,那么剩下一个master候选节点,是无法满足quorum数量的,也就无法选举出新的master,集群就挂掉了(可读不可写)。此时就只能将这个参数设置为1,但是这就无法阻止脑裂的发生了。
2个节点,discovery.zen.minimum_master_nodes分别设置成2和1会怎么样?
见下图
设置成2的场景, 无法发起选举,没有master了。 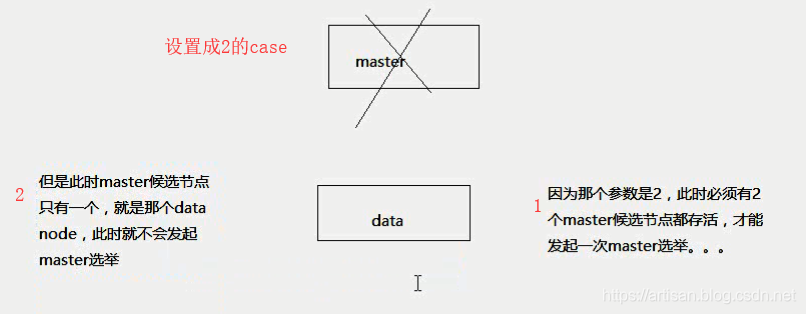
设置为1的场景,不可避免脑裂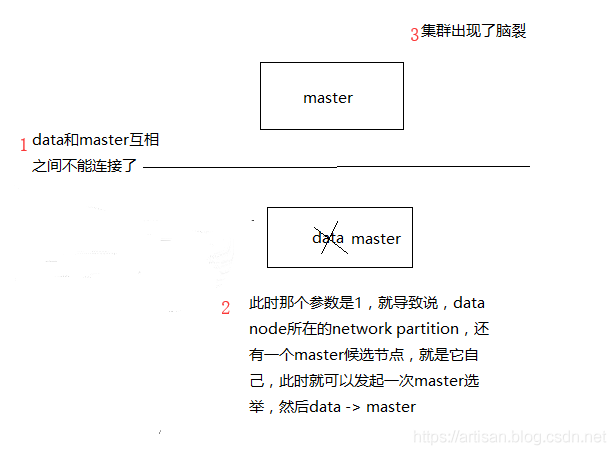
综上所述,一个生产环境的es集群,至少要有3个节点,同时将这个参数设置为quorum,也就是2。discovery.zen.minimum_master_nodes设置为2,如何避免脑裂呢?
3个节点,discovery.zen.minimum_master_nodes设置为2,是如何避免脑裂?
那么这个是参数是如何避免脑裂问题的产生的呢?比如我们有3个节点,quorum是2.现在网络故障,1个节点在一个网络区域,另外2个节点在另外一个网络区域,不同的网络区域内无法通信。这个时候有两种情况情况:
(1)如果master是单独的那个节点,另外2个节点是master候选节点,那么此时那个单独的master节点因为没有指定数量的候选master node在自己当前所在的集群内,因此就会取消当前master的角色,尝试重新选举,但是无法选举成功。然后另外一个网络区域内的node因为无法连接到master,就会发起重新选举,因为有两个master候选节点,满足了quorum,因此可以成功选举出一个master。此时集群中就会还是只有一个master。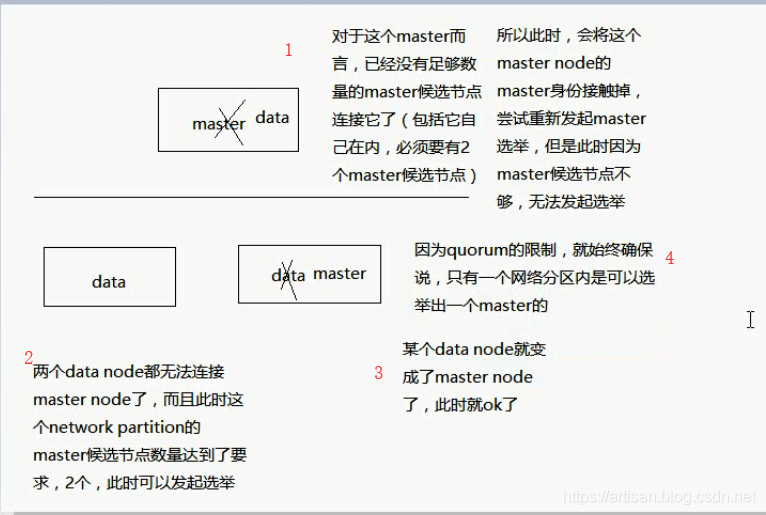
(2)如果master和另外一个node在一个网络区域内,然后一个node单独在一个网络区域内。那么此时那个单独的node因为连接不上master,会尝试发起选举,但是因为master候选节点数量不到quorum,因此无法选举出master。而另外一个网络区域内,原先的那个master还会继续工作。这也可以保证集群内只有一个master节点。
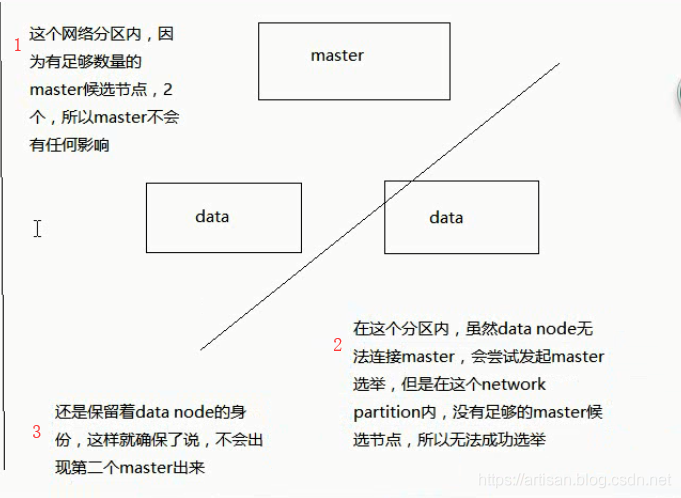
综上所述,通过在elasticsearch.yml中配置discovery.zen.minimum_master_nodes: 2,就可以避免脑裂问题的产生。
动态设置discovery.zen.minimum_master_nodes
但是因为es集群是可以动态增加和下线节点的,所以可能随时会改变quorum。所以这个参数也是可以通过api随时修改的,特别是在节点上线和下线的时候,都需要作出对应的修改。而且一旦修改过后,这个配置就会持久化保存下来。
PUT /_cluster/settings
{
"persistent" : {
    "discovery.zen.minimum_master_nodes" : 2
}
}
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论