WGAN的训练以及对列表数据的数据增强
文章目录
判别器:
class Discriminator(nn.Module):
    def __init__(self, input_dim):
        super(Discriminator, self).__init__()
        self.model = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, 32),
            nn.ReLU(),
            nn.Linear(32, 1),
            nn.ReLU(),
        )
    def forward(self, x):
        return self.model(x)
判别器模型结构: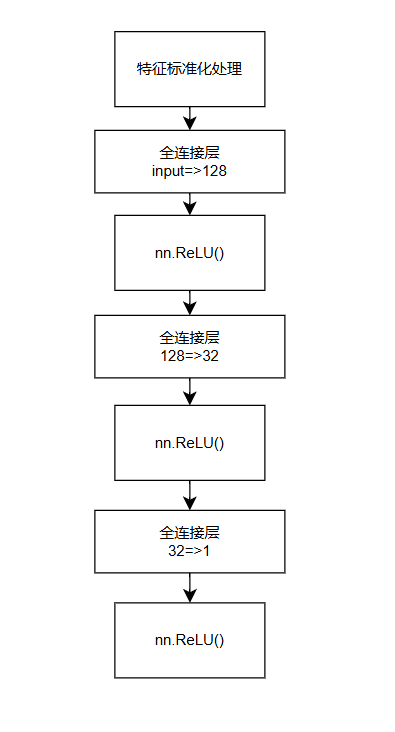
生成器:
class Generator(nn.Module):
    def __init__(self, input_dim, output_dim):
        super(Generator, self).__init__()
        self.model = nn.Sequential(
            nn.Linear(input_dim, 32),
            nn.ReLU(),
            nn.Linear(32, output_dim),
            # nn.ReLU(),
        )

    def forward(self, z):
        return self.model(z)
生成器的结构: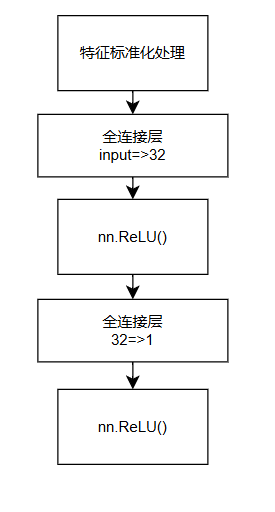
对于该数据进行数据增强可有两种思路。
1.将生成器输入维度设置为5输出为6,创建维度为5的噪声,经由生成器输出维度为6的模拟数据,再经过dnn/mlp等模型预测其相对距离,最终得到维度为7的数据作为模拟数据
2.将生成器输入维度设置为6,创建维度为6的噪声,直接经由生成器输出维度为6的模拟数据
对于数据的选择也有两种思路:
1.选择混合后的五井数据作为原始数据进行数据增强
2.分别使用混合前的各井数据作为原始数据进行数据增强,增强后再进行混合
目前数据增强是按照思路1,数据选择按照也思路1
GAN模型训练:
def train_wgan(dnn, generator, discriminator, dataloader, num_epochs=3000, batch_size=8, n_critic=300):
    generator_losses = []
    discriminator_losses = []
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    generator.to(device)
    discriminator.to(device)

    gen_optimizer = optim.SGD(generator.parameters(), lr=0.0002)
    disc_optimizer = optim.SGD(discriminator.parameters(), lr=0.0003)
    dnn_optimizer = optim.SGD(dnn.parameters(), lr=0.0003)

    scaler = StandardScaler()
    columns = ['Column1', 'Column2', 'Column3', 'Column4', 'Column5', 'Column6', 'Column7']
    output_filepath = 'generated_data/generated_data2.csv'
    f = open(output_filepath,'w',encoding='utf-8')
    csv_writer = csv.writer(f)
    csv_writer.writerow(columns)
    loss_func = nn.MSELoss() # 均方根误差损失函数
    train_num = 0
    train_loss = 0
    for epoch in range(num_epochs):
        for _ in range(len(dataloader) // batch_size):
            real_data = next(iter(dataloader))
            real_data = torch.stack(real_data).to(device)

            X_real, y_real = np.split(real_data.squeeze(), [6], axis=1)
            dnn_optimizer.zero_grad()
            predict = dnn(X_real)
            # print(predict)
            loss = loss_func(predict, y_real)
            loss.backward()
            dnn_optimizer.step()
            for _ in range(n_critic):
                X_real = scaler.fit_transform(X_real.cpu().numpy())
                X_real = torch.FloatTensor(X_real).to(device)
                noise = torch.randn(batch_size, 5).to(device)
                fake_data = generator(noise)
                disc_real = discriminator(X_real)
                disc_fake = discriminator(fake_data.detach())
                disc_optimizer.zero_grad()
                disc_loss = -torch.mean(disc_real) + torch.mean(disc_fake)
                disc_optimizer.step()
                for param in discriminator.parameters():
                    param.data.clamp_(-0.1, 0.1)

            noise = torch.randn(batch_size, 5).to(device)
            fake_data = generator(noise)

            wasserstein_loss = discriminator(fake_data)
            gen_loss = -torch.mean(wasserstein_loss)
            gen_optimizer.zero_grad()
            gen_loss.requires_grad_(True)
            gen_loss.backward()
            gen_optimizer.step()
        generator_losses.append(gen_loss.item())
        discriminator_losses.append(disc_loss.item())
        print(f"Epoch {epoch}/{num_epochs} [D loss: {disc_loss.item()}] [G loss: {gen_loss.item()}]")
流程图: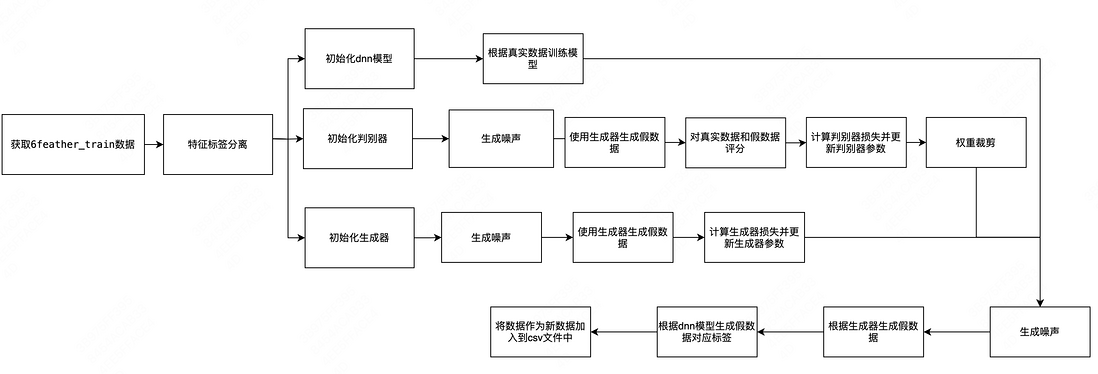
目前采取的评判生成器和判别器是否收敛的方法——绘制损失函数图像,查看是否稳定收敛
数据增强后的效果(扩充数据为800条原为160条)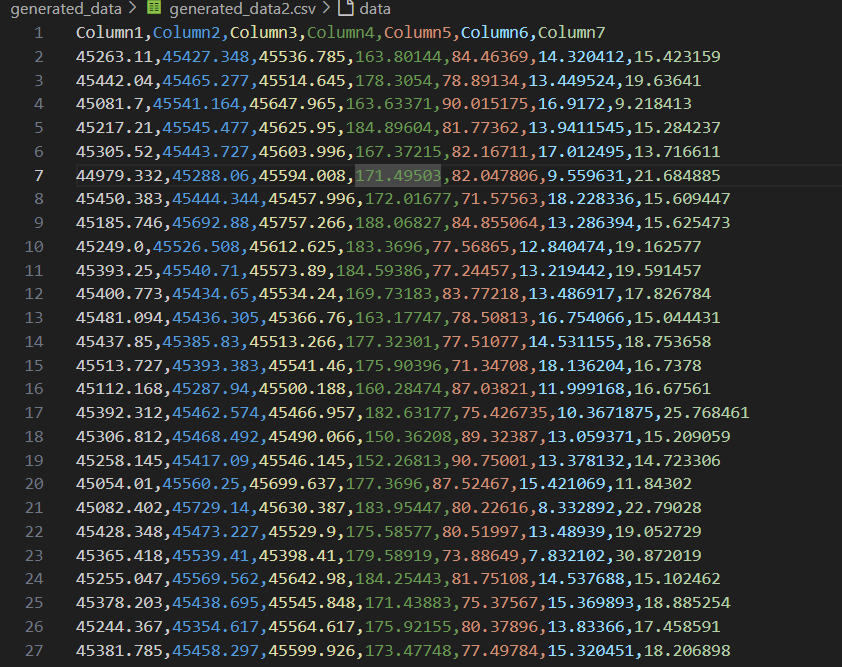
但是将目前数据用于实际模型预测中得到的效果较差: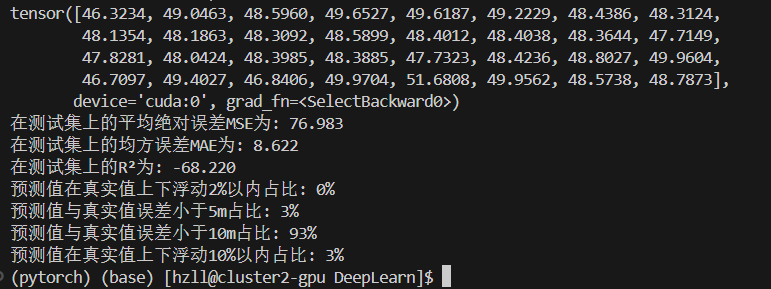
后续尝试采用其他思路组合,并尝试优化生成器、判别器以及用于生成标签的模型选择。
根据定性生成数据与原真实数据对比来看,并不是适用于所有井,比如A1井和L3井对应的相对距离都在58米左右,但是猜测由于其在混合数据中数据占比少,导致数据增强所得数据中基本没有58米左右相对距离的数据,或者也可能是生成标签所选模型过于简略所致,这些计划于本周进行测试。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论