Livy探究(五) -- 解释器的实现
文章目录
本篇我们深入源码,探究一下livy解释器的实现原理。
ReplDriver
ReplDriver是真正最终运行的Driver程序对应的类(其基类是第三篇中提到的RSCDrvier)。在这一层,重点关注handle系列方法:
def handle(ctx: ChannelHandlerContext, msg: BaseProtocol.ReplJobRequest): Int = {
    ...
}

def handle(ctx: ChannelHandlerContext, msg: BaseProtocol.CancelReplJobRequest): Unit = {
    ...
}

def handle(ctx: ChannelHandlerContext, msg: BaseProtocol.ReplCompleteRequest): Array[String] = {
    ...
}

def handle(ctx: ChannelHandlerContext, msg: BaseProtocol.GetReplJobResults): ReplJobResults = {
    ...
}这些方法其实负责处理各种类型的request,例如BaseProtocol.ReplJobRequest就是处理执行代码请求。前面有篇提到的RpcServer,负责基于netty启动服务端,并且绑定处理请求的类,其内部的dispatcher会负责通过反射,找到对应的handle方法并调用。
关于RPC,这里只是提一下,后面的篇章再跟大家一起分析细节
本篇的重点是探究REPL,所以我们重点从BaseProtocol.ReplJobRequest处理方法跟入:
def handle(ctx: ChannelHandlerContext, msg: BaseProtocol.ReplJobRequest): Int = {
  session.execute(EOLUtils.convertToSystemEOL(msg.code), msg.codeType)
}
这里调用了session对象的execute,所以继续进去看session对象
Session
ReplDriver持有Session对象的实例,在ReplDriver初始化阶段实例化,并调用了session.start()方法:
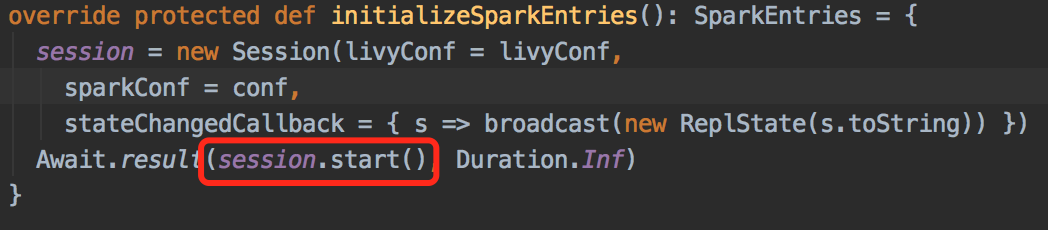
session会创建SparkInterpreter,并调用SparkInterpreter.start。

session的execute方法最终会调用SparkInterpreter.execute。
SparkInterpreter
在Livy中SparkInterpreter是一种Interpreter(接口)。同样是Interpreter的还有:
- PythonInterpreter
- SparkRInterpreter
- SQLInterpreter
- ...

SparkInterpreter.start主要干的事情就是初始化SparkILoop。SparkILoop是org.apache.spark.repl包下的类,它其实就是spark本身实现REPL的核心类。livy在这里其实只是包装了spark本身已经实现的功能。另外一件事情,就是第三篇中提到的在解释器中bind变量,下面的代码就是bind变量的过程:

上面代码中的bind方法和execute方法就是核心方法,其实现方法就是直接调用SparkILoop的对应方法:
// execute其实最后调到interpret
// code就是要执行的代码
override protected def interpret(code: String): Result = {
  sparkILoop.interpret(code)
}

// name: 变量名
// tpe: 变量类型
// value: 变量对象真实引用
// modifier: 变量各种修饰符
override protected def bind(name: String,
 tpe: String,
 value: Object,
 modifier: List[String]): Unit = {
  sparkILoop.beQuietDuring {
    sparkILoop.bind(name, tpe, value, modifier)
  }
}
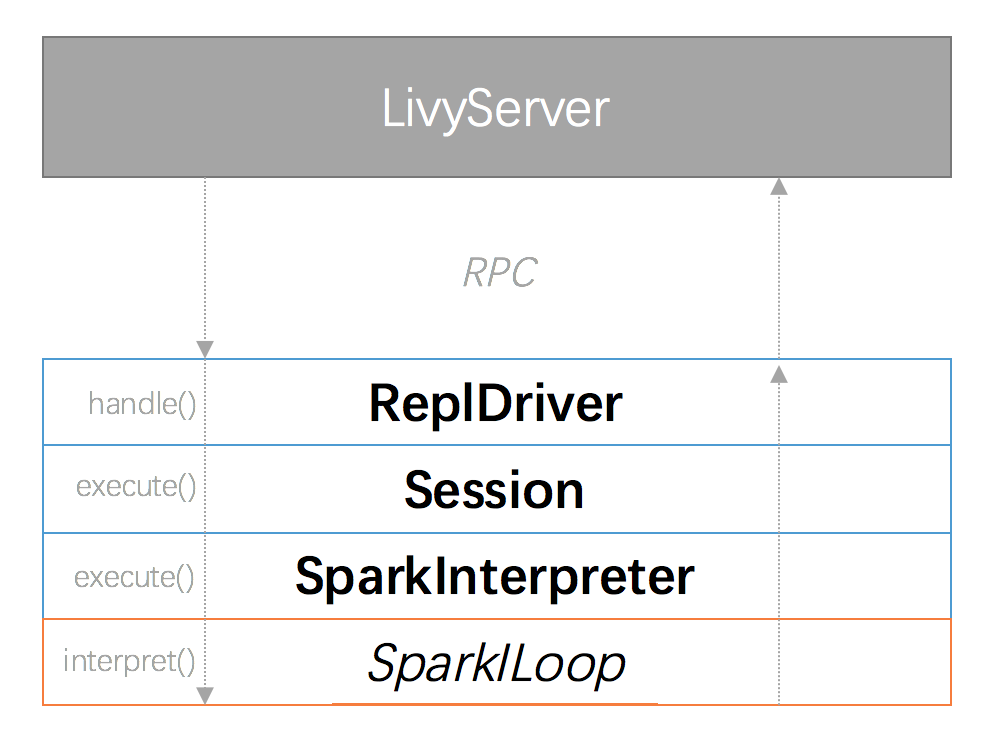
到这里其实思路已经比较清晰了,我们得到下面的层次关系图:
总结
本篇从源码的角度分析了livy如何利用spark实现的REPL,实现交互式代码运行。因此,有了livy,相当于把spark的REPL搬到了web。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论