从放弃到入门之大数据如何学好
文章目录
如果你已经按照上面的流程认真完整的走了一遍,那么你应该已经具备以下技能和技术点
知道如何把已有的数据采集到HDFS上,包括离线采集和实时采集
你已经知道sqoop(或者还有DataX)是HDFS和其他数据源之间的数据交换工具
你已经知道flume可以用作实时的日志采集
在这里小编建了一个大数据学习交流扣扣群:529867072,我自己整理的最新的大数据进阶资料和高级开发教程,如果有想需要的,可以加群一起学习交流
从前面的学习,对于大数据平台,你已经掌握的不少的知识和技能,搭建Hadoop集群,
把数据采集到Hadoop上,使用Hive和MapReduce来分析数据,把分析结果同步到其他数据源。
接下来的问题来了,Hive使用的越来越多,你会发现很多不爽的地方,特别是速度慢,
大多情况下,明明我的数据量很小,它都要申请资源,启动MapReduce来执行
任务5:我忠爱的强大的SQL
其实大家都已经发现Hive后台使用MapReduce作为执行引擎,实在是有点慢
因此SQL On Hadoop的框架越来越多,按我的了解,最常用的按照流行度依次为SparkSQL、Impala和Presto
这三种框架基于半内存或者全内存,提供了SQL接口来快速查询分析Hadoop上的数据
我们目前使用的是SparkSQL,至于为什么用SparkSQL,原因大概有以下吧
使用Spark还做了其他事情,不想引入过多的框架
Impala对内存的需求太大,没有过多资源部署
5.1 关于Spark和SparkSQL
什么是Spark,什么是SparkSQL。
Spark有的核心概念及名词解释。
SparkSQL和Spark是什么关系,SparkSQL和Hive是什么关系。
SparkSQL为什么比Hive跑的快。
5.2 如何部署和运行SparkSQL
Spark有哪些部署模式?
如何在Yarn上运行SparkSQL?
使用SparkSQL查询Hive中的表。
PS: Spark不是一门短时间内就能掌握的技术,因此建议在了解了Spark之后,可以先从SparkSQL入手,循序渐进。
关于Spark和SparkSQL,可参考 http://lxw1234.com/archives/c...
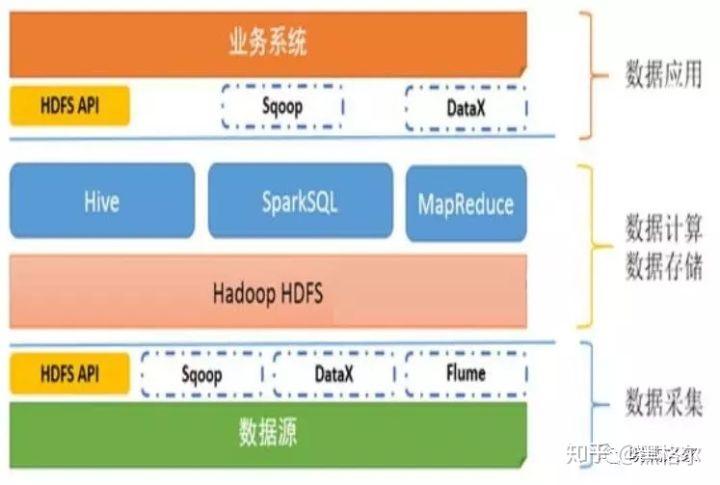
如果你认真完成了上面的学习和实践,此时,你的”大数据平台”应该是这样的:
待续......
感谢大家的支持!雅俗共赏!
分享,让更多的朋友获取知识和技术的收益!
谢谢您的支持!
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论