CV-2020-实践:03 并行图像处理的UI界面

文章目录
CV-2020-实践:03 并行图像处理的UI界面
由于本次需要开发一个图像处理的UI界面,而由于Xcode上使用的是OC或Swift语言开发界面,之前的配置如果要用C++开发则可能需要混编或者使用前后端分离(个人能力不足),所以这里考虑使用QT进行开发。
Microsoft isn't evil, they just make really crappy operating systems. --Linus Torvalds (Linux之父)
1. Qt的安装和配置
Qt的下载和安装
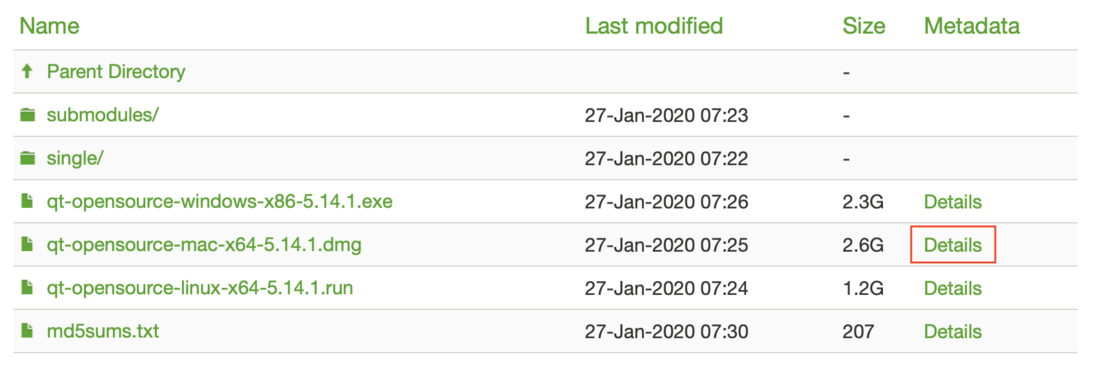
- Qt是一款跨平台的C++图形界面应用程序开发框架,我们可以用它来进行UI界面的开发。进入下载官网,下载对应版本的.dmg,然后进行安装即可。
- 当然进行下载的时候,可能由于某原因速度过慢,这时可以点击下载项最末的detail寻找国内镜像然后进行下载(即便是国内镜像,不同的源下载速度差异也好大)。
OpenCV、OpenMP和OpenCL环境配置
- 打开安装好的Qt Creator,新建一个Qt Widgets Application项目。
- 在.pro配置文件中修改如下(其中对应文件的位置参考实践1和实践2中的设置)
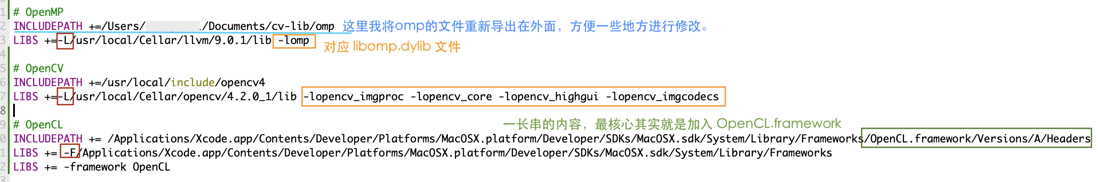
- 配置好之后,构建时也会出现一些报错,原因主要是在这些库中存在一些同名的文件,我粗暴地把omp整个导出,然后将重复报错的名字改成"**-omp"格式了,如下(emmintrin.h和stdint.h文件,可能还有别的):

-
简单地将实践1中的三份代码进行尝试,然后终于成功了,perfect~
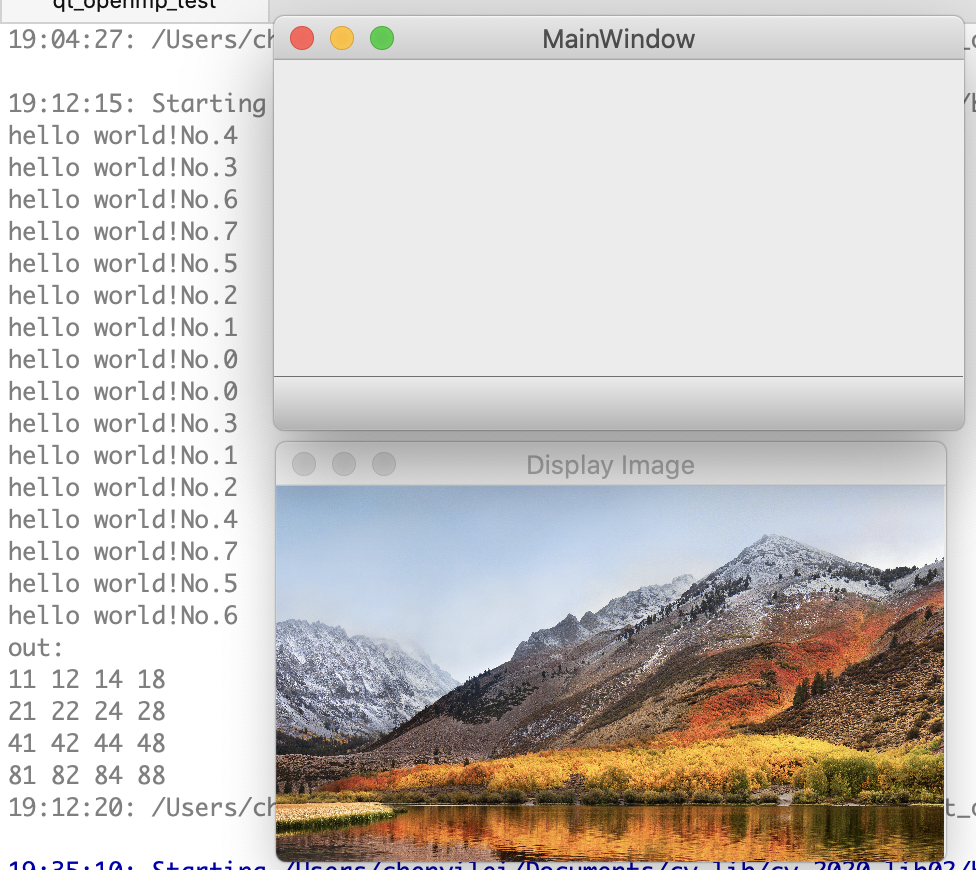
- OpenCV读取图片、OpenMP开启八个进程、OpenCL内核和Qt的空白窗口终于全齐了。
2. 功能列表和成果展示
- 由于本次实验涉及的内容较多,无法做到一一细说,在这一部分将所实现的功能通过列表和界面展示的形式显示出来。
功能列表
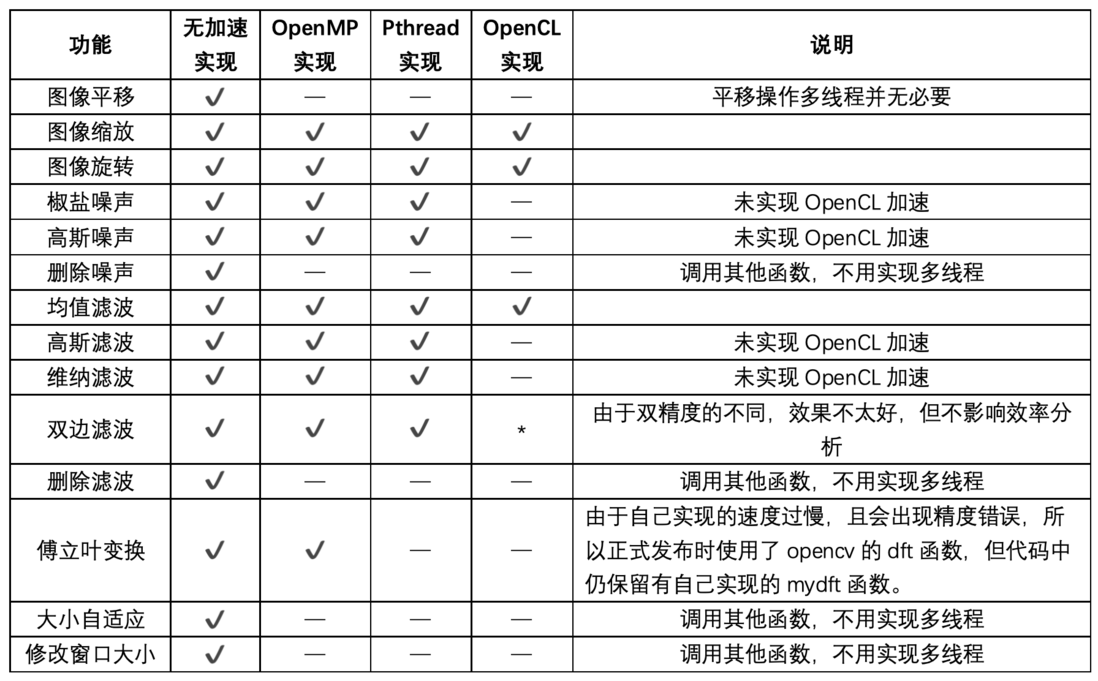
- 以下为实现的功能列表,参数的修改等简单修改不记录在下。✔️表示实现的功能,*表示实现了但存在少量问题的功能,—表示未实现或不需要实现的功能。
界面展示
-
使用Qt设计实现的UI界面如下,包括上方功能区、中部图片展示区和底部输出区

- 上方功能区:包括窗口大小的修改、插值模式的选择(最近邻插值、双线性插值和双三次插值)、加速模式的选择(无加速、OpenMP加速、pthread线程加速和OpenCL GPU加速)、对线程加速的线程数选择、图片大小自适应、傅立叶变换、噪声添加(无噪声、椒盐噪声、高斯噪声)、滤波添加(无滤波、均值滤波、高斯滤波、维纳滤波、双边滤波);
- 中部图片展示区:包括拖入图片、鼠标移动图片、设置图片角度大小和图片展示;
- 底部输出区:输出进行的操作和所用的时间,包含清空记录的按钮。
3. 功能实现提示
- 此部分简单将这些功能中较复杂的功能做一个提示,一般了解了其原理(公式)后都可以较快实现(当然傅立叶变换例外)。
- 仿射变换(平移、缩放、旋转):图像矩阵的变换在图形学、图像处理基础中都有提及,实现并不困难。值得注意的是三种插值方式的选择。
-
傅立叶变换:这应该是整个实验中最为困难的部分了,首先要将图像进行二维傅立叶变换,然后再通过分区对换形成所要的图像(四个角分区对换)。
- 二维傅立叶变换公式:$F(u,v)=\frac{1}{MN}\sum^{M-1}_{x=0}\sum^{N-1}{y=0}f(X,y)e^{-j2\pi(\frac{ux}{M}+\frac{cv}{N})}$
-
代码实现如下:
void CVTool::mydft(Mat &img, Mat &dst){ int w = img.rows; int h = img.cols; for(int u=0; u<w; u++){ for(int v=0; v<h; v++){ double real=0.0; double imagin=0.0; for(int i=0; i<w; i++){ for(int j=0; j<h; j++){ double I = img.at<double>(i,j); double x = 2*CV_PI*((double)u*i/(double)w+(double)v*j/(double)h); real+=cos(x)*I; imagin-=sin(x)*I; } } dst.at<double>(u,v) = sqrt(real*real+imagin*imagin); } } } - 但个人实现后,所花费的时间较长。
- 噪声:椒盐噪声、高斯噪声的实现较为简单,不必赘述了。
- 滤波:均值滤波、高斯滤波、维纳滤波、双边滤波这些滤波方式,直接计算、通过均值和方差滤波、考虑不同权重,理解后也并不复杂。
4. 加速方式(OpenMP、pthread、OpenCL)
- 在功能实现后,CPU线程和GPU加速的实现由于之前没有尝试过,所以还是有一定难度的。但实现一个功能的加速后,基本就能明白了,这里以均值滤波为例。
OpenMP加速
- 老师的参考实现是用列表存储图像,然后根据线程数切割图像后再分别计算,我由于一开始没有考虑分割,这里就直接使用
#pragma omp parallel来实现了。
/*
    i_mat_f: 存储滤波后的图像矩阵
    i_mat_n: 要进行滤波的图像矩阵
*/

QPixmap CVTool::addMeanFilter_omp(){
#pragma omp parallel for num_threads(threads)
    for(int i=1; i<i_mat_f.rows-1; i++){
        for(int j=1; j<i_mat_f.cols-1; j++){
            i_mat_f.at<Vec3b>(i,j)[0] = (i_mat_n.at<Vec3b>(i-1,j-1)[0]+i_mat_n.at<Vec3b>(i-1,j)[0]+i_mat_n.at<Vec3b>(i-1,j+1)[0]+
                                      i_mat_n.at<Vec3b>(i,j-1)[0]+i_mat_n.at<Vec3b>(i,j)[0]+i_mat_n.at<Vec3b>(i,j+1)[0]+
                                      i_mat_n.at<Vec3b>(i+1,j-1)[0]+i_mat_n.at<Vec3b>(i+1,j)[0]+i_mat_n.at<Vec3b>(i+1,j+1)[0])/9;
            i_mat_f.at<Vec3b>(i,j)[1] = (i_mat_n.at<Vec3b>(i-1,j-1)[1]+i_mat_n.at<Vec3b>(i-1,j)[1]+i_mat_n.at<Vec3b>(i-1,j+1)[1]+
                                      i_mat_n.at<Vec3b>(i,j-1)[1]+i_mat_n.at<Vec3b>(i,j)[1]+i_mat_n.at<Vec3b>(i,j+1)[1]+
                                      i_mat_n.at<Vec3b>(i+1,j-1)[1]+i_mat_n.at<Vec3b>(i+1,j)[1]+i_mat_n.at<Vec3b>(i+1,j+1)[1])/9;
            i_mat_f.at<Vec3b>(i,j)[2] = (i_mat_n.at<Vec3b>(i-1,j-1)[2]+i_mat_n.at<Vec3b>(i-1,j)[2]+i_mat_n.at<Vec3b>(i-1,j+1)[2]+
                                      i_mat_n.at<Vec3b>(i,j-1)[2]+i_mat_n.at<Vec3b>(i,j)[2]+i_mat_n.at<Vec3b>(i,j+1)[2]+
                                      i_mat_n.at<Vec3b>(i+1,j-1)[2]+i_mat_n.at<Vec3b>(i+1,j)[2]+i_mat_n.at<Vec3b>(i+1,j+1)[2])/9;
        }
    }

    return imgRotate(angle, false);
}
pthread实现
- 同样是CPU的线程加速方法,不做更多介绍了。
//每个线程传输的参数
struct meanfilter_data{
    int end;
    int start;
};

//总的进程生成、控制,各个进程的分配
QPixmap CVTool::addMeanFilter_sys(){
    pthread_t pthreads[threads];
    struct meanfilter_data td[threads];
    int h = i_mat_f.rows/threads;
    p_mat_n = i_mat_n.clone();
    p_mat_f = i_mat_f.clone();

    for(int i=0; i<threads; i++){
        td[i].end = h*(i+1)-1;
        td[i].start = h*i;

        pthread_create(&pthreads[i], NULL, meanfilter_sys, (void *)&td[i]);
        pthread_join(pthreads[i],NULL);
    }

    i_mat_f = p_mat_f.clone();

    return imgRotate(angle, false);
}

//单个线程的处理
void* CVTool::meanfilter_sys(void *threadarg){
    struct meanfilter_data *my_data;
    my_data = (struct meanfilter_data *) threadarg;

    for(int i=my_data->start; i<my_data->end; i++){
        for(int j=1; j<p_mat_f.cols-1; j++){
            p_mat_f.at<Vec3b>(i,j)[0] = (p_mat_n.at<Vec3b>(i-1,j-1)[0]+p_mat_n.at<Vec3b>(i-1,j)[0]+p_mat_n.at<Vec3b>(i-1,j+1)[0]+
                                      p_mat_n.at<Vec3b>(i,j-1)[0]+p_mat_n.at<Vec3b>(i,j)[0]+p_mat_n.at<Vec3b>(i,j+1)[0]+
                                      p_mat_n.at<Vec3b>(i+1,j-1)[0]+p_mat_n.at<Vec3b>(i+1,j)[0]+p_mat_n.at<Vec3b>(i+1,j+1)[0])/9;
            p_mat_f.at<Vec3b>(i,j)[1] = (p_mat_n.at<Vec3b>(i-1,j-1)[1]+p_mat_n.at<Vec3b>(i-1,j)[1]+p_mat_n.at<Vec3b>(i-1,j+1)[1]+
                                      p_mat_n.at<Vec3b>(i,j-1)[1]+p_mat_n.at<Vec3b>(i,j)[1]+p_mat_n.at<Vec3b>(i,j+1)[1]+
                                      p_mat_n.at<Vec3b>(i+1,j-1)[1]+p_mat_n.at<Vec3b>(i+1,j)[1]+p_mat_n.at<Vec3b>(i+1,j+1)[1])/9;
            p_mat_f.at<Vec3b>(i,j)[2] = (p_mat_n.at<Vec3b>(i-1,j-1)[2]+p_mat_n.at<Vec3b>(i-1,j)[2]+p_mat_n.at<Vec3b>(i-1,j+1)[2]+
                                      p_mat_n.at<Vec3b>(i,j-1)[2]+p_mat_n.at<Vec3b>(i,j)[2]+p_mat_n.at<Vec3b>(i,j+1)[2]+
                                      p_mat_n.at<Vec3b>(i+1,j-1)[2]+p_mat_n.at<Vec3b>(i+1,j)[2]+p_mat_n.at<Vec3b>(i+1,j+1)[2])/9;
        }
    }

    pthread_exit(NULL);
}
OpenCL的实现
- 其中有一些OpenCL操作的分装,这些大家可以自行百度,一般流程都是相同的。
-
程序:
QPixmap CVTool::addMeanFilter_ocl(int size){ i_mat_f = Mat::zeros(i_mat_n.rows, i_mat_n.cols, i_mat_n.type()); int dstHeight=i_mat_f.rows; int dstWidth=i_mat_f.cols; std::vector<Mat> srctemp; split(i_mat_n, srctemp); std::vector<Mat> dsttemp; //分离通道进行滤波 for(int ch=0; ch<3; ch++){ Mat srcMat = srctemp.at(ch); Mat dstMat = Mat::zeros(dstWidth,dstHeight, CV_8UC1); meanfilter_ocl(srcMat, dstMat, size); dsttemp.push_back(dstMat); } merge(dsttemp, i_mat_f); return imgRotate(angle, false); } //对单个通道进行滤波 bool CVTool::meanfilter_ocl(Mat &srcMat, Mat &dstMat, int size){ int srcHeight = srcMat.rows; int srcWidth = srcMat.cols; int dstHeight = dstMat.rows; int dstWidth = dstMat.cols; //获取平台id if(!OpenclUtils::getPlantform()) return false; //获取设备id if(!OpenclUtils::getDevice()) return false; //创建设备上下文 if(!OpenclUtils::createContext()) return false; //创建命令队列 if(!OpenclUtils::createCommandQueue()) return false; //创建并编译程序 OpenclUtils::createProgram((char*)"XXX/meanfilter.cl");//程序代码的位置 //创建内核 OpenclUtils::createKernel((char*)"meanfilterCL"); //创建缓存并传入数据 cl_mem memInImage = OpenclUtils::createBuffer(sizeof(uchar)*srcWidth*srcHeight, srcMat.data); cl_mem memOutImage = OpenclUtils::createBuffer(sizeof(uchar)*dstWidth*dstHeight, NULL, false); //传入内核函数参数 OpenclUtils::setKernelArg(0, sizeof(cl_mem), &memInImage); OpenclUtils::setKernelArg(1, sizeof(cl_mem), &memOutImage); OpenclUtils::setKernelArg(2, sizeof(int), (void*)&srcWidth); OpenclUtils::setKernelArg(3, sizeof(int), (void*)&srcHeight); OpenclUtils::setKernelArg(4, sizeof(int), (void*)&dstWidth); OpenclUtils::setKernelArg(5, sizeof(int), (void*)&dstHeight); OpenclUtils::setKernelArg(6, sizeof(int), (void*)&size); //工作组(线程块)和工作项排布(线程) size_t localThreads[2] = {32, 4}; //工作组中工作项排布 size_t globalThreads[2] = {OpenclUtils::roundUp(localThreads[0],dstWidth), OpenclUtils::roundUp(localThreads[1],dstHeight)}; //启动内核 OpenclUtils::runKernel(2,localThreads,globalThreads); //将结果拷贝回主机端 OpenclUtils::getResult(memOutImage, sizeof(uchar)*dstWidth*dstHeight, dstMat.data); //释放资源 clReleaseMemObject(memInImage); clReleaseMemObject(memOutImage); OpenclUtils::releaseResource(); return true; } -
meanfilter.cl文件:可以类比OpenGL代码考虑,对每个像素点的处理#pragma OPENCL EXTENSION cl_amd_printf : enable __kernel void kernel_bilateralfiter(__global unsigned char * inImage, __global unsigned char * outImage, int srcWidth, int srcHeight, int dstWidth, int dstHeight, int size) { int dstX = get_global_id(0); int dstY = get_global_id(1); double weight = 0.0; double pixcel = 0.0; for(int x=0; x<size; x++){ for(int y=0; y<size; y++){ pixcel += inImage[(y+dstY)*srcWidth+x+dstX]; weight += 1; } pixcel/=weight; } if(dstX < dstWidth && dstY < dstHeight){ int index = dstY*dstWidth+dstX; outImage[index] = pixcel; } }
5. 总结和提醒
- 在这次的实验的过程中,花费了很多时间和精力,也走了很多弯路,一些提示如下:
- 由于这是个完整的“产品”,在进入开发前最好先确定业务逻辑(个人在基本功能一个个实现后,才发现整体逻辑存在问题)。确定是否需要存储中间状态,即每次的操作是在上次的图像上进行,还是在原图像上把所有操作都进行一遍;
- 如果有老师的参考程序,建议先理解了再进行,不要像我一样因为平台不同索性完全不看,最后浪费很多时间;
- 最好先将一个功能的OpenMP、pthread、OpenCL版本实现,弄懂各个实现方法,再进入下一步(我先把全部功能的基础版本实现,但重用性太差了);
- 先弄懂原理,再编码,而不是直接先找实现的代码再理解(后期反而会花费更多时间);
- 最后,配置的问题和界面布局已经给出了参考,应该能对大家有一点点的帮助。
祝大家也顺利成功~
参考资料:
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论