MySQL
文章目录
MySQL环境检测及安装
1、检测本机上的mysql环境是否OK
打开cmd,输入:mysql -uroot -proot

1)如果回车后显示:Welcome to the MariaDB/mysql...表示本机上已经安装了mysql
    并且也配置了环境变量。(不用再安装以及任何配置)
2)如果回车后显示:mysql不是内部或外部命令,也不是可执行程序...,原因可能是:
    a)可能是电脑上安装了mysql,只是没有配制环境变量    (仅需配置环境变量!)
    b)也可以是电脑上既没有安装mysql,也没有配置环境变量 (需先安装,再配置环境变量)
3)如何判断,本机是否安装了mysql?
    由于mysql默认安装位置是:
        C:/Program Files/MariaDB 10.3
        C:/Program Files/mysql
        C:/Program Files/mysql5.5
        C:/Program Files/mysql5.7
        ...
    如果有,点进去查看目录结构是否完整
4)如果已经安装,只需要配置环境变量即可
5)如果没有安装,先安装mysql,再配置环境变量
2、安装mysql软件
mariadb10.37版本
3、配置mysql环境变量
将mysql的安装目录下的bin目录配置到path环境变量中
一、数据库概述
1、什么是数据库
数据库: 存储和管理数据的仓库
早期:层次式数据库、网络型数据库
现在市场上流行的是关系型数据库和非关系型数据库
2、什么是关系型数据库
底层以二维表的形式来保存数据的库叫做关系型数据库

常见的关系型数据库有哪些(了解):
Sql Server:微软,收费,适用于一些中型、大型的项目,在Java中的市场占比并不高。
Oracle:甲骨文公司,收费,适用于一些大型、超大型的项目(功能强大、性能优异),50%
MySQL:瑞典MySQLAB公司,免费开源,小巧灵活,学习成本低,20%
    MySQL被甲骨文公司收购
    开发成员:mariadb,永远开源免费,和mysql用法完全相同
DB2:IBM,在银行、金融行业使用的较多,在Java中的市场占比不高。
Sqlite:体积小,迷你数据库,用于智能家居,手机,pad等
...
3、数据库相关概念
数据库服务器: 比如我们安装的mysql软件,安装在电脑上之后,可以对外提供存取数据的服务/能力
    在一个数据库服务器中可以创建多个数据库.

数据库:每一个数据库都是存取数据的仓库. 通常一个网站中的所有数据会存放在一个数据库中
    比如:
    www.jd.com        db_jd
    www.baidu.com    db_baidu
    ...
表:每一个数据库中可以创建多张表,每张表用于存放一类数据,例如:
    用户信息    tb_user
    商品信息    tb_product
    订单信息    tb_order
    。。。
表记录:每张表中又可以插入若干表记录,每一条表记录用于保存一个具体的事物
4、SQL语言
SQL: 是用于操作关系型数据库的通用的语言(学会了SQL语句,所有的关系型数据库都可以操作)
使用SQL可以实现(数据库/表/表记录的)如下操作:
    创建库、查看库、删除库、修改库
    创建表、查看表、删除表、修改表
    添加表记录、删除表记录、修改表记录、查询表记录
    创建存储过程、视图、索引等
SQL语言是通用的,但每一个数据库厂商为了增强自己数据库的能力,都提供了方言。
5、如何连接mysql服务器(cmd)
打开cmd窗口,输入: mysql -uroot -proot
打开cmd窗口,输入: mysql -uroot -p
    换行之后再输入密码
打开cmd窗口,输入: mysql -uroot -p -h主机名/ip地址 -P端口
    换行之后再输入密码

退出连接mysql服务器: quit、exit、\q

注释符号: #注释内容
        -- 注释内容
        /* 注释内容 */
取消当前SQL语句的执行:\c
二、操作数据库、操作表(SQL)
书写规范: SQL语句中的关键字在书写时应该大写;自定义的库名、表(别)名、列(别)名 应该小写。
SELECT * FROM stu WHERE id>2; -- 规范写法
select * from stu where id>2; -- 不规范写法,但也可以执行!
几乎所有的SQL语句在书写完成后,都需要在后面添加分号,表示语句到此结束!
--------------------------------------------
创建数据库: create database 库名 charset utf8;
        create database if not exists 库名 charset utf8;

若有已经写好的sql文件,可以在dos窗口执行:
source 盘符:sql文件所在的具体路径(注意路径中要用“/”分隔)

查看所有数据库: show databases;
删除数据库: drop database 库名;
          drop database if exists 库名;
进入/选择数据库: use 库名;
--------------------------------------------
创建stu表:
    use mydb1;
    create table stu(
        id int,
        name varchar(50),
        gender varchar(10),
        birthday date,
        score double
    );
删除表: drop table if exists 表名;
查看表: show tables;
查看表结构: desc 表名;
--------------------------------------------
三、新增、修改、删除表记录
1、新增记录:
    insert into stu(id,name,gender,birthday,score) value(1,'张三','男','1985-9-1',86);
    -- 插入时,给所有列赋值,列名可以省略
    insert into stu value(1,'张三','男','1985-9-1',86);

    插入记录时需要注意:
        1) 插入值的个数和顺序必须要和列的个数和顺序保持一致!
        2) SQL语句中的字符串和日期类型的值用单引号引起来(即使有些数据库版本支持双引号,也建议使用单引号)
        3) 如果是要给所有的列都赋值,而且值的顺序和个数,和声明时列的顺序和个数完全一致,列名可以省略!
    常见问题1: 在往stu表中插入中文数据出现乱码解决方法
        1)首先检查当前表(stu)所在的库(mydb1)创建时有没有指定编码
            create database mydb1 charset utf8;
            如果没有指定,将库删除再重建,创建时按照上面的语法指定编码
        2)如果建库时指定了编码,那么在插入数据之前,有没有设置 set names gbk;
            如果没有设置,先设置编码,再插入数据。
        3)如果前面确认了没有问题,可以尝试设置 set names utf8;再插入数据。
        4)如果上面都确认了没有问题,最后可以尝试,在cmd窗口顶部,右键"属性",在弹出的窗口中点击"选项",在底部,勾选"使用旧版控制台",确定

    常见问题2: 关于查询stu表中的数据没有对齐的解决方法
        1)关闭之前的cmd窗口,新开一个cmd窗口,连接上mysql服务器
        2)设置set names GBK;编码之后再查询,如果还是没有对齐看一步
        3)再新开一个cmd窗口,使用 mysql --default-character-set=gbk -uroot -proot 连接mysql服务器,连接后不用再 set names gbk; 直接查询数据, 看数据是否对齐。

2、修改记录:
    update stu set score=score+10;
    -- 如果要修改id大于1的所有学生的成绩
    update stu set score=score+10,name='张三丰' where id=1;

3、删除记录:
    delete from stu; -- 删除stu表中的所有记录
    delete from stu where id>1; -- 删除id大于1的所有学生信息

    drop database 库名; -- 删除指定的库
    drop table 表名;    -- 删除指定的表
四、查询表记录(单表查询)
1、基础查询
    select * | 列名列表 from 表名
2、where子句查询
    select * | 列名列表 from 表名 where 列 运算符 值 [or|and 条件2]...
可以通过加distinct关键字来去重
3、模糊查询
    select * | 列名列表 from 表名 where 列 like 值
    模糊查询可以通过like关键字按照指定的模式进行匹配
    需要配合 % 和 _(下划线)使用
    %: 匹配0或多个任意字符
    _: 匹配1个任意字符
4、多行函数查询
    count( * | 列名 ): 用于统计查询结果有多少行
    max( 列名 ): 求当前这一列中的最大值
    min( 列名 ): 求当前这一列中的最小值
    sum( 列名 ): 对当前这一列中的所有值求和
    avg( 列名 ): 对当前这一列中的所有值求平均值

5、分组查询
    select * | 列名列表 from 表名 [where子句] group by 列

6、排序查询
    select * | 列名列表 from 表名 [where子句] [group by 列]
    order by 列 ASC|DESC
    ASC: 升序(默认值,可以省略)
    DESC: 降序

7、分页查询
    select * | 列名列表 from 表名 [where子句] [group by 列]
    [order by 列 ASC|DESC]
    limit (页码-1)*每页显示的记录数,每页显示的记录数

8、having子句
    select * | 列名列表 from 表名 [where子句] [group by 列]
    [having子句]
如果在group by之后我们要对分组里面的数据再加限制条件怎么办呢?答案是having

9、其它函数查询
    curdate() -- 获取日期:年月日
    curtime() -- 获取时间:时分秒
    sysdate()/now() -- 获取日期+时间, 年月日 时分秒
    year()/month()/day()/hour()/minute()/second() -- 从日期/时间中分别获取年、月、日、时、分、秒
    concat(s1,s2,...sn) -- 用于拼接字符串,s1~sn都是字符串
    concat_ws(opt,s1,s2,...sn) -- 用于拼接字符串,第一个参数是一个分隔符,在后面的s1~sn在拼接时,都需要在中间拼上这个分隔符
五、mysql的数据类型
1、数值类型
tinyint --> java中的byte
smallint --> java中的short
int --> java中的int
bigint --> java中的long
float --> java中的float
double --> java中的double
2、字符串类型
2.1.char类型: 定长字符串
char类型的存储范围是: 0~255个字符
name char(10): 声明一个name列,是字符串类型,长度不能超过10个字符
如果实际存储的数据长度小于10,剩余的空间会用空格补全,因此会造成空间浪费!
char类型在存储数据的效率略高于varchar类型

因此,char类型适合存储长度固定的数据(比如:学生证号,身份证号,员工编号等)
这样既不会浪费空间,存储数据的效率还较高!
2.2.varchar类型: 不定长字符串
varchar类型的存储范围是: 0~65535个字节
    iso8859-1编码: 1个字符对应1个字节
    GBK编码: 1个字符对应2个字节
    UTF-8编码: 1个字符对应3个字节
name varchar(10): 声明一个name列,是字符串类型,长度不能超过10个字符
如果实际存储的数据长度小于10,剩余的空间还可以留给别的数据使用,不会造成空间浪费!
varchar类型适合存储长度不固定的数据,不会浪费空间!
3、日期类型:
date:年月日
time:时分秒
datetime:年月日 时分秒 2020-10-1 11:10:09
timestamp: 时间戳,格式和datetime相同,但实际存储的是从1970-1-1到指定日期的毫秒值
六、mysql的字段约束:
数据库字段名又叫元数据
1、主键约束:
如果一个列可以唯一的表示一行表记录(或可以作为一行表记录的唯一标识),通常会给这样的列添加主键约束,通常情况下,每张表都会有一个主键。主键特点:唯一且不为空。(但不是每个唯一且不为空的列都是主键!)
**如何添加主键约束**:
    create table stu(
        id int primary key auto_increment,
        ..
    );
**主键自增策略**:
    如果主键是数值类型,可以为主键添加自增策略(目的是为了更方便插入主键的值)
    添加了自增策略后,以后再插入数据时,可以不为主键赋值,数据库会自己维护一个变量(AUTO_INCREMENT),该变量的值从1开始,每次用完后会自动加1,当插入数据时,如果没有给主键赋值,数据库就会从AUTO_INCREMENT变量上获取一个值,作为主键值插入到表中。
如何添加主键自增策略:
    create table user(
        id int primary key auto_increment,
        ...
    );

主键约束补充: 如果表已经建好了,如何为id添加主键约束:
    例如:将mydb1.stu表中的id设置为主键自增:
    alter table stu modify id int primary key auto_increment;
    再插入数据,就可以不用给id赋值了
    insert into stu values(null,'张三','male','1988-1-2',83);
    insert into stu values(null,'李四','male','1989-3-4',85);
2、非空约束:
如果某一列的值要求不能为空(某些系统要求用户性别 或 密码不能为空),可以为这个列添加非空约束,这个列的值就不能为空(但可以重复)
**如何添加非空约束**:
    create table stu(
        gender varchar(10) not null,
    );
3、唯一约束:
如果某一列的值要求不能重复,可以为这个列添加唯一约束,这个值就不能重复(但可以为空)
**如何添加唯一约束**:
    create table stu(
        username varchar(50) unique not null,
        email varchar(20) unique,
    );
4、外键约束(foreign key)
问题1: 如何保存两张表数据之间的对应关系?
    在其中的一张表中添加列,用于保存另外一张表的主键,以此来保存两张表数据之间的对应关系。
    例如:在emp表中添加一个dept_id列,用于保存dept表中的id列,表示员工所属的部门编号

问题2: 如何避免在删除部门后,员工表中出现冗余数据?
    方式一: 在删除每一个部门之前,先检查部门下还有没有对应的员工,如果有,先将员工删除或者移到别的部门,再删除部门即可
    方式二: 通知数据库员工表和部门表之间存在对应关系,员工表中的dept_id列是要严格参考部门表中的id列。即设置dept_id这个列为外键。通知完后,数据库会一直帮我们盯着,如果再删除部门,部门下有员工,数据库就会阻止我们删除!

问题3: 什么是外键?
    外键就是用于通知数据库两张表(比如部门和员工表)数据之间存在对应关系的这么一个列。

问题4: 如何添加外键?
    create table dept(
        id int primary key auto_increment,
        name varchar(50)
    );
    create table emp(
        id int primary key auto_increment,
        name varchar(50),
        dept_id int,
        foreign key(dept_id) references dept(id)
    );


    1)在没有将dept_id设置为外键的情况下去删除一个部门,查看是否能删除?
        可以删除,数据库不知道两张表存在对应关系,所以不会阻止我们删除!
    2)如果将dept_id设置为外键的情况下去删除一个部门,查看是否能删除?
        如果部门下有员工,删除会失败,此时数据库知道两张表存在对应关系
        并且会帮我们维护这个关系,所以会阻止我们删除有员工的部门!

    3)如果加了级联删除,则在删除某一个部门的同时,先删除该部门下的所有员工,再删除部门本身!

七、表关系
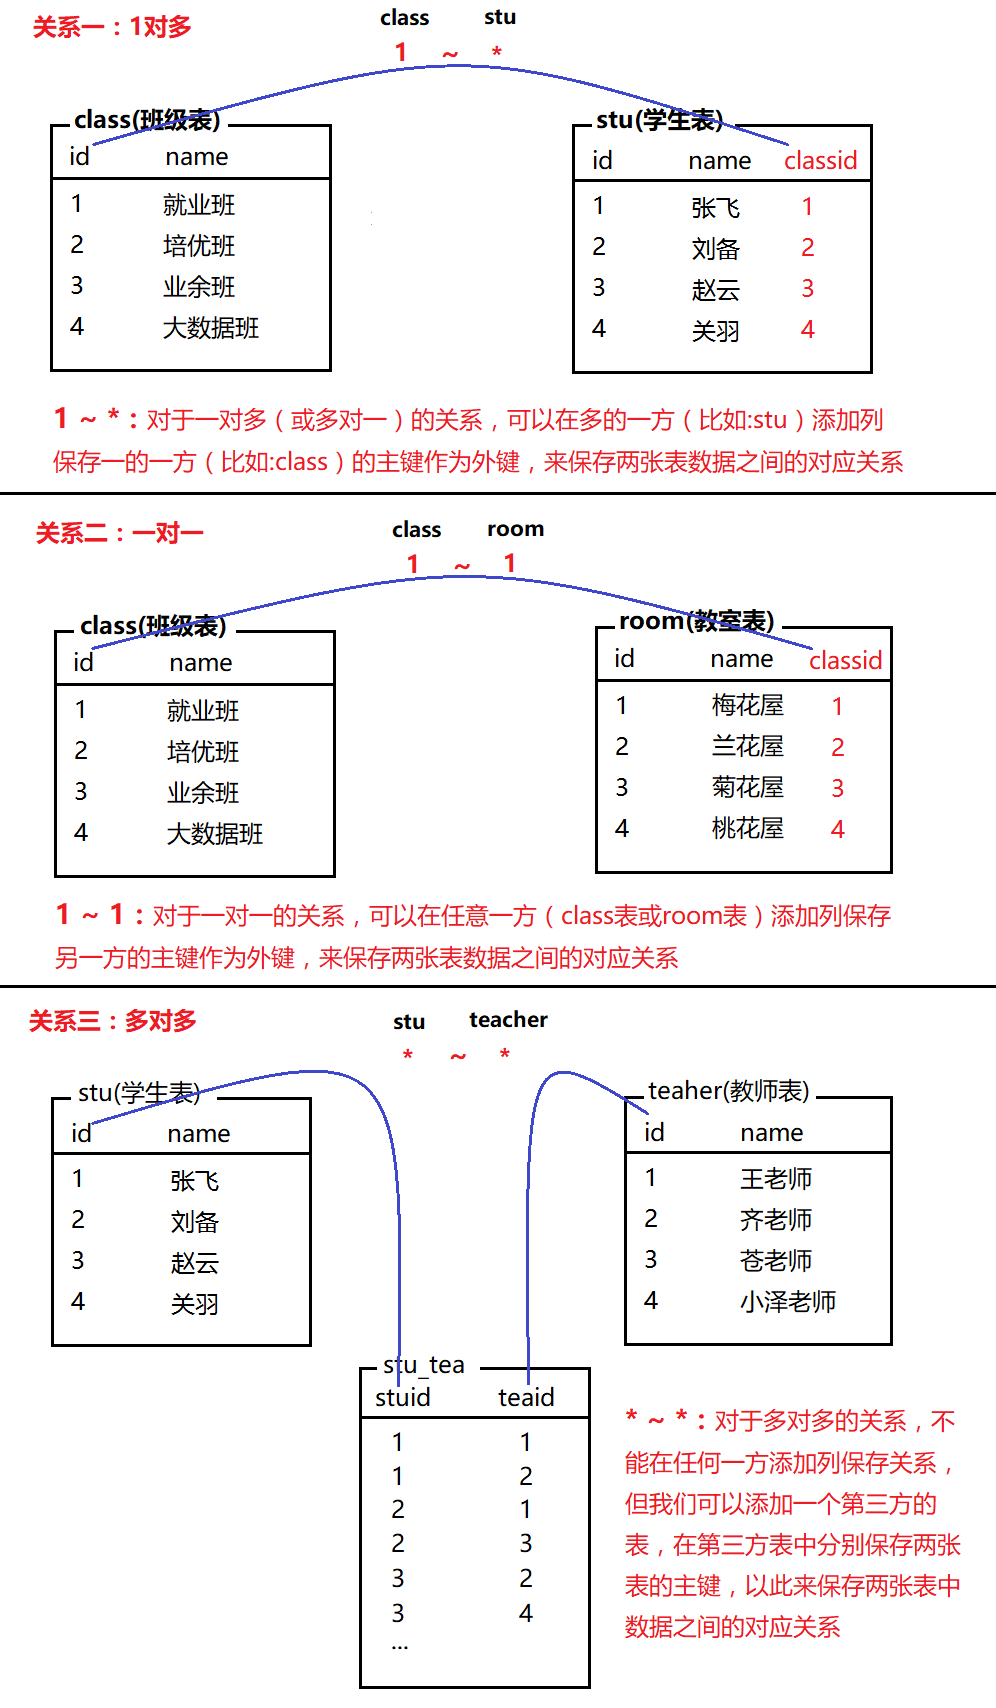
1、一对多(多对一)
例如: 部门 对 员工
    班级 对 学生
在保存一对多或者多对一的表关系时,是在多的一方添加列,来保存一的一方的主键,从而来保存两张表数据之间的对应关系
2、一对一
例如:班级 对 教室
在保存一对一的表关系时,可以在任意一方添加列,来保存另一方的主键,从而来保存两张表数据之间的对应关系
3、多对多
例如:学生 对 教师
在保存多对多的表关系时,在任何一方添加列都不合适,此时可以再创建一张表专门用于保存两张表(学生表和教师表)的对应关系,再创建的这个表中,至少有两个列,分别用于保存两张表(学生表和教师表)的主键,并且将这两个列设置为联合主键。
八、多表查询
1、连接查询
查询部门和部门对应的员工信息
    select * from dept,emp;
笛卡尔积查询: 指同时查询两张表,其中一张表的记录有m条,另一张表的记录有n条,笛卡尔积查询的结果就是 m*n条。
由于笛卡尔积查询的结果中存在大量错误的数据,因此我们不会直接使用这种查询!
可以在笛卡尔积查询的结果上,添加where子句,通过where子句将结果中的错误数据剔除,保留下的就是正确数据!
    -- 连接查询
    select * from dept,emp
    where emp.dept_id=dept.id;
    -- 内连接查询
    select * from dept inner join emp
    on emp.dept_id=dept.id;
2、左外连接查询和右外连接查询
左外连接查询:可以将左边表中的所有记录都查询出来,右边表只显示和左边相对应的数据,如果左边表中某些记录在右边没有对应的数据,右边显示为null即可。例如:
-- 查询部门表中的所有部门,以及部门对应的员工
select * from dept left join emp
on emp.dept_id=dept.id;

右外连接查询:可以将右边表中的所有记录都查询出来,左边表只显示和右边相对应的数据,如果右边表中某些记录在左边没有对应的数据,可以显示为null。
-- 查询所有员工及员工对应的部门
select * from dept right join emp
on emp.dept_id=dept.id;
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论