函数式编程
文章目录
本文所包含的内容有
- 了解函数式编程:函数式编程的概念以及好处、函数是一等公民、高阶函数、闭包
- 函数式编程的基础:lodash、纯函数、柯里化、函数组合、lodash中柯里化的方法
函子:Functor、MayBe、Either、IO、Folktale、Task、Pointer、Monad
了解函数式编程
1、函数式编程的概念
函数式编程(FP)(Functional Programming)是编程范式之一,编程范式还有面向对象编程、面向过程编程等。函数式编程的历史
编程范式类型:
- 面向对象编程: 把现实世界中的事物抽象成程序世界中的类和对象,通过封装、继承和 多态来演示事物事件的联系
- 面向过程编程:依照步骤一步一步来
- 函数式编程:把现实世界的事物和事物之间的联系抽象到程序世界(对运算过程进行抽 象)
- 程序的本质:根据输入通过某种运算获得相应的输出,程序开发过程中会涉及很多有输入和 输出的函数
- x->f(联系、映射)->y,y=f(x)
- 函数式编程中的函数指的不是程序中的函数(方法),而是数学中的函数即映射关系,例如:y = sin(x),sin()是用来描述x和y的关系
- 要求相同的输入始终要得到相同的输出(纯函数)
- 函数式编程是用来描述函数之间的映射
// 非函数式
let num1 = 2
let num2 = 3
let sum = num1 + num2
console.log(sum)
// 函数式
function add (n1, n2) {
return n1 + n2
}
let sum = add(2, 3)
console.log(sum)
2、函数式编程的好处
- 函数式编程是随着 React 的流行受到越来越多的关注
- Vue 3也开始拥抱函数式编程
- 函数式编程可以抛弃 this
- 打包过程中可以更好的利用 tree shaking 过滤无用代码
- 方便测试、方便并行处理
有很多库可以帮助我们进行函数式开发:lodash、underscore、ramda
3、函数是一等公民
- 函数可以存储在变量中
- 函数可以作为参数
- 函数可以作为返回值
在 JavaScript及其他函数式编程语言中函数就是一个普通的对象 (可以通过 new Function() ),我们可以把函数存储到变量/数组中,它还可以作为另一个函数的参数和返回值,甚至我们可以在程序运行的时候通过 new Function('alert(1)') 来构造一个新的函数。
4、高阶函数 (Higher-order function)
- 可以把函数作为参数传递给另一个函数
- 可以把函数作为另一个函数的返回值
总结: 高阶函数就是对其他函数进行操作的函数,操作就是可以作为参数传递出去或者作为返回值,总的来说:高阶函数是一个接收函数作为参数或将函数作为输出返回的函数。
5、闭包(Closure)
    函数和其周围的状态(词法环境)的引用捆绑在一起形成闭包。
    可以在另一个作用域中调用一个函数的内部函数并访问到该函数的作用域中的成员
函数式编程的基础
1、纯函数
- 纯函数就是相同的输入永远会得到相同的输出,而且没有任何副作用(纯函数就类似于数学中的函数(用来描述输入与输出的关系,y=f(x)))
数组中silce和splice分别是:纯函数和不纯的函数
- silce返回数组中的指定部分,不会改变原数组,所以是纯函数
- splice对数组进行操作返回该数组,会改变原数组,
- 函数式编程不会保留计算中间的结果,所以变量是不可变的(无状态的)
// 纯函数
let numbers = [1, 2, 3, 4, 5]
// 纯函数 对数组进行操作,但不会改变原数组,相同的输入永远得到的是相同的输出
numbers.slice(0, 3)
// => [1, 2, 3]
numbers.slice(0, 3)
// => [1, 2, 3]
numbers.slice(0, 3)
// => [1, 2, 3]
// 不纯的函数 对数组进行操作,会对原数组进行改变,导致相同的输入得不到相同的输出
numbers.splice(0, 3)
// => [1, 2, 3]
numbers.splice(0, 3)
// => [4, 5]
numbers.splice(0, 3)
// => []
纯函数的好处:
- 可缓存:因为纯函数对相同的输入始终有相同的结果,所以可以把纯函数的结果缓存起来
- 可测试:纯函数让测试更加方便
并行处理
- 在多线程环境下并行操作共享的内存数据很可能会出现意外情况
- 纯函数不需要访问共享的内存数据,所以在并行环境下可以任意运行纯函数
副作用
// 不纯的
// 副作用让一个函数变的不纯(如下面所示),纯函数的根据相同的输入返回相同的输出,如果函数依赖于外部的状态就无法保证输出相同,就会带来副作用。
let mini = 18
function checkAge (age) {
return age >= mini
}
// 纯的(有硬编码,后续可以通过柯里化解决)
function checkAge (age) {
let mini = 18
return age >= mini
}
副作用来源:
配置文件、数据库、获取用户的输入等
注:所有的外部交互都有可能带来副作用,副作用也使得方法通用性下降不适合扩展和可重用性,同时副作用会给程序中带来安全隐患给程序带来不确定性,但是副作用不可能完全禁止,尽可能控制它们在可控范围内发生。
2、柯里化((Haskell Brooks Curry)
它的含义:
当一个函数有多个参数的时候先传递一部分参数调用它(这部分参数以后永远不变,相当于该函数没有这个参数变成了函数里面固定的变量),然后返回一个新的函数接收剩余的参数,返回结果
 // 普通纯函数
function checkAge (age) {
    let min = 18
    return age >= min
    }
   // 准备柯里化的函数
    function checkAge (min, age) {
    return age >= min
    }
    checkAge(18, 24)
    checkAge(18, 20)
    checkAge(20, 30)
    // 柯里化的函数
    // 首先赋值给该函数,然后他会返回你一个改参数为函数里面变量的新函数,你可以继续赋值
    function checkAge (min) {
    return function (age) {
    return age >= min
    }
    }
    // ES6 写法
    let checkAge = min => (age => age >= min)
    let checkAge18 = checkAge(18)
    let checkAge20 = checkAge(20)
    checkAge18(24)
checkAge18(20)总结*:
- 柯里化可以让我们给一个函数传递较少的参数得到一个已经记住了某些固定参数的新函数
- 这是一种对函数参数的‘缓存’
- 可以让函数变得更灵活,让函数的颗粒度更小
- 可以把一个多元函数转换成一元函数,可以组合使用函数然它产生强大的功能
3、函数组合
因为纯函数和柯里化很容易写出洋葱代码 h(g(f(x))),所以我们可以用函数组合来把细粒度的函数重新组合生成一个新的函数
管道
下面这张图表示程序中使用函数处理数据的过程,给 fn 函数输入参数 a,返回结果 b。可以想想 a 数据通过一个管道得到了 b 数据。
当 fn 函数比较复杂的时候,我们可以把函数 fn 拆分成多个小函数,此时多了中间运算过程产生的 m 和n。
下面这张图中可以想象成把 fn 这个管道拆分成了3个管道 f1, f2, f3,数据 a 通过管道 f3 得到结果 m,m再通过管道 f2 得到结果 n,n 通过管道 f1 得到最终结果 b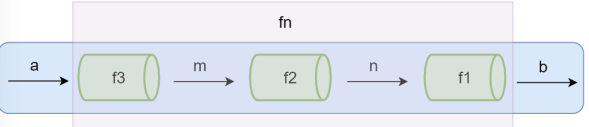
而我们其实只需要的到最终结果b就可以了,所以我们可以把f1,f2,f3合并成一个函数,这就可以理解为函数组合
函数组合
函数组合 (compose):如果一个函数要经过多个函数处理才能得到最终值,这个时候可以把中间过程的函数合并成一个函数
函数就像是数据的管道,函数组合就是把这些管道连接起来,让数据穿过多个管道形成最终结果
// 组合函数
function compose (f, g) {
return function (x) {
return f(g(x))
}
}
function first (arr) {
return arr[0]
}
function reverse (arr) {
return arr.reverse()
}
// 从右到左运行
let last = compose(first, reverse)
console.log(last([1, 2, 3, 4]))
函数的组合要满足结合律 (associativity):我们既可以把 g 和 h 组合,还可以把 f 和 g 组合,结果都是一样的
// 结合律(associativity)
let f = compose(f, g, h)
let associative = compose(compose(f, g), h) == compose(f, compose(g, h))
// true
4、lodash
lodash是一个纯函数的功能库,提供了对数组、数字、对象、字符串、函数等操作的一些方法,lodash有很多模块,其中fp模块里面的函数都是柯里化后的函数
lodash中的柯里化函数(.curry(func))
_.curry(func)
功能:创建一个函数,该函数接收一个或多个 func 的参数,如果 func 所需要的参数都被提供则执行 func 并返回执行的结果。否则继续返回该函数并等待接收剩余的参数。
参数:需要被柯里化的函数
返回值:柯里化后的函数
const _ = require('lodash')
// 要柯里化的函数
function getSum (a, b, c) {
return a + b + c
}
// 柯里化后的函数
let curried = _.curry(getSum)
// 测试
curried(1, 2, 3)
curried(1)(2)(3)
curried(1, 2)(3)
模拟curry函数的实现
//curry需要传入一个函数,然后返回一个新的函数
function curry(func) {
    // 通过es6的...来获取传入的实参
    return function curried(...args) {
        // 判断实参和形参的个数
        if(args.length<func.length){
            return function () {
                // arguments为该函数传入的参数,是一个类数组对象
                // .concat合并数组,array.from转为数组
                // 要把上一次和这一次调用它传入的参数合并传给cuuied调用
                return curried(...args.concat(array.from(arguments)))
            }
        }
        // 如果实参个数不小于形参个数,就直接调用传过来的函数,并把它传过来的参数给他
        return func(...args)
    }
}
lodash中的组合函数
lodash 中组合函数 flow() 或者 flowRight(),他们都可以组合多个函数
flow() 是从左到右运行
flowRight() 是从右到左运行,使用的更多一些
实例:
const _ = require('lodash')
const toUpper = s => s.toUpperCase()
const reverse = arr => arr.reverse()
const first = arr => arr[0]
const f = _.flowRight(toUpper, first, reverse)
console.log(f(['one', 'two', 'three']))
模拟实现lodash中的flowRight()方法
function compose (...fns) {
    // 需要返回一个新的函数
    return function (value) {
    // 因为我们习惯从右往左来执行,所以我们需要使用reverse来把参数接收到的函数数组进行反转
    // reduce对数组中每一个元素执行一个方法,升序进行,这里我们先他提供了第一个元素执行方法的参数value
    // fn就是数组中的每一个参数,acc就是前面一个方法返回的值,acc的初始值就是reduce的第二个参数value
    return fns.reverse().reduce(function (acc, fn) {
    return fn(acc)
    }, value)
    }
    }
    // ES6
    const compose = (...fns) => value => fns.reverse().reduce((acc, fn) =>
    fn(acc), value)
调试组合函数,可以通过插入一个log函数的方式
const _ = require('lodash')
// 组合函数的调试

//需求:NEVER SAY DIE ----> never-say-die
//为了函数组合,对两个参数的lodash进行“降参”,转化成curry,先存用什么切,再输入切什么,再执行_.split()
// const _split = _.split("z-z-z-z","-")
// const _join = _.join(["z","z","z","z"],"&")

const split = _.curry((sep,str)=>_.split(str,sep))
const join = _.curry((sep,str)=>_.join(str,sep))
const map = _.curry((fn,arr)=>_.map(arr,fn))

//插入调试方法并返回给下一个函数,插入过多,结构不清晰
// const log = v=> {
//   console.log(v)
//   return v
// }

//打印的位置,打印的数据
const trace = _.curry((tag,v)=>{
console.log(tag,v)
return v
})

// const f = _.flowRight(join("-"), log ,_.toLower, log ,split(" "))
const f = _.flowRight( join("-") , map(_.toLower) , split(" "))
// const f =  _.flowRight( join("-") , trace("map之后") , map(_.toLower) , trace("split之后") , split(" "))
console.log(f("NEVER SAY DIE"));
Point Free基于fp模块: 可以把数据处理的过程定义成与数据无关的合成运算,不需要用到代表数据的那个参数,只要把简单的运算步骤合成到一起,在使用这种模式之前我们需要定义一些辅助的基本运算函数。
Point Free风格指南
// 非 Point Free 模式
// Hello World => hello_world
function f (word) {
return word.toLowerCase().replace(/\s+/g, '_');
}
// Point Free
const fp = require('lodash/fp')
const f = fp.flowRight(fp.replace(/\s+/g, '_'), fp.toLower)
console.log(f('Hello World'))
Functor (函子)
什么是函子
- 容器:包含值和值的变形关系(这个变形关系就是函数)
- 函子:是一个特殊的容器,通过一个普通的对象来实现,该对象具有 map 方法,map 方法可以运行一个函数对值进行处理(变形关系)
函数式编程的运算不直接操作值,而是由函子完成
函子就是一个实现了 map 契约的对象
我们可以把函子想象成一个盒子,这个盒子里封装了一个值想要处理盒子中的值,
我们需要给盒子的 map 方法传递一个处理值的函数(纯函数),由这个函数来对值进行处理
最终 map 方法返回一个包含新值的盒子(函子)
// 一个容器,包裹一个值
class Container {
// of 静态方法,可以省略 new 关键字创建对象
static of (value) {
return new Container(value)
}
constructor (value) {
this._value = value
}
// map 方法,传入变形关系,将容器里的每一个值映射到另一个容器
map (fn) {
return Container.of(fn(this._value))
}
}
// 测试
Container.of(3)
.map(x => x + 2)
.map(x => x * x)
// 值如果不小心传入了空值(副作用)
Container.of(null)
.map(x => x.toUpperCase())
// TypeError: Cannot read property 'toUpperCase' of null
MayBe 函子
我们在编程的过程中可能会遇到很多错误,需要对这些错误做相应的处理,这时就可以使用到MayBe函子,MayBe 函子的作用就是可以对外部的空值情况做处理(控制副作用在允许的范围)
//MayBe 函子
//添加传入判空操作,防止报错导致不纯
class MayBe{
private _value
static of(value)
{
  return new MayBe(value)
}
constructor(value)
{
  this._value = value
}
map(fn)
{
  return this.isNothing()? MayBe.of(null):MayBe.of(fn(this._value)) //不存在返回一个内部变量是null的盒子
}
isNothing(){
  return this._value === null || this._value === undefined
}
}

let r = MayBe.of("hello world")
.map(x=>x.toUpperCase())
console.log(r);  // MayBe {_value:'HELLO WORLD'}
let w = MayBe.of(null)
.map(x=>x.toUpperCase())
console.log(w); // MayBe {_value: null}
Either函子
但是Mybe函子有个问题,就是无法判断哪一步的值为null,所以就需要使用Either函子,Either函子解决了由MayBe函子链式调用产生错误但无法定位错误的情况
//MayBe 函子有个问题 ,无法抓取链式调用哪一步为null,解决办法Either函子
let k = MayBe.of("hello world")
.map(x=>x.toUpperCase())
.map(x=>null)
.map(x=>x.split(" "))
console.log(k); //MayBe { _value: null }

//MayBe 函子有个问题 ,无法抓取链式调用哪一步为null,解决办法Either函子
let k = MayBe.of("hello world")
.map(x=>x.toUpperCase())
.map(x=>null)
.map(x=>x.split(" "))
console.log(k); //MayBe { _value: null }
//使用Either函子处理报错案例
function parseJSON(str) {
try{
return Right.of(JSON.parse(str))
}catch(e){
return Left.of(e.message)
}
}
let r3 = parseJSON("{name:'mcgee'}")
console.log(r3) //Left { _value: 'Unexpected token n in JSON at position 1' }
let r4 = parseJSON('{"name":"mcgee"}')
console.log(r4) //Right { _value: { name: 'mcgee' } }IO函子
IO函子与其他函子本质区别是_value是一个函数,函数可以是不纯的,可以用于异步执行,将纯不纯的内部函数包裹在纯函数中,用_value()来延时执行不纯的操作
//io 函子,inputoutput
//_value为函数,将传入的value包裹在函数中
//通过_value()惰性请求,可以包裹不纯函数
const fp = require("lodash/fp")
class IO{
public _value;
static of(value){
  return new IO(function(){
    return value
  })
}
constructor(fn){
  this._value = fn
}

map(fnMap){
  return new IO(fp.flowRight(fnMap,this._value))
}
}
//使用IO函子输出process.execPath
const r1 = IO.of(process)
.map(x=>x.execPath)
console.log(r1._value())
/使用IO函子执行异步
const r = IO.of("hello,world")
.map(x=>{
  return new Promise(resolve=>{
    setTimeout(()=>{
      resolve(x.split(","))
    },2000)
  })
})
.map(x=>x.then((res)=>res.join("_")))
console.log(r._value().then(result=>console.log(result)))
//输出Promise{<pending>} 2slater... hello_world
//IO函子通过map会返回一个新IO函子,那么这个新IO函子格式 是 `A {_value:{}}`
//这个函数是立即返回的,所以在第一个map里的异步还未执行完时候已经有Promise { <pending> }新函子对象输出了
Point函子
Point函子:实现了of静态方法的函子,of方法是为了避免使用new来创建对象,更深层的含义是of方法用来把值放到上下文Context(把值放到容器中,使用map来处理)
Monad函子
如果有两个IO函子,放入fp.flowRight("IO2","IO1")执行,那么会产生函子嵌套,解决函子嵌套问题,就需要使用Monad函子,Monad函子:由于IO函子组合时会出现嵌套函子情况,Monad函子是可以变扁的Point函子 IO(IO(x)),一个函子如果具有join和of两个方法并遵守一些定律就是Monad
//IO函子的问题 嵌套问题
const fp = require('lodash/fp')
const fs = require("fs")
class IO{
private _value
static of(value){
return new IO(function(){
return value
})
}
constructor(fn)
{
this._value = fn
}
map(fnMap){
return new IO(fp.flowRight(fnMap,this._value))
}
}
//案例,读取文件,并打印
//读出文件存在异步,导致函数不纯,用IO包一下
function readFile(filename) {
return new IO(function () {
return fs.readFileSync(filename,"utf-8") //node fs 同步读取
})
}
function print(data) {
return new IO(function(){
console.log(data)
return data
})
}
//我们知道flowRight执行时,会把添加的函数从右至左依次执行,并且,先执行的函数的返回值会传给下一个函数,也就是f(g(k()))
//那么下面函数的执行时,readFile执行完返回一个new IO函子,再把新函子通过 data形参 执行print 执行print函子,
//当print IO执行完,也会返回了一个new IO
//此时两个IO的关系相当于 IO(IO(data))
/**
* {
tag: 'print 返回的 IO'
_value: function() {
return {
tag: 'readFile 返回的 IO',
_value: function() {
return fs.readFileSync(...)
}
}
}
}
第一次调用 _value() 就是执行了 print 返回的 IO 函子
第二次调用 _value() 就是执行了 readFile 返回的 IO 函子
*
*/
let cat = fp.flowRight(print,readFile)
let r = cat("package.json")
console.log(r) //IO { _value: [Function] } 类似IO(IO(data))
console.log(r._value(),r._value()._value()) //输出 print的函子,readFile的函子
当然可以对Monad进行额外操作
let r = readFile("package.json")
.map(fp.toUpper) //转化成大写
.flatMap(print)
.join()
// console.log(r,r._value())
consolefolktale函数式编程库与task函子
folktale函数式编程库中提供了compose,curry等方法和Task,Either,MayBe等函子
//folktale 中的compose curry
const {compose,curry} = require("folktale/core/lambda")
const {toUpper,first} = require("lodash/fp")

let f = curry(2,function (x,y) {  //参数1表示参数个数,参数2便是柯里化的函数
  return x+y
})
console.log(f(1)(6));

let f1 = compose(toUpper,first) //从右向左执行
console.log(f1(["first","one"]))
//folktale 中的Task异步处理
//案例:解析package.json里的version
const {task} = require("folktale/concurrency/task") //task在2.0中是个函数,返回一个函子对象
const fs = require("fs") //node读取文件模块

function readFile(filename) {
return task((resolver)=> { //task接收一个函数,接收函数固定参数resolver,返回一个Task函子
  fs.readFile(filename,'utf-8',(err,data)=>{ //node读取文件api,文件名|格式|回调错误优先
    if(err) resolver.reject(err)
    resolver.resolve(data)
  })
})
}
readFile("package.json")
.run()                  //执行readFile
.listen({               //监听返回值
  onRejected:err=>{
    console.log(err)
  },
  onResolved:msg=>{
    console.log(msg);   //打印出读出的package.json
  }
})
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论