Java | 容器
文章目录
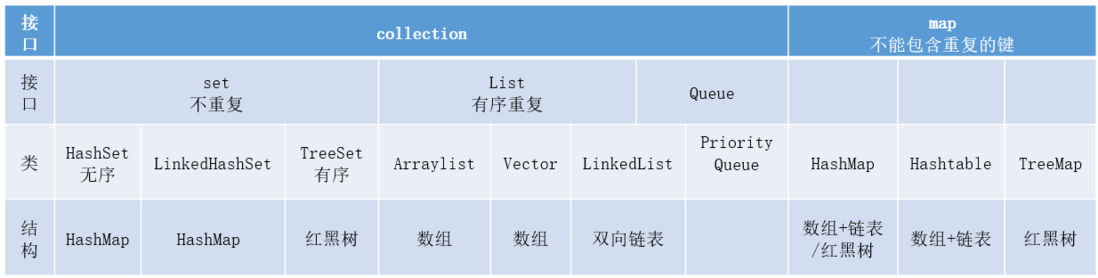
容器主要包括 Collection 和 Map 两种,Collection 存储着对象的集合,而 Map 存储着键值对的映射表。
1. List<interface>
1. ArrayList
public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, Serializable- ArrayList 的底层是数组队列,相当于动态数组。
- 数组的默认大小为 10。 扩容是旧容量的 1.5 倍
- 继承了 AbstractList,实现了 List。它是一个数组队列,提供了相关的添加、删除、修改、遍历等功能。
- 实现了 RandomAccess 接口,支持快速随机访问的。可以通过元素的序号快速获取元素对象。
- 实现了 Cloneable 接口,即覆盖了函数 clone(),能被克隆。
- 实现 java.io.Serializable 接口,这意味着 ArrayList 支持序列化,能通过序列化去传输。
不是线程安全的。多线程使用时,用:
Collections.synchronizedList();得到一个线程安全的 ArrayList。- 使用concurrent 并发包下的
CopyOnWriteArrayList类。
2. vector
- 它的实现与 ArrayList 类似。
- 扩容时容量翻倍。
- 线程安全:synchronized 进行同步。
3. LinkedList
- 实现了 List 接口 和 Deque 接口 的双端链表。
- 链表结构:使它支持高效的插入和删除操作。Deque 接口:使得 LinkedList 类也具有队列的特性。
- 不是线程安全的。
2. Map<interface>
1. HashMap
HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, SerializableJDK1.8 之前 HashMap 由 数组+链表 组成的,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的("拉链法"解决冲突)。JDK1.8 以后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树,以减少搜索时间。
HashMap 底层实现原理
1. 以idk7为例说明:
HashMap map = new HashMap():在实例化以后,底层创建了长度是 16 的一维数组Entry[] table。
向HashMap中添加一个数据的过程 map.put(key1,value1):
首先,调用 key1 所在类的 hashCode() 计算 key1 哈希值,此哈希值经过某种算法计算以后,得到在 Entry 数组中的存放位置。
- 如果此位置上的数据为空,此时的 key1-value1 添加成功。-—-情况1
如果此位置上的数据不为空,(意味着此位置上存在一个或多个数据(以链表形式存在)),比较 key1 和已经存在的一个或多个数据的哈希值:
- 如果 key1 的哈希值与已经存在的数据的哈希值都不相同,此时
key1-value1添加成功。--—-情况2 如果 key1 的哈希值和已经存在的某一个数据(
key2-value2)的哈希值相同,继续比较:调用 key1 所在类的equals(key2)- 如果
equals()返回false:此时key1-value1添加成功。-—-情况3 - 如果
equals()返回true: 使用 value1 替换 value2。
- 如果
- 如果 key1 的哈希值与已经存在的数据的哈希值都不相同,此时
补充:关于情况 2 和情况 3:此时 key1-value1 和原来的数据以链表的方式存储。
在不断的添加过程中,会涉及到扩容问题,默认的护容方式:扩容为原来容量的2倍,并将原有的数据复制过来。
源码
transient Entry[] table;static class Entry<K,V> implements Map.Entry<K,V> {
final K key;
V value;
Entry<K,V> next;
int hash;
Entry(int h, K k, V v, Entry<K,V> n) {
value = v;
next = n;
key = k;
hash = h;
}
public final K getKey() {
return key;
}
public final V getValue() {
return value;
}
public final V setValue(V newValue) {
V oldValue = value;
value = newValue;
return oldValue;
}
// 重写 equals
public final boolean equals(Object o) {
if (!(o instanceof Map.Entry))
return false;
Map.Entry e = (Map.Entry)o;
Object k1 = getKey();
Object k2 = e.getKey();
if (k1 == k2 || (k1 != null && k1.equals(k2))) {
Object v1 = getValue();
Object v2 = e.getValue();
if (v1 == v2 || (v1 != null && v1.equals(v2)))
return true;
}
return false;
}
// 重写 hashCode
public final int hashCode() {
return Objects.hashCode(getKey()) ^ Objects.hashCode(getValue());
}
public final String toString() {
return getKey() + "=" + getValue();
}
}添加元素
public V put(K key, V value) {
    //其允许存放null的key和null的value,当其key为null时,调用putForNullKey方法,放入到table[0]的这个位置
    if (key == null)
        return putForNullKey(value);
    //通过调用hash方法对key进行哈希,得到哈希之后的数值。该方法实现可以通过看源码,其目的是为了尽可能的让键值对可以分不到不同的桶中
    int hash = hash(key);
    //根据上一步骤中求出的hash得到在数组中是索引i
    int i = indexFor(hash, table.length);
    //如果i处的Entry不为null,则通过其next指针不断遍历e元素的下一个元素。
    for (Entry<K,V> e = table[i]; e != null; e = e.next) {
        Object k;
        if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
            V oldValue = e.value;
            e.value = value;
            e.recordAccess(this);
            return oldValue;
        }
    }

    modCount++;
    addEntry(hash, key, value, i);
    return null;
}
2. jdk8相较jdk7在底层实现方面的不同:
new HashMap():底层没有创建一个长度为16的数组。- jdk8底层的数组是:Node[],而非 Entry[]。
- 首次调用 put() 方法时,底层创建长度为16的教组。
- jdk7 底层结构只有:数组+链表。jdk8 中底层结构:数组+链表+红黑树。 当数组的某一个索引位置上的元素以链表形式存在的数据个数 > 8, 且当前数组的长度 > 64 时,此时此索引位置上的所有数据改为使用红黑树存储。
2. HashTable
public class Hashtable<K,V> extends Dictionary<K,V> implements Map<K,V>, Cloneable, Serializable- 结构与 HashMap 大体相同。
- 是线程同步的。
3. TreeMap
public class TreeMap<K,V> extends AbstractMap<K,V> implements NavigableMap<K,V>, Cloneable, Serializable基于红黑树 (Red-Black tree) 的 NavigableMap 实现。 该映射根据其键的自然顺序进行排序,或者根据创建映射时提供的 Comparator 进行排序,具体取决于使用的构造方法。
4. LinkedHashMap
继承自 HashMap,具有高效性,同时在 HashMap 的基础上,又在内部增加了一个链表,用以存放元素的顺序。
1. linkedHashMap工作原理、实现机制
1. 结构:HashMap + 双向链表
这个双向链表保证 LinkedHashMap 存储数据是有序的,而且分为两种:插入顺序和访问顺序。
2. 初始化:构造函数初始化了一个 Entry[] table,和一个只有头结点的双向链表。
3. put元素:不但要把它加入到 HashMap 中去,还要加入到双向链表中。
3. 扩容
- HashMap 是先遍历旧 table,再遍历旧 table 中每个元素的单向链表,取得 Entry 以后,重新计算 hash 值,然后存放到新 table 的对应位置。
- LinkedHashMap 是遍历双向链表,取得每一个Entry,然后重新计算 hash 值,存放到新 table 的对应位置。
从遍历的效率来说,遍历双向链表的效率要高于遍历 table,因为遍历双向链表是 N 次( N 为元素个数);而遍历 table 是 N+table 的空余个数( N 为元素个数)。
4. 更新数据重排序:,
- put 元素,访问顺序模式时, 比如 put 的一个 key 原来 table 已经存在了,那么就要更新这个 value。LinkedHashMap会直接删除双向链表中旧的 entry, 再在链表尾插入新的 entry.
- get 元素,访问顺序模式时,get 的 entry 在双向链表中删除,插入到链表尾部。
5. ConcurrentHashMap
- 底层数据结构: JDK1.8 的 ConcurrentHashMap 底层采用的数据结构跟 HashMap1.8 的结构一样,数组+链表/红黑二叉树。
- 实现线程安全的方式(重要): 采用了分段锁(Segment),每个分段锁维护着几个桶(HashEntry),多个线程可以同时访问不同分段锁上的桶,从而使其并发度更高(并发度就是 Segment 的个数)。Segment 继承自 ReentrantLock .
3. Set<interface>
集合:不包含重复元素的 collection。
常见面试题
1. Arraylist 与 LinkedList 有什么区别?
- 是否保证线程安全: ArrayList 和 LinkedList 不保证线程安全。
- 底层数据结构: Arraylist : 数组;LinkedList : 双向链表(JDK1.6之前为循环链表,JDK1.7取消了循环)。
- 插入和删除效率:
① ArrayList 采用数组存储,所以插入和删除元素的时间复杂度受元素位置的影响, 近似 O(n)。
② LinkedList 采用链表存储,所以插入,删除元素时间复杂度不受元素位置的影响,是近似 O(1)。
- 是否支持快速随机访问: LinkedList 不支持随机元素访问,而 ArrayList 支持。
- 内存空间占用:
①ArrayList 结尾会预留一定的容量空间。
② LinkedList 的每一个元素都需要消耗比 ArrayList 更多的空间(因为要存放直接后继和直接前驱以及数据)。
2. ArrayList 与 Vector 的区别是什么?
- 线程安全:Vector 使用了 Synchronized 来实现线程同步,是线程安全的;而 ArrayList 是非线程安全的。
- 性能:ArrayList 在性能方面要优于 Vector (在同步操作上耗费大量的时间 )。
- 扩容:Vector 每次扩容请求其大小的 2 倍(也可以通过构造函数设置增长的容量),而 ArrayList 是 1.5 倍。
3. HashMap、HashTable、ConcurrentHashMap的区别?
1. 线程安全之间的区别
- HashMap 是非 synchronized 的。
- 而 Hashtable 是 synchronized,因为它对remove,put,get 进行了同步控制,保证了 HashTable 的线程安全性。
- ConcurrentHashMap,使用了锁分段技术,因为 ConcurrentHashMap 将 Map 分段了,每个段进行加锁而不是像 HashTable, SynchronizedMap 是整个 map 加锁,这样就可以多线程访问了。
2. 两者输入参数的区别
- HashMap: 可以存储 null 键和 null 值。
- HashTable: 无论 key 还是 value 都不能为 null。
3. 关于扩容区别
HashMap:
- 初始 size 为16。
- 扩容:扩容为原来的 2 倍(newsize = oldsize*2)。
- 如果给定了初始化大小会将大小扩充为 2 的幂次方大小。
HashTable
- 初始 size 为 11。
- 扩容:扩容为原来的 2 倍 + 1(newsize = olesize*2+1)。
- 如果给定了初始化大小就会直接使用。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论