Redis基础(一):Redis的数据结构
文章目录
Redis的数据结构
为什么 Redis 能有这么突出的表现呢?
一方面,这是因为它是内存数据库,所有操作都在内存上完成,内存的访问速度本身就很快。
另一方面,这要归功于它的数据结构。这是因为,键值对是按一定的数据结构来组织的,操作键值对最终就是对数据结构进行增删改查操作,所以高效的数据结构是 Redis 快速处理数据的基础。
简单来说,Redis底层数据结构一共有 6 种,分别是简单动态字符串、双向链表、压缩列表、哈希表、跳表和整数数组。它们和数据类型的对应关系如下图所示:
String 类型的底层实现只有一种数据结构,也就是简单动态字符串。而 List、Hash、Set 和 Sorted Set 这四种数据类型,都有两种底层实现结构。通常情况下,我们会把这四种类型称为集合类型,它们的特点是一个键对应了一个集合的数据。
键和值的结构组织
为了实现从键到值的快速访问,Redis 使用了一个哈希表来保存所有键值对。一个哈希表,其实就是一个数组,数组的每个元素称为一个哈希桶。每个哈希桶中保存了键值对数据。哈希桶中的元素保存的并不是值本身,而是指向具体值的指针。这也就是说,不管值是 String,还是集合类型,哈希桶中的元素都是指向它们的指针。
哈希桶中的 entry 元素中保存了key和value指针,分别指向了实际的键和值,这样一来,即使值是一个集合,也可以通过*value指针被查找到。

因为这个哈希表保存了所有的键值对,所以,我也把它称为全局哈希表。哈希表的最大好处很明显,就是让我们可以用 O(1) 的时间复杂度来快速查找到键值对——我们只需要计算键的哈希值,就可以知道它所对应的哈希桶位置,然后就可以访问相应的 entry 元素。你看,这个查找过程主要依赖于哈希计算,和数据量的多少并没有直接关系。也就是说,不管哈希表里有 10 万个键还是 100 万个键,我们只需要一次计算就能找到相应的键。但是,如果你只是了解了哈希表的 O(1) 复杂度和快速查找特性,那么,当你往 Redis 中写入大量数据后,就可能发现操作有时候会突然变慢了。这其实是因为你忽略了一个潜在的风险点,那就是哈希表的冲突问题和 rehash 可能带来的操作阻塞。
哈希冲突
当你往哈希表中写入更多数据时,哈希冲突是不可避免的问题。这里的哈希冲突,也就是指,两个 key 的哈希值和哈希桶计算对应关系时,正好落在了同一个哈希桶中。毕竟,哈希桶的个数通常要少于 key 的数量,这也就是说,难免会有一些 key 的哈希值对应到了同一个哈希桶中。
Redis 解决哈希冲突的方式,就是链式哈希。链式哈希也很容易理解,就是指同一个哈希桶中的多个元素用一个链表来保存,它们之间依次用指针连接。

rehash 操作
但是上面依然存在一个问题,哈希冲突链上的元素只能通过指针逐一查找再操作。如果哈希表里写入的数据越来越多,哈希冲突可能也会越来越多,这就会导致某些哈希冲突链过长,进而导致这个链上的元素查找耗时长,效率降低。对于追求“快”的 Redis 来说,这是不太能接受的。
所以,Redis 会对哈希表做 rehash 操作。rehash 也就是增加现有的哈希桶数量,让逐渐增多的 entry 元素能在更多的桶之间分散保存,减少单个桶中的元素数量,从而减少单个桶中的冲突。那具体怎么做呢?
其实,为了使 rehash 操作更高效,Redis 默认使用了两个全局哈希表:哈希表1和哈希表2。一开始,当你刚插入数据时,默认使用哈希表 1,此时的哈希表 2 并没有被分配空间。随着数据逐步增多,Redis 开始执行 rehash,这个过程分为三步:
1)给哈希表2分配更大的空间,例如是当前哈希表1大小的两倍。
2)把哈希表1中的数据重新映射并拷贝到哈希表2中。
3)释放哈希表1的空间。
到此,我们就可以从哈希表 1 切换到哈希表 2,用增大的哈希表 2 保存更多数据,而原来的哈希表 1 留作下一次 rehash 扩容备用。
这个过程看似简单,但是第二步涉及大量的数据拷贝,如果一次性把哈希表 1 中的数据都迁移完,会造成 Redis 线程阻塞,无法服务其他请求。此时,Redis 就无法快速访问数据了。
为了避免这个问题,Redis 采用了渐进式 rehash。简单来说就是在第二步拷贝数据时,Redis 仍然正常处理客户端请求,每处理一个请求时,从哈希表 1 中的第一个索引位置开始,顺带着将这个索引位置上的所有 entries 拷贝到哈希表 2 中;等处理下一个请求时,再顺带拷贝哈希表 1 中的下一个索引位置的 entries。如下图所示

这样就巧妙地把一次性大量拷贝的开销,分摊到了多次处理请求的过程中,避免了耗时操作,保证了数据的快速访问。
到这里,你应该就能理解,Redis 的键和值是怎么通过哈希表组织的了。对于 String 类型来说,找到哈希桶就能直接增删改查了,所以,哈希表的 O(1) 操作复杂度也就是它的复杂度了。
但是,对于集合类型来说,即使找到哈希桶了,还要在集合中再进一步操作。接下来,我们来看集合类型的操作效率又是怎样的。
集合数据操作效率
和 String 类型不同,一个集合类型的值,第一步是通过全局哈希表找到对应的哈希桶位置,第二步是在集合中再增删改查。那么,集合的操作效率和哪些因素相关呢?首先,与集合的底层数据结构有关。例如,使用哈希表实现的集合,要比使用链表实现的集合访问效率更高。其次,操作效率和这些操作本身的执行特点有关,比如读写一个元素的操作要比读写所有元素的效率高。
接下来,我们就分别聊聊集合类型的底层数据结构和操作复杂度。
集合类型的底层数据结构主要有 5 种:整数数组、双向链表、哈希表、压缩列表和跳表。
整数数组和双向链表
整数数组和双向链表很常见,它们的操作特征都是顺序读写,也就是通过数组下标或者链表的指针逐个元素访问,操作复杂度基本是 O(N),操作效率比较低;压缩列表和跳表我们平时接触得可能不多,但它们也是 Redis 重要的数据结构,下面来重点解释一下。
压缩列表
压缩列表实际上类似于一个数组,数组中的每一个元素都对应保存一个数据。和数组不同的是,压缩列表在表头有三个字段 zlbytes、zltail 和 zllen,分别表示列表长度、列表尾的偏移量和列表中的 entry 个数;压缩列表在表尾还有一个 zlend,表示列表结束。(压缩列表的设计不是为了查询的,而是为了减少内存的使用和内存的碎片化。比如一个列表中的只保存int,结构上还需要两个额外的指针prev和next,每添加一个结点都这样。而压缩列表是将这些数据集合起来只需要一个prev和next。)

在压缩列表中,如果我们要查找定位第一个元素和最后一个元素,可以通过表头三个字段的长度直接定位,复杂度是 O(1)。而查找其他元素时,就没有这么高效了,只能逐个查找,此时的复杂度就是 O(N) 了。
有序链表
有序链表只能逐一查找元素,导致操作起来非常缓慢,于是就出现了跳表。具体来说,跳表在链表的基础上,增加了多级索引,通过索引位置的几个跳转,实现数据的快速定位,如下图所示
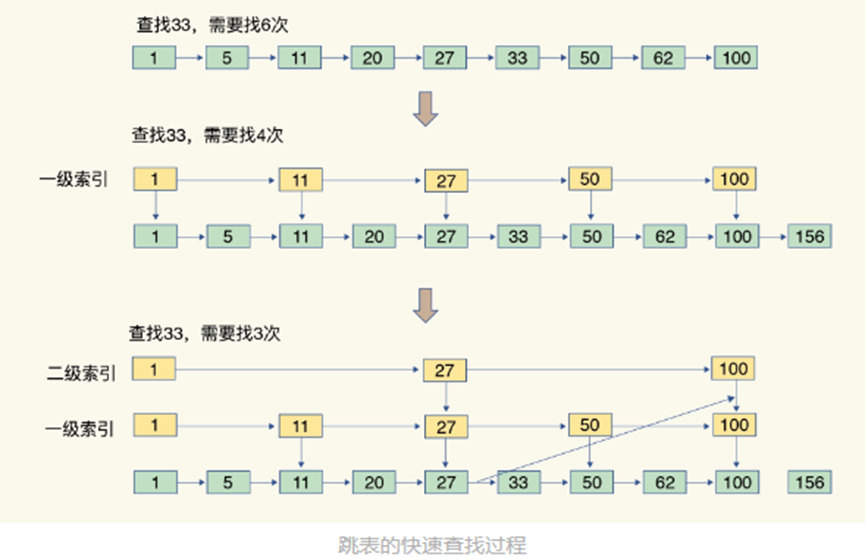
如果我们要在链表中查找 33 这个元素,只能从头开始遍历链表,查找 6 次,直到找到 33 为止。此时,复杂度是 O(N),查找效率很低。为了提高查找速度,我们来增加一级索引:从第一个元素开始,每两个元素选一个出来作为索引。这些索引再通过指针指向原始的链表。例如,从前两个元素中抽取元素 1 作为一级索引,从第三、四个元素中抽取元素 11 作为一级索引。此时,我们只需要 4 次查找就能定位到元素 33 了。
如果我们还想再快,可以再增加二级索引:从一级索引中,再抽取部分元素作为二级索引。例如,从一级索引中抽取 1、27、100 作为二级索引,二级索引指向一级索引。这样,我们只需要 3 次查找,就能定位到元素 33 了。可以看到,这个查找过程就是在多级索引上跳来跳去,最后定位到元素。这也正好符合“跳”表的叫法。当数据量很大时,跳表的查找复杂度就是 O(logN)。
好了,我们现在可以按照查找的时间复杂度给这些数据结构分下类了:

不同操作的复杂度
通过上面的讲解,我们就可以在应用中规避高复杂度操作了,无需死记硬背记住以下口诀就行:单元素操作是基础;范围操作非常耗时;统计操作通常高效;例外情况只有几个。
单元素操作,是指每一种集合类型对单个数据实现的增删改查操作。例如Hash类型(HGET、HSET、HDEL),SET(SADD、SREM、SRANDMEMBER)。
Set 类型用哈希表作为底层数据结构时,它的 SADD、SREM、SRANDMEMBER 复杂度也是 O(1)。
集合类型支持同时对多个元素进行增删改查,例如 Hash(HMGET、HMSET),Set (SADD) 也支持同时增加多个元素。此时,这些操作的复杂度,就是由单个元素操作复杂度和元素个数决定的。例如,HMSET 增加 N个元素时,复杂度就从 O(1) 变成 O(N) 了。
范围操作,是指集合类型中的遍历操作,可以返回集合中的所有数据,比如 Hash 类(HGETALL),Set类(SMEMBERS),或者返回范围内的部分数据,如List类(LRANGE)和Zset类(ZRANGE),这些操作复杂度一般是O(N),比较耗时,尽量避免。
统计操作,是指集合类型对集合中所有元素个数的记录,例如 LLEN 和 SCARD。这类操作复杂度只有 O(1),这是因为当集合类型采用压缩列表、双向链表、整数数组这些数据结构时,这些结构中专门记录了元素的个数统计,因此可以高效地完成相关操作。
例外情况,是指某些数据结构的特殊记录,例如压缩列表和双向链表都会记录表头和表尾的偏移量。这样一来,对于 List 类型的 LPOP、RPOP、LPUSH、RPUSH 这四个操作来说,它们是在列表的头尾增删元素,这就可以通过偏移量直接定位,所以它们的复杂度也只有 O(1),可以实现快速操作。
小结
这节课,我们学习了 Redis 的底层数据结构,这既包括了 Redis 中用来保存每个键和值的全局哈希表结构,也包括了支持集合类型实现的双向链表、压缩列表、整数数组、哈希表和跳表这五大底层结构。
Redis 之所以能快速操作键值对,一方面是因为 O(1) 复杂度的哈希表被广泛使用,包括 String、Hash 和 Set,它们的操作复杂度基本由哈希表决定,另一方面,Sorted Set 也采用了 O(logN) 复杂度的跳表。
不过,集合类型的范围操作,因为要遍历底层数据结构,复杂度通常是 O(N)。这里,我的建议是:用其他命令来替代,例如可以用 SCAN 来代替,避免在 Redis 内部产生费时的全集合遍历操作。
当然,我们不能忘了复杂度较高的 List 类型,它的两种底层实现结构:双向链表和压缩列表的操作复杂度都是 O(N)。因此,建议因地制宜地使用 List 类型。例如,既然它的 POP/PUSH 效率很高,那么就将它主要用于 FIFO 队列场景,而不是作为一个可以随机读写的集合。
Redis 数据类型丰富,每个类型的操作繁多,我们通常无法一下子记住所有操作的复杂度。所以,最好的办法就是掌握原理,以不变应万变。这里,你可以看到,一旦掌握了数据结构基本原理,你可以从原理上推断不同操作的复杂度,即使这个操作你不一定熟悉。这样一来,你不用死记硬背,也能快速合理地做出选择了。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论