Data-方法-02 k近邻法
文章目录
Data-方法-02 k近邻法
Keep good men company and you shall be of the number.
- Data系列:目录 | 配置 | 代码仓库 | 对应实战
- 对应《数据挖掘导论》第5章、《机器学习》第10章和《统计学习方法(第2版)》第3章。
- k近邻法是一种基本的分类与回归方法,是懒惰学习(lazy learning)的著名代表,在《数据挖掘导论》和《机器学习》已经没有单独的篇章介绍了(只留下一个小部分),而《统计学习方法(第2版)》中还留下一个章节专门介绍。可见k近邻法并不复杂,但仍是经典的值得学习的方法。
1. k近邻算法
【积极学习与消极学习】
- 积极学习/急切学习(eager learning):在训练阶段就开始学习从输入属性到类标号的映射模型,如决策树和基于规则的学习。
- 消极学习/懒惰学习(lazy learning):在训练阶段仅仅把样本保存起来,直到测试样例输入时再处理,如Rote分类器(当测试样例的属性与某个训练样例完全相同时再输出)和K近邻法。
【K近邻学习】
- k近邻(k-Nearest Neighbor, KNN)学习,是一种常见的监督学习方法,没有显式的学习过程。
- 工作机制:对给出的测试样例,使用某种距离度量找出训练集中与其最邻近的k个点,再根据决策规则(如多数表决)预测结果。
- 基本要素:k值的选择、距离度量、决策规则
2. k近邻要素
- k近邻学习的三个基本要素:k值的选择、距离度量和决策规则
【距离度量】
- 特征空间中两个点的距离表示其相似程度,k近邻模型中可以使用多种距离模型。
-
$L_p$距离/Minkowski 距离:$L_p(x_i,x_j)=(\sum^n_{l=1}|x_i^{(l)}-x_j^{(l)}|^p)^{\frac{1}{p}}$
- $p=1$,曼哈顿距离(Manhattan distance):$L_1(x_i,x_j)=\sum^n_{l=1}|x_i^{(l)}-x_j^{(l)}|$
- $p=2$,欧式距离(Euclidean distance):$L_2(x_i,x_j)=\sqrt{\sum^n_{l=1}|x_i^{(l)}-x_j^{(l)}|^2}$
- $p=\infty$,切比雪夫距离各个坐标距离的最大值:$L_{\infty}(x_i,x_j)=\max_l|x_i^{(l)}-x_j^{(l)}|$
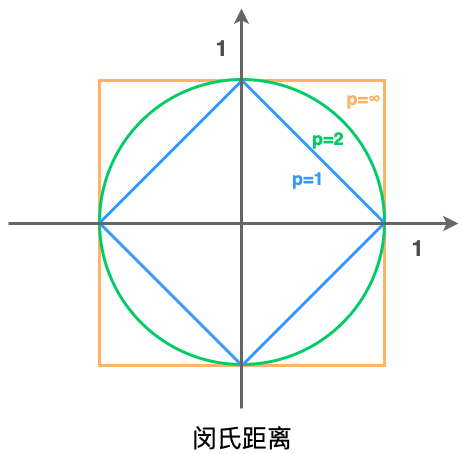
- 由不同的距离度量所确定的最近邻点是不同的。
【k值的选择】
-
k值较小,相当于用较小邻域中的训练实例进行预测
- 优点是“学习”的近似误差(approximation error)减小,只有与输入实例较近的训练实例才会对预测结果起作用;
- 缺点是估计误差(estimation error)增大,预测结果会对近邻的实例点非常敏感(即如果邻近的实例点恰好是噪声,则预测很容易出错)。
- k值减少,意味着整体模型变得复杂,容易发生过拟合。
-
k值较大,相当于用较大邻域的训练实例进行预测。
- 优点是可以减少学习的估计误差;
- 缺点是学习的近似误差会增大,与输入实例较远的训练实例也会产生作用,可能会误分类测试样例。
- k值增大,意味着整体模型更加简单。
- 在应用中,k值一般取一个比较小的数值,通常采用交叉验证法来选取最优的k值。
【决策规则】
- 通常,在分类任务中可使用“投票法”(多数表决规则);在回归任务中可使用“平均法”;还可以基于距离远近进行加权平均或加权投票。
-
多数表决规则(majority voting rule):使误分类率最低,等价于经验风险最小化
- $y'=\arg\max_v\sum_{(x_i,y_i)\in D_z}I(v=y_i)$
- 距离加权表示:$y'=\arg\max_v\sum_{(x_i,y_i)\in D_z}w_i\times I(v=y_i)$
3. k近邻实现
【线性扫描】
- 最邻近算法的高层描述、最简单的实现伪代码如下,
令$k$是最近邻数目,$D$是训练样例的集合:
for 每个测试样例 $z=(x',y')$ do
计算$z$和每个样例 $(x,y)\in D$ 之间的距离 ${\rm d}(x',x)$
- 选择离$z$最近的$k$个训练样例的集合$D_z\subset D$
- $y'=\arg\max_v\sum_{(x_i,y_i)\in D_z}w_i\times I(v=y_i)$
end for
- 这是一种线性扫描(linear scan)的描述,需要计算输入实例与每一个训练实例的距离,当训练集很大时,会很耗时。
- 使用高效的索引技术和特殊的结构存储训练数据,可以减少计算距离的次数,下面介绍《统计学习方法(第2版)》一书中给出的kd树(kd tree)方法。
【kd树简介】
- kd树是存储k维空间数据的树结构,对空间中的实例点进行存储以便对其进行快速搜索。
- kd树是二叉树,表示对k维空间的一个划分(partition);
【kd树的构造】
- 构造kd树相当于不断地用垂直于坐标轴的超平面将k维空间划分,构造一系列的k维超矩形区域。每个结点对应一个k维超矩形空间。
- 算法描述如下,
输入:k维空间数据集$T=\{x_1,x_2,...,x_N\}$,其中$x_i=(x_i^{(1)},x_i^{(2)},...,x_i^{(k)})^T$
输出:kd树
算法:
开始:构造根结点,根结点对应于包含$T$的$k$维空间的超矩形区域。
- 以$x^{(1)}$为坐标轴,以$T$中所有实例的$x^{(1)}$坐标的中位数为划分点,将根结点对应的超矩形区域划分为两个子区域。切分由通过切分点并与坐标轴$x^{(1)}$垂直的超平面实现。
- 生成深度为1的左右子结点:左结点对应坐标$x^{(1)}$小于切分点的子区域,右结点对应大于切分点的子区域。
- 将落在切分超平面上的实例点保存在根结点。
重复:对深度为$j$的结点,选择$x^{(l)}$作为切分的坐标轴,$l=j\ {\rm mod}\ k+1$,以该结点的区域中所有实例的$x^{(l)}$坐标的中位数作为划分点,将该结点对应的超矩形区域划分为两个子区域。切分由通过切分点于坐标轴$x^{(l)}$垂直的超平面实现。
- 生成深度为$j+1$的左右子结点:左结点对应坐标$x^{(1)}$小于切分点的子区域,右结点对应大于切分点的子区域。
将落在切分超平面上的实例点保存在该结点。- 结束:直到两个子区域没有实例存在时停止。
- 以中位数(median)为划分点,使得得到的kd树是平衡的。但平衡的kd树搜索时的效率未必是最优的。
【kd树的搜索】
- kd树的搜索,首先找到包含目标点的叶结点,然后从此出发回退到父节点,不断查找邻近点,直到确定不可能存在更近的结点终止。
-
算法描述如下(以最近邻为例)
输入:已构造的kd树,目标点x
输出:x的最近邻
算法:
- 在kd树中找出包含目标点x的叶结点:从根结点出发,递归向下访问,如果目标x当前维度的坐标小于切分点的坐标,则移动到左节点,否则移动到右结点,直到子结点为叶结点为止,并以此点为当前最近点;
-
递归向上回退,每一步:
- 如果该结点保存的实例点比当前最近点离目标点更近,则以该点为当前最近点;
-
检查该子结点的另一子结点对应区域是否有更近的点
- 有则,移动到另一子节点,递归地进行最近邻搜索;
- 否则,向上回退;
- 具体,寻找相交。
- 回退到根结点时,结束搜索。
- 如果实例点时随机分布的,kd树搜索的平均复杂度是$O(\log N)$。
- kd树更适合于训练实例数远大于空间维数时的k近邻搜索,当空间维数接近训练实例数时,效率会迅速下降,几乎接近线性扫描。
4. k近邻特点
- k近邻法是基本且简单的分类与回归方法,k近邻模型对应于基于训练数据集对特征空间的一个划分,
- k近邻属于基于实例的学习,使用具体的训练实例进行预测,而不必维护源自数据的抽象(或模型)。
- k近邻之类的消极学习方法,不需要建立模型,但分类测试样例的开销很大。
- k近邻基于局部信息进行预测,当k很小时,对噪声很敏感。
- k近邻可以生成任意形状的决策边界,提供更灵活的模型表示。
- k近邻需要有适当的邻近性度量和数据预处理。
参考资料
- 《数据挖掘导论》第5章
- 《机器学习》第10章
- 《统计学习方法(第2版)》第3章
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论