[大数据技术原理与应用笔记] 第10讲. Spark
文章目录
10.1 Spark与Hadoop的对比
Spark 相比于 Hadoop MapReduce的优缺点
- Spark的计算模式也属于MapReduce,但不限于Map和Reduce操作,提供了多种数据集操作类型,编程模式比Hadoop MapReduce更灵活
- Spark 基于DGA(有向无环图)的任务调度执行机制,要优于Hadoop MapReduce 的迭代执行机制
- 提供了内存计算,可将中间结果放到内存,对于迭代效率更高,而Hadoop MapReduce 计算的中间结果需要缓存到硬盘,IO开销大
10.3 Spark 运行架构
基本概念
- RDD:Resillient Distributed Dataset(弹性分布式数据集)的简称,是分布式内存的一个抽象概念,提供了一种高度受限的共享内存模型.
- DAG:有向无环图,反映RDD之间的依赖关系
- Executor:一个作业会被分为多个task。executor是运行在工作结点的一个进程,负责运行task。
- Application:用户编写的Spark 应用程序.
- Task:运行在executor上的工作单元
- Job:一个Job包含多个RDD,及作用在相应RDD上的各种操作.通常一个aoolication 包含多个job
- stage: 是job的基本调度单位,一个job包含多组task,每组task被称为stage,或者被称为TaskSet,代表了一组关联的,相互直接没有shuffle依赖关系的任务组成的任务集。
运行架构
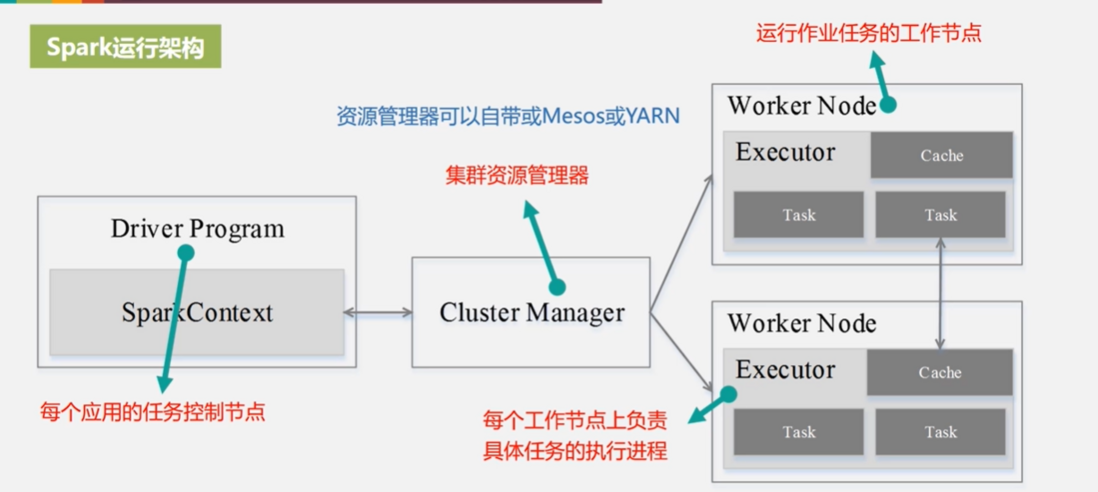
Executor 运行在Worker Node 上
与 MapReduce相比的优点:
- 在一个Excutor里,同时启动多个线程执行相关Task,而MapReduce以进程执行任务,所以Spark的启动开销小
- Excutor里有一个BlockManager的存储模块,将内存和磁盘共同作为存储设备,优先使用内存,当内存不足时再溢写到磁盘,有效减少IO开销
Spark 各种概念之间的相互关系
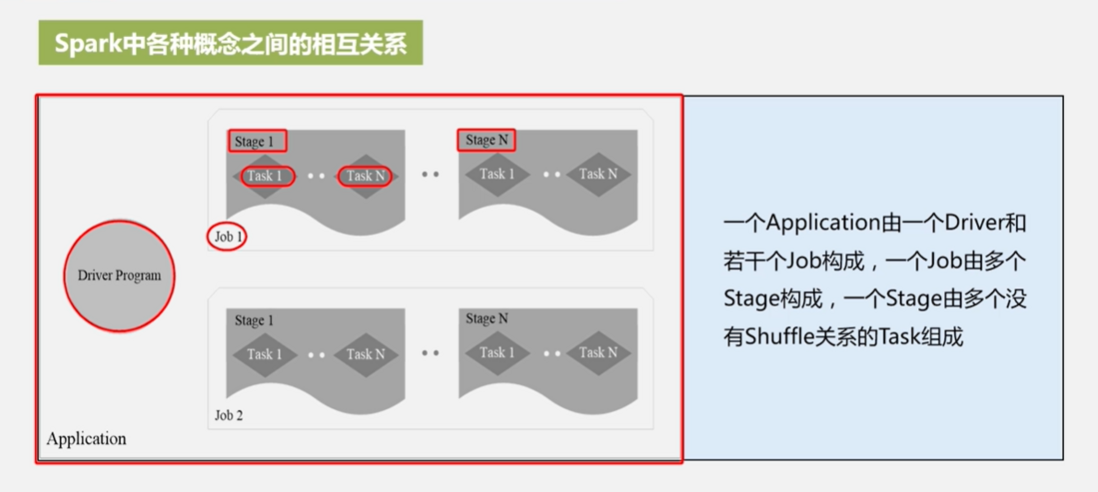
Drive Program 相当于管家
架构执行Application的大概过程
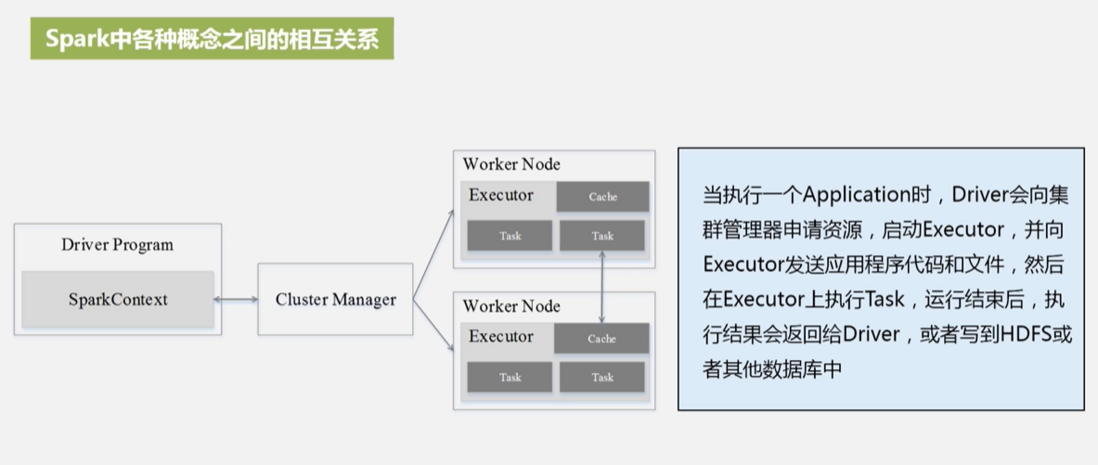
Spark 运行基本流程

- 为应用构建起基本的运行环境,即由Driver创建一个SparkContext进行资源的申请,任务的分配和监控.
- 资源管理器为Executor分配资源,启动Executor,Executor不断地向资源管理器汇报资源的使用情况.
- SparkContext 根据RDD依赖关系生成DAG图,并将DAG图提交给DAG Scheduler分解为stage,把一个个TaskSet 交给底层作业调度器Task Scheluder。Executor向Task Scheluder 申请Task,Task Scheluder 将Task分配给Executor 并提供相应的应用程序代码。
- Executor执行结束后把结果反馈给Task Scheluder,然后Task Scheluder 反馈给DAG Scheduler,运行完毕后写入数据并释放资源.
Spark 运行架构特点

RDD
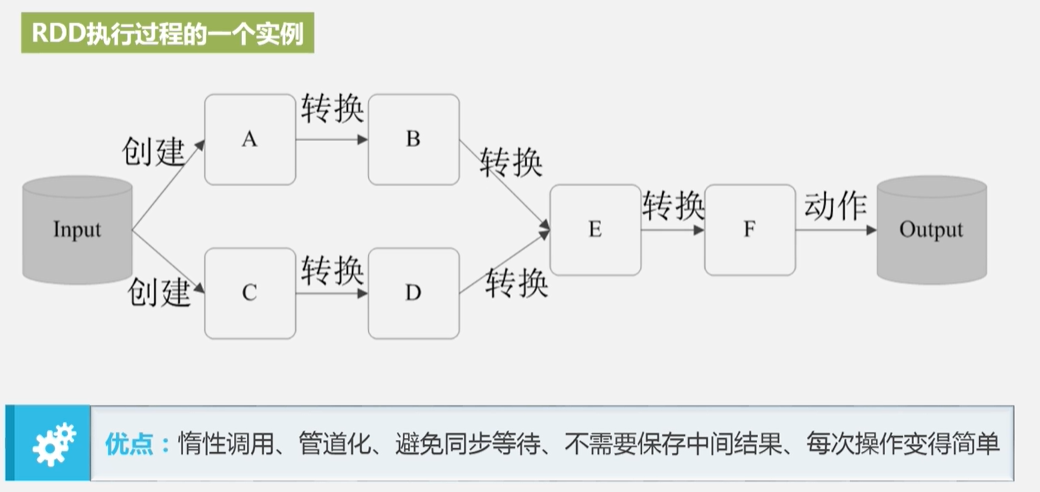
RDD 使得Spark运行效率高于MapReduce的原因/RDD的特性:
- 高效的容错性。通常的容错机制通过日志记录,恢复日志中记录的操作来恢复数据,而这不适合数据密集性将会带来巨大的开销。RDD的错误恢复只需要通过该RDD在DAG中的上一个RDD再做一次转换即可。
- 中间结果持久化到内存,数据在内存中多个RDD操作之间传递,避免了不必要的磁盘开销
- 存放的是java对象,避免了序列化和反序列化(存到磁盘需要序列化)
RDD 依赖关系
- 窄依赖:一个父RDD的分区对应一个子RDD的分区;或多个RDD的分区对应一个子RDD的分区
- 宽依赖: 一个父RDD的一个分区对应一个子RDD的多个分区
Stage 划分
- DAG中进行反向解析,遇到宽依赖就断开
- 遇到窄依赖就把当前的RDD加入到Stage中
- 将窄依赖尽量划分到同一个stage中,可以实现流水线计算,从而使得数据可以在内存中之间交换,避免了IO开销
例子: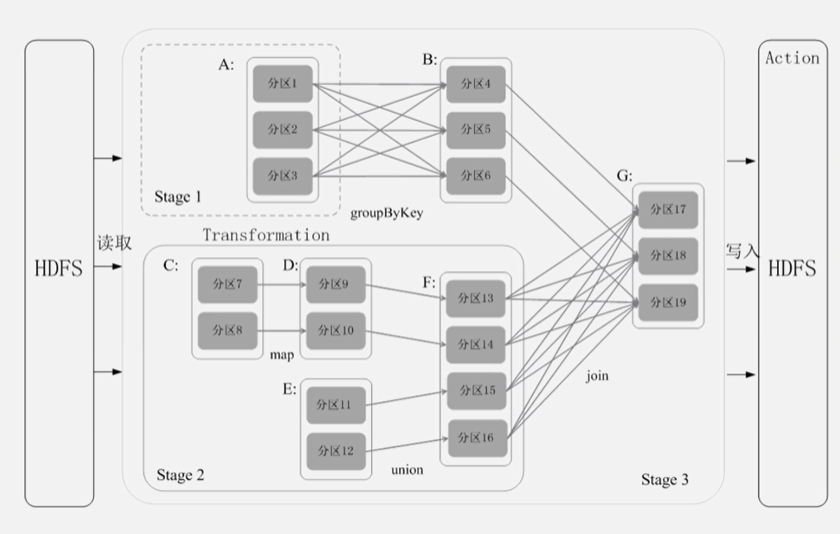
Stage 类型:
ShuffleMapStage
- 不是最终的stage,在他之后还有其他stage,所以它的输出一定会经过shuffle过程,并作为后续stage的输入
- 以Shuffle作为输出边界,输入边界可以是从外部获取数据也可以是另一个ShuffleMapStage的输出
- 一个Job里可能有改类型的Stage,也可能没有(一次转换计算就结束了不需要其他stage,这种为ResultStage)
ResultStage
- 最终的Stage,没有输出,而是直接产生结果或存储
- 这种stage直接输出结果,输入边界可以是直接输入也可以是ShuffleMapStage的输出
- 一个Job里一定包含至少一个ResultStage
RDD运行过程
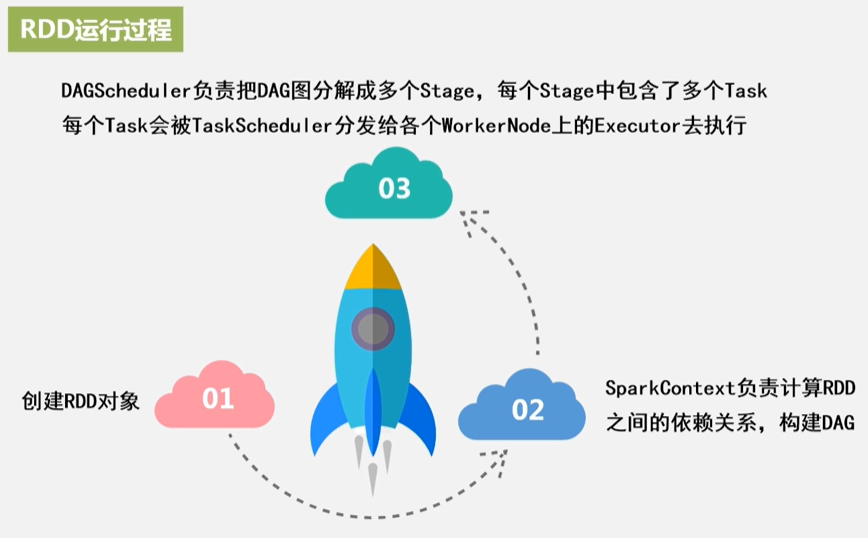
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论