PaddleVideo升级发布:顶会算法重磅开源!
文章目录
全文5352字,预计阅读时间14分钟
随着短视频的快速发展以及安全管理的需求不断增多,视频领域的相关技术应用包括视频智能标签、智能教练、智能剪辑、智能安全管理、文本视频检索、视频精彩片段提取、视频智能封面正逐渐成为人们生活中的重要部分。
以视频相关业务为例,短视频网站希望能迅速给每个新作品打上标签并推送给合适的用户,剪辑人员希望从比赛视频中便捷地提取精彩比赛片段集锦,教练员希望系统分析运动员的动作并进行技术统计和分析,安全管理部门也希望能精准地进行视频内容审核比如实时识别违规行为,编辑人员希望通过文本检索相关的视频片段作为新闻素材,广告或推荐网站希望为视频生成更加美观的封面提升转化率。这些业务对传统的人工处理方式是很大的挑战。
视频理解是通过AI技术让机器理解视频内容,如今在短视频、推荐、搜索、广告,安全管理等领域有着广泛的应用和研究价值,像动作定位与识别、视频打标签、文本视频检索、视频内容分析之类的任务都可以通过视频理解技术搞定。
PaddleVideo是百度自主研发的产业级深度学习开源开放平台飞桨的视频开发套件,包含视频领域众多模型算法和产业案例,本次开源主要升级点如下:
- 发布10个视频领域产业级应用案例,涵盖体育、互联网、医疗、媒体和安全等行业。
- 首次开源5个冠军/顶会/产业级算法,包含视频-文本学习、视频分割、深度估计、视频-文本检索、动作识别/视频分类等技术方向。
- 配套丰富的文档和教程,更有直播课程和用户交流群,可以与百度资深研发工程师一起讨论交流。
一、十大视频场景化应用-工具详解
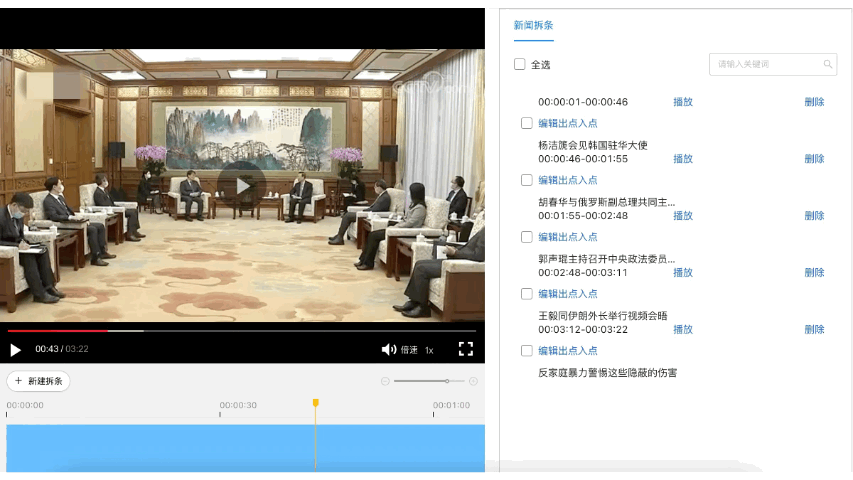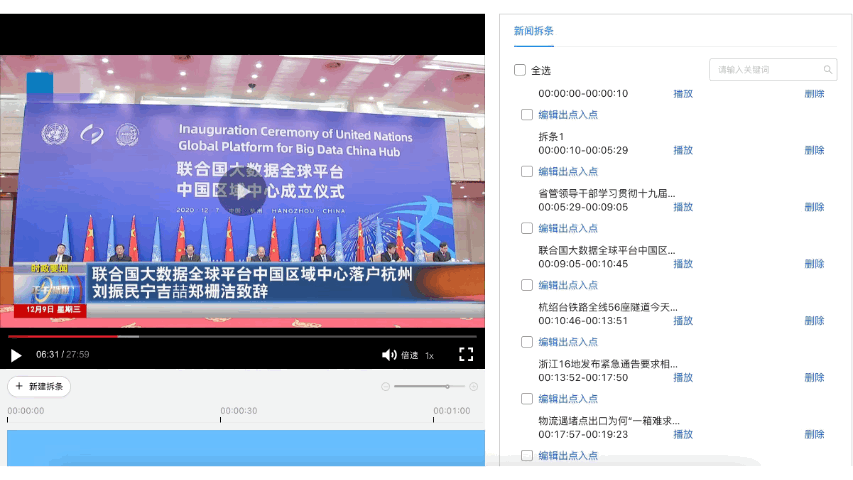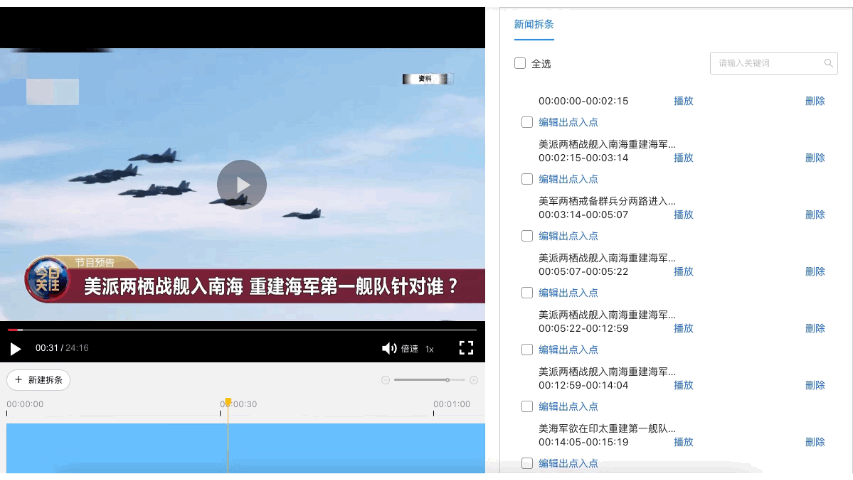
飞桨PaddleVideo基于体育行业中足球/篮球/乒乓球/花样滑冰等场景,开源出一套通用的体育类动作识别框架;针对互联网和媒体场景开源了基于知识增强的大规模多模态分类打标签、智能剪辑和视频拆条等解决方案;针对安全、教育、医疗等场景开源了多种检测识别案例。百度智能云结合飞桨深度学习技术也形成了一系列深度打磨的产业级多场景动作识别、视频智能分析和生产以及医疗分析等解决方案。
1. 足球场景:
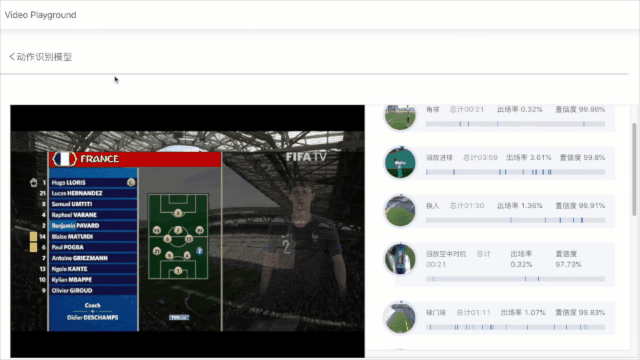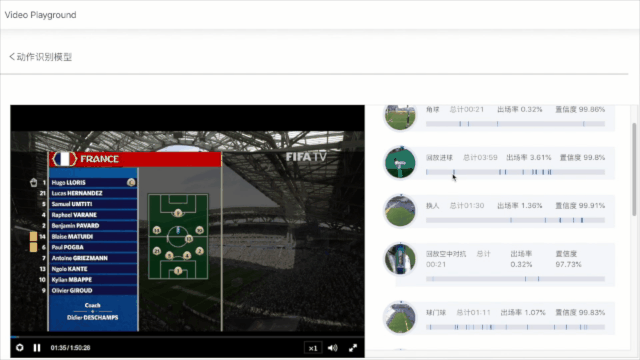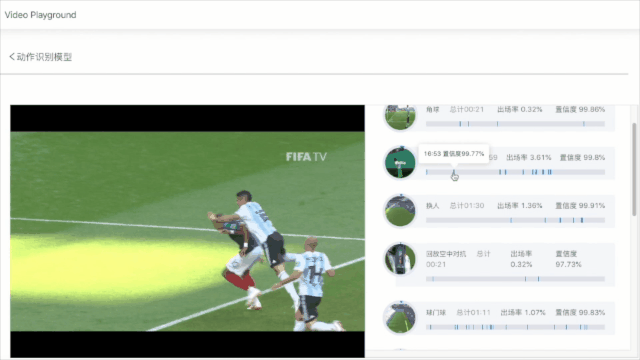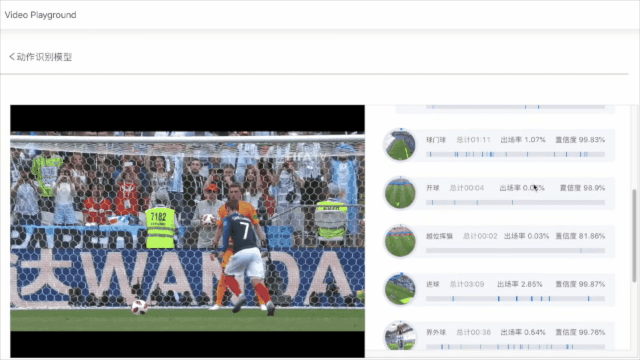
开源FootballAction精彩片段智能剪辑解决方案
FootballAction基于行为识别PP-TSM模型、视频动作定位BMN模型和序列模型AttentionLSTM组合得到,不仅能准确识别出动作的类型,而且能精确定位出该动作发生的起止时间。目前能识别的动作类别有8个,包含:背景、进球、角球、任意球、黄牌、红牌、换人、界外球。准确率超过90%。
2. 篮球场景:
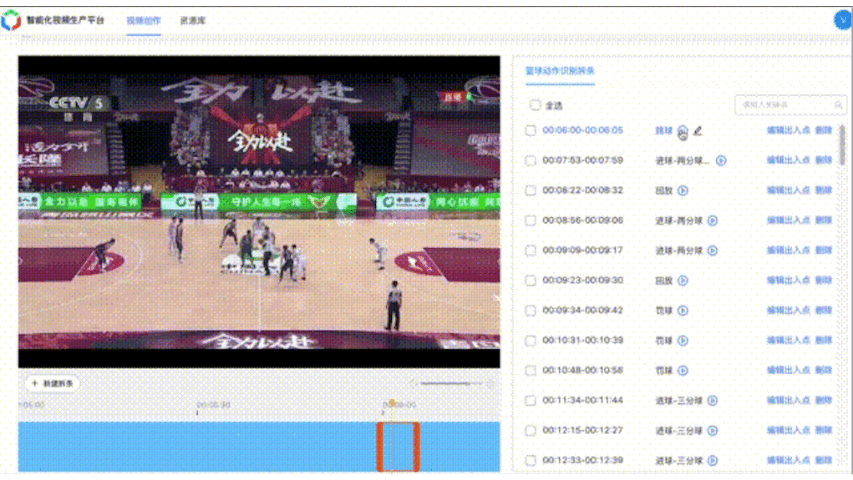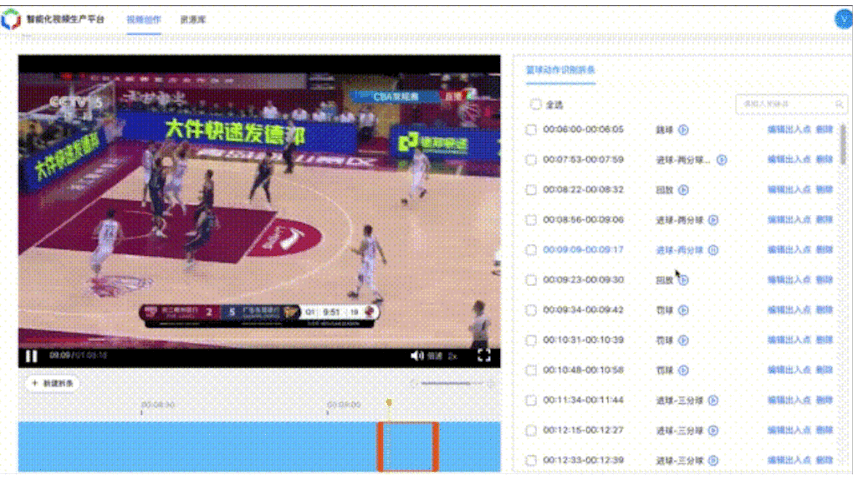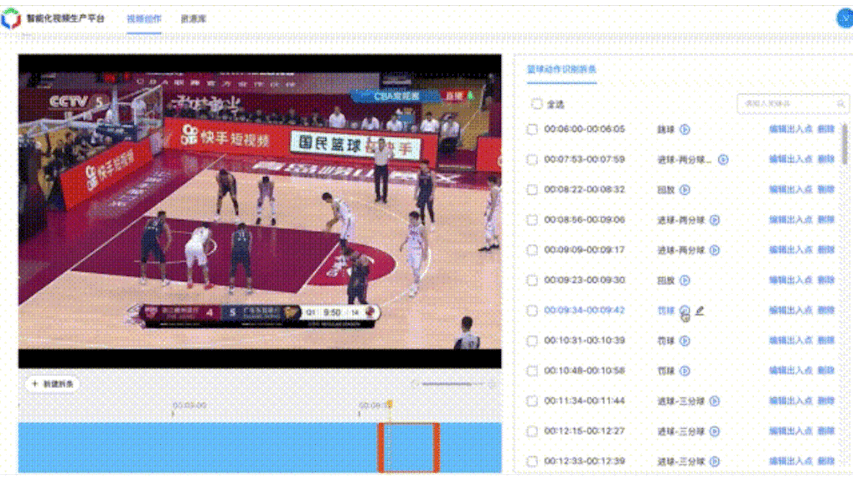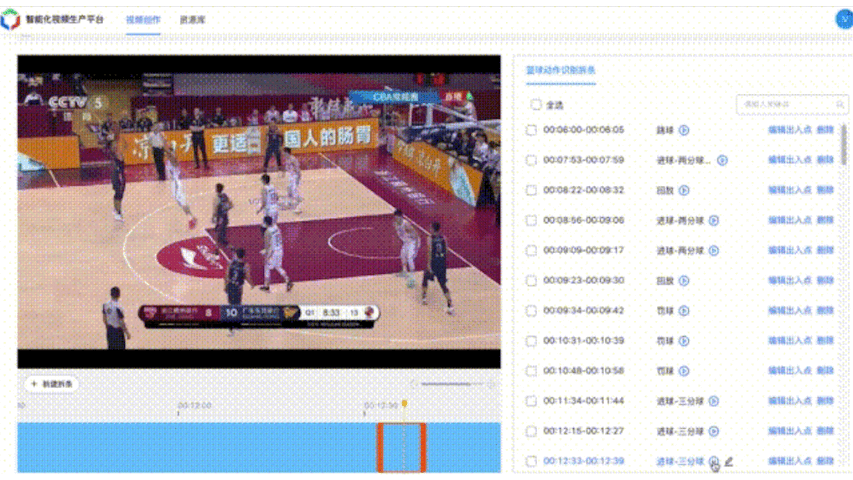
开源BasketballAction精彩片段智能剪辑解决方案
篮球案例BasketballAction整体框架与FootballAction类似,共包含7个动作类别,分别为:背景、进球-三分球、进球-两分球、进球-扣篮、罚球、跳球。准确率超过90%。
3. 乒乓球场景:
开源大规模数据训练的动作分类模型
在百度Create 2021(百度AI开发者大会)上,PaddleVideo联合北京大学一同发布的乒乓球动作进行识别模型,基于超过500G的比赛视频构建了标准的训练数据集,标签涵盖发球、拉、摆短等8个大类动作。其中起止回合准确率达到了97%以上,动作识别也达到了80%以上。

4. 花样滑冰动作识别
使用姿态估计算法提取关节点数据,最后将关节点数据输入时空图卷积网络ST-GCN模型中进行动作分类,可以实现30种动作的分类。飞桨联合CCF(中国计算机学会)举办了花样滑冰动作识别大赛,吸引了300家高校与200家企业超过3800人参赛,冠军方案比基线方案精度提升了12个点,比赛top3方案已经开源。
| <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img img_loading __bg_gif" data-ratio="0.6818181818181818" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6r9NoGCS34WwxtxJk3lSLpL0yTWzE1BTydrDYibSGZMdd0onZQ9XG22Q/640?wx_fmt=gif" data-type="gif" data-w="352" style="white-space: normal; width: 252px !important; height: 172.667px !important;" _width="268px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/25dde51c3b8645e2908578423e5899cb~tplv-k3u1fbpfcp-zoom-1.image" data-order="3" alt="图片"></section> | <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img img_loading __bg_gif" data-ratio="0.6818181818181818" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6xTHuFR2gOeyaOkmTdiayoyy4TibyoKicwAenEO0U0iaDXAIBfzdbDeJgdg/640?wx_fmt=gif" data-type="gif" data-w="352" style="font-family: mp-quote, -apple-system-font, BlinkMacSystemFont, "Helvetica Neue", "PingFang SC", "Hiragino Sans GB", "Microsoft YaHei UI", "Microsoft YaHei", Arial, sans-serif; white-space: normal; text-align: center; width: 252px !important; height: 172.667px !important;" _width="268px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/fcd066d6da8b4f06b1422921cf9f6876~tplv-k3u1fbpfcp-zoom-1.image" data-order="4" alt="图片"></section> |
| <section style="text-align: center;line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><span style="display: none;line-height: 0px;letter-spacing: 1px;"></span><img class="rich_pages wxw-img img_loading __bg_gif" data-backh="147" data-backw="262" data-ratio="0.5625" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6JBmFRbukrIPGGb2eN6d4S6ECZ31bzDL2v38aVLGuLTwpfFP4aibUz1Q/640?wx_fmt=gif" data-type="gif" data-w="640" style="width: 252px !important; height: 142.917px !important;" _width="100%" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/a20742f3cea84ac08d2c920c5f31122b~tplv-k3u1fbpfcp-zoom-1.image" data-order="5" alt="图片"><span style="display: none;line-height: 0px;letter-spacing: 1px;"></span></section> | <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img img_loading __bg_gif" data-backh="150" data-backw="267" data-ratio="0.5627198124267292" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6iaxtjm7ialEqplticW399heoX3EpSyWyiaSmB3xUhqDNibNz9noAD1hfQtw/640?wx_fmt=gif" data-type="gif" data-w="853" style="font-family: mp-quote, -apple-system-font, BlinkMacSystemFont, "Helvetica Neue", "PingFang SC", "Hiragino Sans GB", "Microsoft YaHei UI", "Microsoft YaHei", Arial, sans-serif; white-space: normal; text-align: center; width: 252px !important; height: 142.971px !important;" _width="100%" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/fa466c5cae9b4b639ccdb7668d3a55d2~tplv-k3u1fbpfcp-zoom-1.image" data-order="6" alt="图片"></section> |
 7. 视频交互式标注工具开源
-------------------
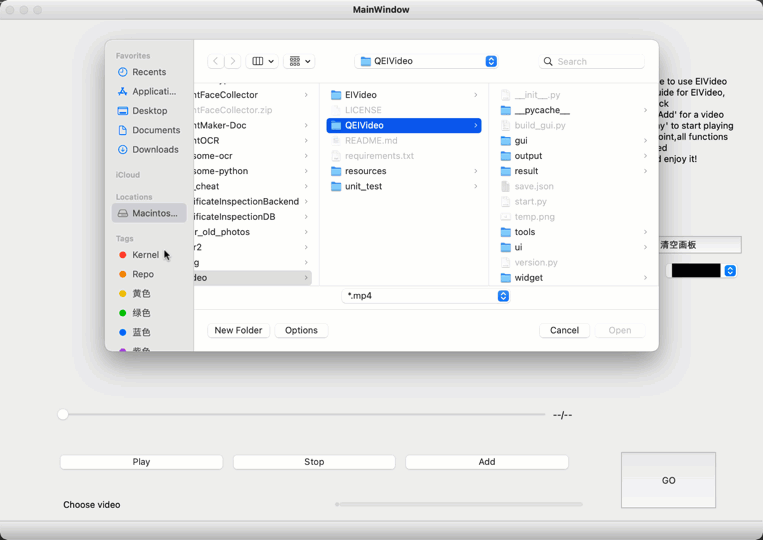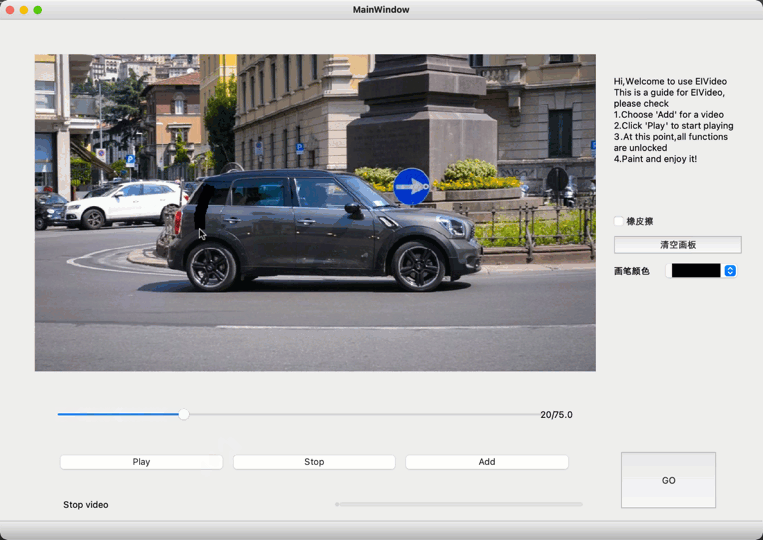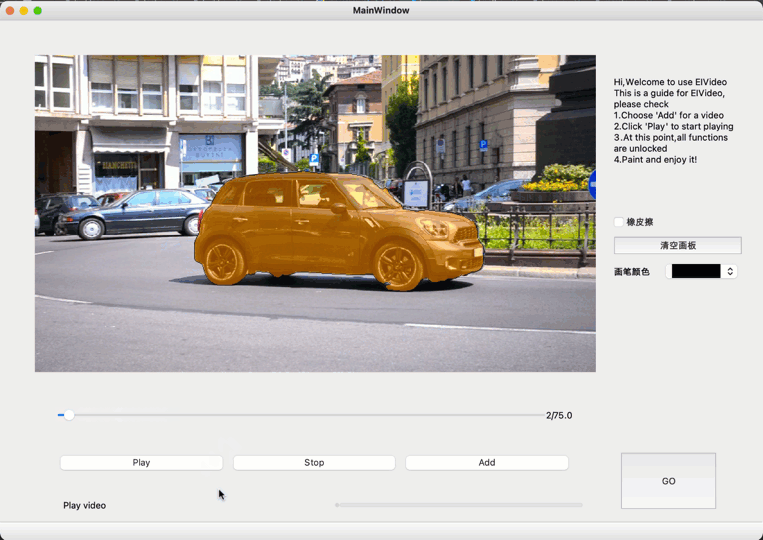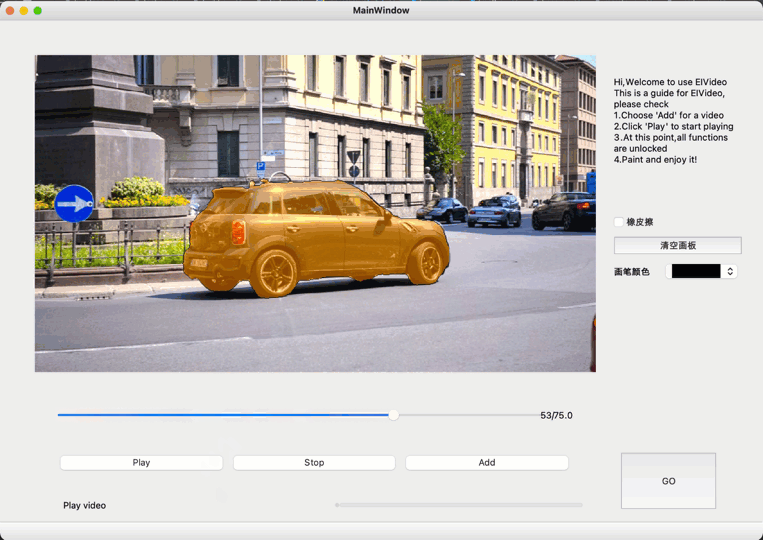
飞桨开源了基于MA-Net的交互式视频分割(interactive VOS)工具,提供少量的人工监督信号来实现较好的分割结果,可以仅靠标注简单几帧完成全视频标注,之后可通过多次和视频交互而不断提升视频分割质量,直至对分割质量满意。
 8. 基于时空动作检测单模型实现87类通用行为识别
-----------------------------
飞桨基于时空动作检测模型实现了识别多种人类行为的方案,利用视频多帧时序信息解决传统检测单帧效果差的问题,从数据处理、模型训练、模型测试到模型推理,可以实现AVA数据集中80个动作和自研的7个异常行为(挥棍、打架、踢东西、追逐、争吵、快速奔跑、摔倒)的识别。模型的效果远超目标检测方案。
| <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img __bg_gif" data-ratio="1.0186915887850467" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6p5tDibOT1L2Jk1ibLiab4w0jPBeJBB5WZxJw3X4yBVTibx6iba98DYONVZA/640?wx_fmt=gif" data-type="gif" data-w="214" style="white-space: normal; width: 207px !important; height: auto !important; visibility: visible !important;" _width="207px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/898b2089761247539f3bedd98b55aa49~tplv-k3u1fbpfcp-zoom-1.image" data-order="9" alt="图片" data-fail="0"><span style="display: none;line-height: 0px;letter-spacing: 1px;"></span></section> | <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img __bg_gif" data-galleryid="" data-ratio="0.7686567164179104" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6dMwxsdptlH90RN7BZzCbdyuwwJB9xfVzwSjrZWybPYiaHAXVYNbyWGA/640?wx_fmt=gif" data-type="gif" data-w="536" style="font-family: mp-quote, -apple-system-font, BlinkMacSystemFont, "Helvetica Neue", "PingFang SC", "Hiragino Sans GB", "Microsoft YaHei UI", "Microsoft YaHei", Arial, sans-serif; white-space: normal; text-align: center; width: 268px !important; height: auto !important; visibility: visible !important;" _width="268px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/510f01b52b5d46b2aedae5debbe85eee~tplv-k3u1fbpfcp-zoom-1.image" data-order="10" alt="图片" data-fail="0"></section> |
| <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img img_loading __bg_gif" data-ratio="0.8" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6uVaicongxDosZR9AqFcE4tG3u80fibIvvGMHLE9XlibaH3zPV1m261iasQ/640?wx_fmt=gif" data-type="gif" data-w="640" style="white-space: normal; width: 252px !important; height: 202.133px !important;" _width="268px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/abb864ca0fd84ca7a6d7b89ab3cba3d7~tplv-k3u1fbpfcp-zoom-1.image" data-order="11" alt="图片"></section> | <section style="line-height: 1.75em;margin-left: 8px;margin-right: 8px;"><img class="rich_pages wxw-img img_loading __bg_gif" data-ratio="0.8" data-s="300,640" data-src="https://mmbiz.qpic.cn/mmbiz_gif/sKia1FKFiafgiaX1R7zzZ8VEK4KUr1d1wu6Hfd8SpFpyYBwtmjeEL5lYw79v7TIXjQsu87gXiagn736vjFEwaibLrqQ/640?wx_fmt=gif" data-type="gif" data-w="640" style="font-family: mp-quote, -apple-system-font, BlinkMacSystemFont, "Helvetica Neue", "PingFang SC", "Hiragino Sans GB", "Microsoft YaHei UI", "Microsoft YaHei", Arial, sans-serif; white-space: normal; text-align: center; width: 252px !important; height: 202.133px !important;" _width="268px" src="https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/14611978c5044f379294b27a3b173879~tplv-k3u1fbpfcp-zoom-1.image" data-order="12" alt="图片"></section> |
 # 二、五大冠军、顶会算法开源
百度研究院首次开源自研冠军、顶会算法
1. CVPR 2020 顶会论文:
-----------------------
多模态预训练模型ActBERT首次开源
-----------------------
ActBERT是融合了视频、图像和文本的多模态预训练模型,它使用一种全新的纠缠编码模块从三个来源进行多模态特征学习,以增强两个视觉输入和语言之间的互动功能。该纠缠编码模块,在全局动作信息的指导下,对语言模型注入了视觉信息,并将语言信息整合到视觉模型中。纠缠编码器动态选择合适的上下文以促进目标预测。简单来说,纠缠编码器利用动作信息催化局部区域与文字的相互关联。在文本视频检索、视频描述、视频问答等5个下游任务上,ActBERT均明显优于其他方法。下表展示了ActBERT模型在文本视频检索数据集MSR-VTT上的性能表现。
 2. CVPR 2021 顶会论文:
--------------------------
文本视频检索模型T2VLAD首次开源
----------------------
随着各种互联网视频尤其是短视频的火热,文本视频检索在近段时间获得了学术界和工业界的广泛关注。特别是在引入多模态视频信息后,如何精细化地配准局部视频特征和自然语言特征成为一大难点。T2VLAD采用一种高效的全局-局部的对齐方法,自动学习文本和视频信息共享的语义中心,并对聚类后的局部特征做对应匹配,避免了复杂的计算,同时赋予了模型精细化理解语言和视频局部信息的能力。
此外,T2VLAD直接将多模态的视频信息(声音、动作、场景、speech、OCR、人脸等)映射到同一空间,利用同一组语义中心来做聚类融合,计算同一中心的视频和文本特征的局部相似度,这在一定程度上解决了多模态信息难以综合利用的问题。T2VLAD在三个标准的Text-Video Retrieval Dataset上均取得了优异的性能。
 3. CVPR2020视频分割模型MA-Net首次开源
-------------------------------
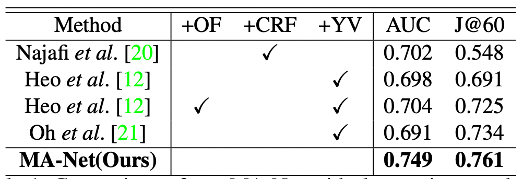
视频目标分割(VOS)是计算机视觉领域的一个基础任务,有很多重要的应用场景,如视频编辑、场景理解及自动驾驶等。交互式视频目标分割由用户在视频的某一帧中给目标物体简单的标注(比如在目标物体上画几条简单的线),就能够通过算法获得整个视频中该目标物体的分割结果,用户可以通过多次和视频交互而不断提升视频分割质量,直到用户对分割质量满意。
由于交互式视频分割需要用户多次和视频交互,因此,需要兼顾算法的时效性和准确性。MA-Net 使用一个统一的框架进行交互和传播来生成分割结果,保证了算法的时效性。另外, MA-Net 通过记忆存储的方式,将用户多轮交互的信息存储并更新,提升了视频分割的准确性。下表展示了模型在DAVIS2017数据集上性能表现。
 4. 首次开源ECCV 2020 Spotlight视频分割模型CFBI、CVPR2021视频目标分割国际竞赛中,基于 CFBI设计的解决方案在两项任务上夺得了冠军
--------------------------------------------------------------------------------------
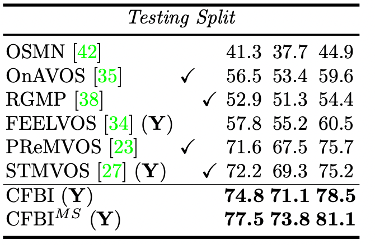
在视频目标分割领域中,半监督领域在今年来备受关注。给定视频中第一帧或多个参考帧中的目标标定,半监督方法需要精确跟踪并分割出目标物体在整个视频中的掩模。以往的视频目标分割方法都专注于提取给定的前景目标的鲁棒特征,但这在遮挡、尺度变化以及背景中存在相似物体的等等复杂场景下是十分困难的。基于此,我们重新思考了背景特征的重要性,并提出了前背景整合式的视频目标分割方法(CFBI)。
CFBI以对偶的形式同时提取目标的前景与背景特征,并通过隐式学习的方法提升前背景特征之间的对比度,以提高分割精度。基于CFBI,我们进一步将多尺度匹配和空洞匹配的策略引入视频目标中,并设计了更为鲁棒且高效的框架,CFBI+。
CFBI系列方法在视频目标分割领域上保持着单模型最高精度的记录。特别地,百度研究院的单模型性能优于旷视清华团队在CVPR2020视频目标分割国际竞赛上融合三个强力模型的结果。在今年刚刚结束的CVPR2021视频目标分割国际竞赛中,基于 CFBI设计的解决方案在两项任务上夺得了冠军。下表展示了CFBI模型在DAVIS-2017数据集上的表现。
 5. ICCV 2021无监督单目深度估计模型ADDS首次开源
-----------------------------------
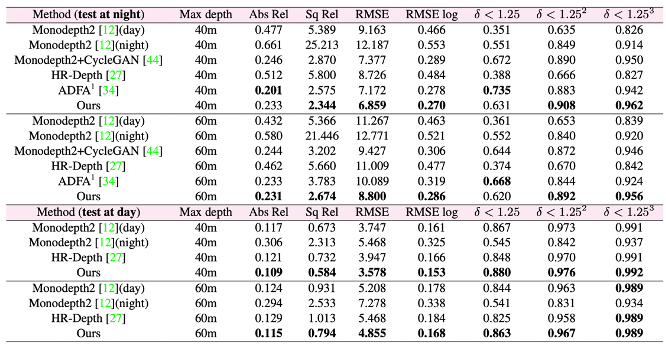
ADDS是基于白天和夜晚图像的自监督单目深度估计模型,其利用了白天和夜晚的图像数据互补性质,减缓了昼夜图像较大的域偏移以及照明变化对深度估计的精度带来的影响,在具有挑战性的牛津RobotCar数据集上实现了全天图像的最先进的深度估计结果。下表展示了ADDS模型在白天和夜间数据集上的测试性能表现。
 是不是干货满满,心动不如行动,大家可以直接前往Github地址获得完整开源项目代码,记得Star收藏支持一下哦:
https://github.com/PaddlePadd...
---------- END ----------
百度 Geek 说
百度官方技术公众号上线啦!
技术干货 · 行业资讯 · 线上沙龙 · 行业大会
招聘信息 · 内推信息 · 技术书籍 · 百度周边
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论