字节面试
文章目录
1. 字节一面
基本面试
- 下面两句话的区别
select * from t where b = xxx;select id from t where b = xxx;
- 我提到主键索引树和非主键索引树。第一句需要先在非主键索引树上找,再去主键索引树上找,需要进行回表操作;第二句只需要查找一次非主键索引树就可以。
2.表t含有name、city、age、id四个字段,执行语句select * from t where city = xxx and age > 50;,如何设置索引?
- 提到使用联合索引,(city, age)的方式,先查找city再查找age
3.公司发钱,财务给小王发5000,事务但是没有提交,此时小王看到了很高兴;财务发现发错了,应该发2000,就回滚了事务,小王看到只有2000,很伤心。是什么事务隔离级别导致的?如何解决?
- 这个说的时候把读提交和读未提交搞混了。
- 读提交是事务提交之后变更才能被其他人看到;读未提交是事务提交之前变更就能被看到。
- 我说可以改成读提交的方式来解决
4.问到隔离级别
- 读提交
- 读未提交
- 可重复读
- 串行话
然后追问为什么需要可重复读?
- 可重复读是指一个事务执行过程中看到的数据总是与事务启动时看到的数据相一致
- 因为该事务执行过程中,可能有其他的事务也在执行
5.问到502/503/504错误码
我说5xx开头的表示服务端错误,他就问服务端错误如何检测?
- 说到502表示网关错误,我就说可以检查看服务器网络、网线啥的
503、504不太清楚他也没问了
- 503表示服务器尚未处于可以接受请求的状态。 通常造成这种情况的原因是由于服务器停机维护或者已超载。
- 504错误代表网关超时(Gateway timeout),是指服务器作为网关或代理,但是没有及时从上游服务器收到请求
6.他说到504是time out,问我超时和错误的区别?比方上游服务调用下游服务超时和error有什么不同?
- 我说error表示是下游服务出现了问题,需要修改下游服务;如果超时需要先定位是调用超时还是下游服务超时
7.问到HTTPs协议,问到TLS需要几次RTT完成?
- RTT是往返的时候也就是两次,我记错了。说到4次挥手,8次RTT。。。。实际上应该是2次RTT
HTTPs协议中TLS握手的过程(四次握手)
- 客户端发送hello消息给服务端
- 服务端回应消息,附带证书
- 客户端验证证书,取出公钥,加密随机key
- 服务端用私钥解密key,即为确定传输的密钥。
8.分布式id生成器的实现,保证id非严格递增即可,如何实现?
- 我提到要用redis进行id的存储;很多数据采用集群或者mongoDB
- 提到int64位,用时间戳保证key的唯一。比如固定时间,用当前时间-固定时间,以确保id从小开始
- 用序列号,redis的hash,存储key、序列号、最大可用的序列号
算法
- 我提到用暴力DFS
暴力1
- 只适用于n不大的情况
- 需要枚举所有可能性,时间复杂度o(2^2n * n)
- 空间复杂度为o(n),最多递归n次
class Solution {
public:
    vector<string> res;
    vector<string> generateParenthesis(int n) {
        dfs("", n, 0, 0);
        return res;
    }

    void dfs(string path, int n, int lc, int rc) {
        if (rc > n || lc > n || rc > lc) {
            return;
        }
        if (lc == n && lc == rc) {
            res.push_back(path);
            return;
        }
        dfs(path + "(", n, lc + 1, rc);
        dfs(path + ")", n, lc, rc + 1);
    }
};
暴力法2
- 时间复杂度o(2^2n*n)
- 空间复杂度o(n)
- lc和rc分别表示剩余的括号的数量,如果lc>0,表示可以添加"(",如果rc>lc,可以添加")"
class Solution {
public:
    vector<string> res;
    vector<string> generateParenthesis(int n) {
        dfs("", n, n, n);
        return res;
    }

    void dfs(string cur, int lc, int rc, int n) {
        if (cur.size() == 2*n) {
            res.push_back(cur);
            return;
        }
        if (lc > 0) { //剩余的左括号的数量
            dfs(cur + "(", lc-1, rc, n);
        }
        if (rc > lc) {//右括号大于左括号,可以选择右括号
            dfs(cur + ")", lc, rc-1, n);
        }
    }
};
动态规划
- 可以从所有 n-1 的括号排列中,推出 n 的括号排列
- 从n-1到n,增加了一组括号。剩余n-1组括号要么在新增括号内部,要么在新增括号外部
- 比方 n = 8,可以从所有 i < 8 的方式推出。比方选择i=3和i=4的方式
class Solution {
public:
    vector<string> generateParenthesis(int n) {
        if (n == 0) {
            return {""};
        }
        if (n == 1) {
            return "()";
        }
        vector<vector<string>> dp(n+1);
        dp[0] = "";
        dp[1] = "()"
        for (int i = 2; i <= n; i++) {
            for (int j = 0; j < i; j++) {
                for (string p : dp[j]) {
                    for (string q : dp[i-j-1]) {
                        string cur = "(" + p + ")" + q;
                        dp[i].push_back(cur);
                    }
                }
            }
        }
        return dp[n];
    }
};
2. 字节二面
基本面试
算法
- 单链表,奇数位升序,偶数位降序,在o(1)的空间复杂度, o(n)的时间复杂度将链表改成升序排列的
输入: 1->200->10->120->30->8->88->4
输出: 1->4->8->10->30->88->120->200
思路
- 单链表划分成两个链表,对降序排列的链表反转,然后两个链表合并
- 注意链表合并的方法
#include <iostream>
#include <vector>
using namespace std;
struct ListNode {
    int val;
 ListNode *next;
 ListNode(): val(0), next(nullptr) {}
    ListNode(int x) : val(x), next(nullptr) {}
};
ListNode* reverse(ListNode *head);
ListNode* combine(ListNode* head1, ListNode *head2);
ListNode *getResult(ListNode *head) {
    if (head == NULL || head->next == NULL) {
        return head;
 }
    ListNode *head1 = NULL, *head2 = NULL;
 ListNode *cur1 = NULL, *cur2 = NULL;
 int cnt = 1;
 while (head != NULL) {
        if (cnt % 2 == 1) { //奇数
 if (cur1 != NULL) {
                cur1->next = head;
 cur1 = cur1->next;
 } else {
                cur1 = head;
 head1 = cur1;
 }
        } else {
            if (cur2 != NULL) {
                cur2->next = head;
 cur2 = cur2->next;
 } else {
                cur2 = head;
 head2 = cur2;
 }
        }
        cnt++;
 head = head->next;
 }
    cur1->next = NULL;
 cur2->next = NULL;
 head2 = reverse(head2);
 ListNode *newHead = combine(head1, head2);
 return newHead;
}
ListNode* combine(ListNode* head1, ListNode *head2) {
    if (head1 == NULL || head2 == NULL) {
        return head1 == NULL ? head2 : head1;
 }
    ListNode *head = new ListNode(-1), *pre = head;
//    if (head1->val < head2->val) {
//        head = head1;
//    } else {
//        head = head2;
//    }
//    ListNode *cur1 = NULL, *cur2 = NULL;
//    cur1 = (head == head1) ? head1 : head2;
//    cur2 = (head == head1) ? head2 : head1;
//
//    ListNode *pre = NULL, *next = NULL;
//    while (cur1 != NULL && cur2 != NULL) {
//        if (cur1->val <= cur2->val) {
//            pre = cur1;
//            cur1 = cur1->next;
//        } else {
//            next = cur2->next;
//            pre->next = cur2;
//            cur2->next = cur1;
//            pre = cur2;
//            cur2 = next;
//        }
//    }
//    pre->next = (cur1 == NULL) ? cur2 : cur1;
 while (head1 && head2) {
        if (head1->val < head2->val) {
            pre->next = head1;
 pre = pre->next;
 head1 = head1->next;
 } else {
            pre->next = head2;
 pre = pre->next;
 head2 = head2->next;
 }
    }
    if (head1) {
        pre->next = head1;
 }
    if (head2) {
        pre->next = head2;
 }
    return head->next;
}
//对降序排列的head2进行reverse
ListNode* reverse(ListNode *head) {
    ListNode *p = head;
 ListNode *pre = nullptr;
 while (p) {
        ListNode *q = p->next;
 p->next = pre;
 pre = p;
 p = q;
 }
    return pre;
}
int main() {
    freopen("data", "r", stdin);
 ListNode *dummy = new ListNode(-1);
 ListNode *p = dummy;
 int tmp;
 while (cin >> tmp) {
        p->next = new ListNode(tmp);
 p = p->next;
 }
    ListNode *head = getResult(dummy->next);
 while (head != nullptr) {
        cout << head->val << "->";
 head = head->next;
 }
    return 0;
}
3. 字节三面
- 你说DNS是防止域名劫持的,https是不是也可以做到?
- https的工作流程
- 加密算法有哪些
- leveldb写入数据的过程
- LSM—Tree简单介绍
- memTable如何实现的数据存储
- http连接,假设平时不常用,然后突然有一个连接来了请求,如何处理?
- select、poll、epoll的优缺点和适用场景
- 惊群效应解释,如何避免
- linux系统下fd是如何进行分配的?分配回收之后该fd会不会被复用?
- 让你实现一个fd的分配如何做?如何保证分配的fd被释放之后,下次先使用这个fd再使用其他的?用什么数据结构实现?用链表如何保证o(1)的查找
- 位图如何实现这个fd的分配
算法
- 实现c语言的memcpy函数
- 不考虑内存重叠
- 考虑内存重叠
- 在不考虑内存重叠时,如何加快拷贝速度?
2.为了统计一天内抖音每秒的在线用户数量,每次一个用户下线时会生成一条记录到文件里:记录里有三个字段(上线时间,下线时间,用户名),时间以秒为单位。现在有一个文件包含了当天生成的N条记录(N很大),请设计一个算法根据N条记录统计出当天每秒在线用户的数量。(0<=上线时间& lt;下线时间<=24*3600)
- 用两个24*3600的数组
- vector<int> change(24*3600); change[i]表示第i秒上线的用户人数,如果该秒用户上线, change[i]++, 否则change[i]--;
- vector<int> online(24*3600); online[i]表示第i秒在线的用户人数,
- `online[i] = online[i-1] + change[i];`
4.字节四面
- 讲一下没有区块链的时候DNS域名解析的过程
- 有哪些共识算法
- raft共识算法的过程
- 什么时候会发生脑裂
- 这个下次记得讲一下脑裂解决方式
1. 逻辑题
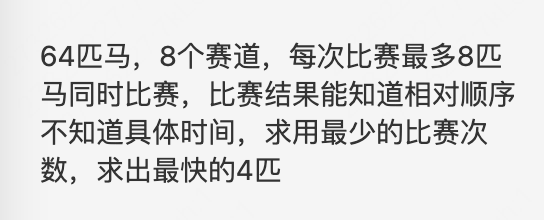
- 分8组每组8匹跑一次,剔除掉每组最后4匹。还剩32匹
- 每组第一名跑一次,淘汰后四名的所有马。还剩16匹,得出第一名
- 第二名不跑,剩下8匹跑,如果A3是第一,则出现前四
2. 算法--滑动窗口+双指针+set
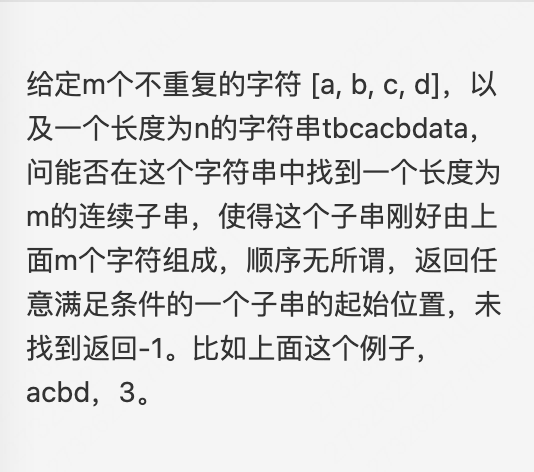
- 滑动窗口window,存放left和right之间的元素
- 用set存放原m个不重复字符
- 时间复杂度o(n)
int getIndex(vector<int> &res, string &s, int m, int n) {
    int left = 0, right = 0;
    unordered_set<int> us(res.begin(), res.end());
    unordered_set<int> window;
    while (right < n) {
        if (us.count(s[right]) { //如果包含该元素
            window.insert(s[right]);
            um[s[right]]++;
            while (left < right && um[s[right]] > 1) {
                um[s[left]]--;
                window.erase(s[left]);
                left--;
            }
            right++;
            if (right - left == m) {
                return left;
            }
        } else { //不包含,更新left和right
            right++;
            left = right;
            um.clear();
            window.clear();
        }
    }
    return -1;
}
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论