Bloom Filter
文章目录
1. 概念
为了减少遍历集合中的数据来确定查找的数据在不在该集合中,可以采用布隆过滤器来优化。布隆过滤器是一个概率数据结构,它无法给出要找的数据的位置,只能给出要找的数据是否在里面,并且给出的结果可能会假阳性(false positives),即告诉查找的数据在该集合里面,实际数据不在里面。
布隆过滤器是由一个很长的bit数组和一系列哈希函数组成的。数组的每个元素都只占1bit空间,并且每个元素只能为0或1。布隆过滤器拥有K个哈希函数,当一个元素要加入布隆过滤器时,会使用K个哈希函数对其进行K次计算,得到K个哈希值,并且根据得到的哈希值,在一维数组中把对应下标的值置位1。
判断某个数是否在布隆过滤器中,就对该元素进行K次哈希计算,得到的值在位数组中判断每个元素是否都为1,如果每个元素都为1,就说明这个值可能在布隆过滤器中,需要进一步确认。注:Bloom filter只能插入与查找,不能删除。
🌰:一个8-bit bloom filter,插入RZA,通过两个hash函数找到两个bit位,如果该bit位是0,则将其变为1;如果已经是1,则该bit位不变。再插入GZA。
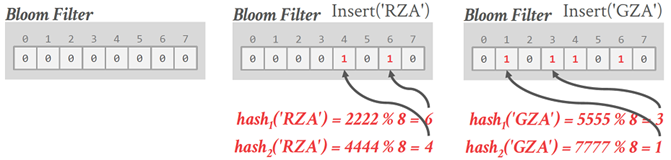
🌰:查找Raekwon,两个hash得到的bit位有一个0,则表示Raekwon不存在表中。查找ODB,两个hash到的bit为都是1,则表示ODB在表中,但实际不存在(即假阳性),这其实并不影响,最多到hash表中再查一下。
2. 误报率
哈希函数越多,那么一个Key就可以用数组中的多个位置来标记,整体冲突的概率越低。但是在这个数组中的各个Bit位,同时也会被其他数据标记位来影响。如果Hash数量给的过多,那么每个Key都会有多个Bit位来标记它是否存在。极端情况下,过多的Hash数量,可能导致整个数组中大量的 bit位被置为1。那么在这种情况下,误报率就会越高。
同时,如果在hash个数确定的情况下,数组长度越长,数据量越小也越稀疏。
假设Hash函数以等概率条件选择并设置Bit Array中的某一位,m是该位数组的大小(即m个Bit位),k是Hash函数的个数,那么位数组中某一特定的位在进行元素插入时的Hash操作中没有被置位为"1"的概率是:\( 1-1/m \)。在所有k次 Hash操作后,该位仍没有被置"1"的概率是:\( (1-1/m)^k \)。如果插入了n个元素,那么某一位仍没有被置"1"的概率是:\( (1-1/m)^{kn} \),因而该位为"1"的概率是:\( 1-(1-1/m)^{kn} \)。现在检测某一元素是否在该集合中,标明某个元素是否在集合中所需的k个位置都按照如上的方法设置为"1",但是该方法可能会使算法错误的认为某一原本不在集合中的元素却被检测为在该集合中(False Positives),该概率由以下公式确定:\( [1-(1-1/m)^{kn}]^k\approx (1-e^{-kn/m})^k \)。
随着m(位数组大小)的增加,假阳性的概率会下降,同时随着插入元素个数n的增加,假阳性的的概率又会上升。
对于给定的m和n,Hash函数个数k可以由下推出:令\( a=n/m \),对\( (1-e^{-kn/m})^k \)求导:
$$ \begin{aligned}y &=\left(1-e^{-a x}\right)^{x} \\\ln y &=x \ln \left(1-e^{-a x}\right)\end{aligned} $$
$$ \begin{array}{c}\frac{1}{y} y^{\prime}=\ln \left(1-e^{-a x}\right)+x \frac{a e^{-a x}}{1-e^{-a x}} \\y^{\prime}=\left[\ln \left(1-e^{-a x}\right)+x \frac{a e^{-a x}}{1-e^{-a x}}\right]\left(1-e^{-a x}\right)^{x}\end{array} $$
而\( (1-e^{-ax})^x >0\),因此:
$$ \begin{array}{l}\ln \left(1-e^{-a x}\right)+x \frac{a e^{-a x}}{1-e^{-a x}}=0 \\\ln \left(1-e^{-a x}\right)=-a x \frac{e^{-a x}}{1-e^{-a x}}\end{array} $$
令\( u=1-e^{-ax} \),可得:
$$ \begin{aligned}\ln u &=\frac{1-u}{u} \ln (1-u) \\u^{u} &=(1-u)^{(1-u)}\end{aligned} $$
所以,\(u=1/2\)时,找到最低的误报率,此时哈希函数个数\(k=ln2/a=mln2/n\)。
对于给定的False Positives概率p,最优的位数组大小m为:\(m=-nlnp/(ln2)^2\)。
3. 实现
在给定集合中可存的数据的个数n与假阳性率fp的情况下,返回m/n,注:\(ln2\approx0.69314718056\)
func BloomBitsPerKey(numEntries int, fp float64) int {
    // 传入参数numEntries是bloom中存储的数据个数,fp是false positive假阳性率
    size := -1 * float64(numEntries) * math.Log(fp) / math.Pow(float64(0.69314718056), 2)
    locs := math.Ceil(size / float64(numEntries))
    return int(locs)
}
设计的布隆过滤器中,使用[]byte进行存储,并使用最后一个byte保存哈希函数个数。而为了节省内存,一个位置使用一个bit位就可以,没必要使用byte来表示。所以可将剩下的[]byte看成一个二维的bit数组。🌰:哈希值对m取模后得到12,12/8=1,12%8=4,可以知道在第1行的第4列。
为集合添加布隆过滤器:
func appendFilter(keys []uint32, bitsPerKey int) []byte {
    // 将多个Key值放入到bloom过滤器中
    if bitsPerKey < 0 {
        bitsPerKey = 0
    }
    k := uint32(float64(bitsPerKey) * 0.69) // k = mln2/n
    if k < 1 {
        k = 1
    }
    if k > 30 {
        k = 30
    } // 给哈希函数个数设置上下限

    nBits := len(keys) * int(bitsPerKey)
    if nBits < 64 {
        nBits = 64
    } // 确定 m
    nBytes := (nBits + 7) / 8 // +7是防止nBits小于8
    nBits = nBytes * 8
    filter := make([]byte, nBytes+1) // 留下1byte(8bit)记录哈希函数个数

    for _, h := range keys {
        delta := h>>17 | h<<15           // 简易hash函数
        for j := uint32(0); j < k; j++ { // 进行k个哈希函数
            bitPos := h % uint32(nBits)           // 确定列
            filter[bitPos/8] |= 1 << (bitPos % 8) // 确定行后设置该位为1
            h += delta                            // 简易hash函数
        }
    }
    filter[nBytes] = uint8(k) // 留下1byte(8bit)记录哈希函数个数
    return filter
}
func NewFilter(keys []uint32, bitsPerKey int) Filter {
    return Filter(appendFilter(keys, bitsPerKey))
}
在布隆过滤器中查找元素是否在集合中:
func (f Filter) MayContain(h uint32) bool {
    //判断一个数据是否在bloom过滤器中
    //经过K个Hash函数计算,判读对应位置是否被标记为1
    if len(f) < 2 {     // 因为1byte存储哈希函数个数,小于2说明过滤器不存在
        return false
    }
    k := f[len(f)-1]    // 获取哈希函数个数
    if k > 30 {         // 假设超出这个上限,整个过滤器中位数全为1
        return true
    }
    nBits := uint32(8 * (len(f) - 1))   // 获取过滤器中位数个数 m
    delta := h>>17 | h<<15              // 简易的hash函数
    for j := uint8(0); j < k; j++ {
        bitPos := h % nBits             // 查找所在位置
        if f[bitPos/8]&(1<<(bitPos%8)) == 0 {  //转换为行和列后,通过&比较是否为1,
            return false
        }
        h += delta                      // 简易的hash函数
    }
    return true
}
func (f Filter) MayContainKey(k []byte) bool {
    return f.MayContain(Hash(k))
}
type Filter []byte
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论