numpy 官网文章翻译
文章目录
什么是 numpy
numpy 是 Python 的一个科学计算包。提供了多种array对象、衍生对象(masked arrays 和 matrices)、及其对其日常快速操作,包括数学、逻辑、形状操作、分类、选择、I/O、离散傅里叶(discrete Fourier transforms)、基本线性代数、基本数据操作、随机墨迹等。
numpy 包的核心是ndarray,他分装了n-维 array 对象(每个维度的数据类型一致),这使得各种操作都在编译好的代码中执行,从而提高了性能。
NumPyarray对象 与 Python 标准序列区别:
- NumPy 对象在创建时有一个固定的大小,而 Python 的 list 没有。改变 ndarray 的大小会删除原来对象,创建一个新的对象
- NumPy所有数据类型是一致的,这样在内存中占用的大小才是一致的。例外:可以有对象数组(Python,包括 NumPy),允许不同大小元素的数组。
- NumPy 对象更容易对于大量数据进行高级数学和其他类型操作。相较于 Python 内置序列,NumPy 操作执行效率更高,代码更少。
- 越来越多的科学和数学 Python 包会使用 NumPy 包,尽管它们支持 Python 内置序列,但在操作之前都会转换成 NumPy 对象。换言之,要想有效的使用现在的科学\数学 Python 包,只了解 Python 内置序列是不够的,我们也要了解 NumPy 对象的使用。
科学计算的关键就是序列大小和速度。举个简单例子,在一个一维的序列中,每个元素要与另一个长度相同的序列相应的元素做乘积,我们可以迭代每个元素。
c = []
for i in range(len(a)):
    c.append(a[i]*b[i])
这个过程会输出正确答案,但如果列表 a 和 b 每个元素都是几百万,那我们就会为 Python 低效的循环付出代价。c 语言可以更快的完成相同任务(我们假设不去做变量声明、初始化和内存分配):
for(i = 0; i < rows; i++):{
    c[i] = a[i]*b[i]
}
这解决了解释Python代码和操作Python对象所涉及的所有开销,但牺牲了Python编码的好处。此外,随着数据维度增加,工作量也增加,如在 2 维数组中,c 语言编码为
for (i = 0; i < rows; i++): {
  for (j = 0; j < columns; j++): {
    c[i][j] = a[i][j]*b[i][j];
  }
}
而 NumPy 为这两张方案这个为我们提供了最优解:当涉及到 ndarray 时,逐个元素操作是默认模式,而实际上是由 提前变异的C语言快速执行。NumPy 代码运行速度与 C 语言接近,同时基于 Python 代码也很简洁(比 Python 还简介简洁!)。最后一个例子说明了 NumPy 的两个优势:矢量化(vectorization)和广播(broadcasting)。c = a*b
矢量化
矢量化意味着代码中没有肉眼可见的循环和索引,而他们其实发生了,只不过优化后“秘密的进行着”——由预编译的 C 语言运行。
矢量化优点
- 矢量化代码更简洁易读
- 代码越少,bug 越少
- 代码更类似于标准的数学符号(这样修改代码的数学结构会更容易)
- 向量化会有更多“Pythonic”代码,没有矢量化,代码就会充斥着低效和难以读取的循环。
广播
广播是一个术语,用于描述操作的隐式逐个元素的行为。通常说来,在 NumPy中,包括算数、逻辑、按位、函数等所有操作,以这种隐式逐个元素的方式进行——即广播。此外,上述举例中,a 和 b 可以是形状相同的多维数组、标量、数组,甚至可以是不同形状的两个数组(前提是较小的数组扩大成较大数组的形状)。更多信息请见 broadcasting。
NumPy 的 ndarray 全面支持面向对象。例如,ndarray是一个类,具有多种方法和对象。其中,许多方法都被NumPy最外层命名空间函数反映,允许程序员在他们喜欢的任何范式中编写代码。这种灵活性使得 NumPy 数组和 NumPyndarray 成为了Python 中多位数据交互的实际语言。
安装
安装 NumPy 唯一需要的条件就是 Python。如果你不懂 Python,只想用最简单的方式的话,我们推荐anaconda,它包括了 Python、NumPy 和许多其他常见科学计算和数据分析的Python 包。
Linux 和 macOS 安装 NumPy 可以使用pip和conda,或者使用下载源。更多信息请参考https://numpy.org/install/#py...。
》
- donda
你可以从defaults或者conda-forge安装 numpy。
 Best practice, use an environment rather than install in the base env
conda create -n my-env
conda activate my-env
# If you want to install from conda-forge
conda config --env --add channels conda-forge
# The actual install command
conda install numpy- pip
pip install numpy
NumPy 快速启动
使用 NumPy 前需要先了解Python;需要安装matplotlib。
学习目标
- 了解一维、二维和 n 维数组的区别
- 了解在不使用 for 循环的情况下如何将一些线性代数应用到 n 维数组中
- 了解 n 维数组的轴和形状特性
[基础知识]
NumPy 的主要对象为均匀的多维数组。数组是元素表(通产为数字),所有元素的类型一致,由一个非负整数的元组进行索引。在 NumPy 中,维度称为轴(axes)。
例如,在一个3 维空间中,一个点的坐标数组为[1, 2, 1],它只有一个轴,轴含有 3 个元素,因此我们可以说其长度为 3。下面的例子中的数组中有 2 个轴,第一个轴的长度为 2,第二个长度为 3.
[[1., 0., 0.],
 [0., 1., 2.]]
NumPy 的数组类称为ndarray,别名为array。记住:numpy.array与 Python 标准库的类array.array不同,后者只能解决以为数组,且功能较少。
ndarray最重要的参数:
- ndarray.ndim :数组维度的数量
- ndarray.shape: 数组的维度,返回一个标明每个维度的数组的大小的元组,如一个 n 行 m 列的矩阵,其 shape 为
(n,m),元组的长度就是ndim值。 - ndarray.size:数组所有元素的个数,等于
shape所有值的乘积 - ndarray.dtype:数组中元素的数据类型,我们可以创建或者指定为标准 Python 数据类型,也可以使用 NumPy 提供的类型,如numpy.int32、numpy.int16、numpy.float64等
- ndarray.itemsize:数组中每个元素的 字节大小,例如
float64的大小为 8(64/8),float64为 4 字节。等同于ndarray.dtype.itemsize. - ndarray.data:
创建数组
- 将列表或者元组转换为数组
import numpy as np
a = np.array([2, 3, 4])
a #array([2, 3, 4])
a.dtype #dtype('int64')
b = np.array([1.2, 3.5, 5.1])
b.dtype #dtype('float64')
有一种常见的错误就是放入太多了参数,而要求是放入一个为序列的参数
a = np.array(1, 2, 3, 4)    # WRONG
Traceback (most recent call last):
  ...
TypeError: array() takes from 1 to 2 positional arguments but 4 were given
a = np.array([1, 2, 3, 4])  # RIGHT
array 方法 将含有一层序列的序列转换成二维数组,将含有两层序列的序列转换成三维数组,以此类推。
b = np.array([(1.5, 2, 3), (4, 5, 6)])
b
array([[1.5, 2. , 3. ],
       [4. , 5. , 6. ]])
b.shape #(2,3)
创建数组时可以指定数据类型
c = np.array([[1, 2], [3, 4]], dtype=complex)
c
array([[1.+0.j, 2.+0.j],
[3.+0.j, 4.+0.j]])- 通过原始占位符创建数组
通常来说,数组元素的类型未知,但其大小一直。因此,NumPy 也可以通过原始占位符的方法创建数组,这种方法减少了扩充数组这种高成本操作的的需要。 - zero、ones、empty
zero函数可以创建一个全是0 的数组,ones函数可以创建全是 1 的数组,empty函数可以根据缓存创建一个随机内容的数组。
这三种方法数据类型默认为float64,但可以通过关键字参数dtype进行修改。
np.zeros((3, 4))
array([[0., 0., 0., 0.],
       [0., 0., 0., 0.],
       [0., 0., 0., 0.]])
np.ones((2, 3, 4), dtype=np.int16)
array([[[1, 1, 1, 1],
        [1, 1, 1, 1],
        [1, 1, 1, 1]],

       [[1, 1, 1, 1],
        [1, 1, 1, 1],
        [1, 1, 1, 1]]], dtype=int16)
np.empty((2, 3))
array([[3.73603959e-262, 6.02658058e-154, 6.55490914e-260],  # may vary
[5.30498948e-313, 3.14673309e-307, 1.00000000e+000]])- 创建数字序列
arange函数可以创建一个类似与range的序列,但返回数组。
np.arange(10, 30, 5) #头、尾、步长
array([10, 15, 20, 25])
np.arange(0, 2, 0.3)  # it accepts float arguments
array([0. , 0.3, 0.6, 0.9, 1.2, 1.5, 1.8])- linspace
当浮点数作为arange的参数时,由于精度问题,通常很难预测每个元素的值,因此最好使用linspace函数,这个函数可以接收元素个数作为一个参数。
from numpy import pi
np.linspace(0, 2, 9)
array([0.  , 0.25, 0.5 , 0.75, 1.  , 1.25, 1.5 , 1.75, 2.  ])
x = np.linspace(0, 2 * pi, 100)
f = np.sin(x)- 其他
array|zeros|zeros_like|ones|ones_like|empty|empty_like
等等等等
打印数组
NumPy 数组结构形似嵌套列表,但具有一些特征
- 最后的轴从左向右打印
- 倒数第二从上到下打印
- 其余从上到下打印,每个切片与下一个切片各一个空行
- 如果矩阵太大的话,会自动跳过总监部分,只显示四周,若要全部显示,我们可以设置
set_printoptions
c = np.arange(24).reshape(2, 3, 4)  # 3d array
print(c)
[[[ 0  1  2  3]
  [ 4  5  6  7]
  [ 8  9 10 11]]

 [[12 13 14 15]
  [16 17 18 19]
  [20 21 22 23]]]

np.set_printoptions(threshold=sys.maxsize)  # sys module should be imported
基本操作
- 算术操作应用于元素身上,结果返回一个新的答案数组。
a = np.array([20, 30, 40, 50])
b = np.arange(4)
b #array([0, 1, 2, 3])
c = a - b
c #array([20, 29, 38, 47])
b**2 #array([0, 1, 4, 9])
10 * np.sin(a) #array([ 9.12945251, -9.88031624,  7.4511316 , -2.62374854])
a < 35
array([ True, True, False, False])*求乘积操作是针对于每个元素,如果要减小矩阵操作,使用@或者dot函数。
A = np.array([[1, 1],
              [0, 1]])
B = np.array([[2, 0],
              [3, 4]])
A * B     # elementwise product
array([[2, 0],
       [0, 4]])
A @ B     # matrix product
array([[5, 4],
       [3, 4]])
A.dot(B)  # another matrix product
array([[5, 4],
[3, 4]])+=和*=操作是对元数组的操作,不会返回一个新的数组。rg = np.random.default_rng(1) # create instance of default random number generator a = np.ones((2, 3), dtype=int) b = rg.random((2, 3)) a *= 3 a array([[3, 3, 3], [3, 3, 3]]) b += a b array([[3.51182162, 3.9504637 , 3.14415961], [3.94864945, 3.31183145, 3.42332645]]) a += b # b is not automatically converted to integer type Traceback (most recent call last): ... numpy.core._exceptions._UFuncOutputCastingError: Cannot cast ufunc 'add' output from dtype('float64') to dtype('int64') with casting rule 'same_kind'当操作的数组们的数据类型不同,数组结果与更加综合精确的一致(upcasting)
a = np.ones(3, dtype=np.int32)
b = np.linspace(0, pi, 3)
b.dtype.name
'float64'
c = a + b
c
array([1.        , 2.57079633, 4.14159265])
c.dtype.name
'float64'
d = np.exp(c * 1j)
d
array([ 0.54030231+0.84147098j, -0.84147098+0.54030231j,
    -0.54030231-0.84147098j])
d.dtype.name
'complex128'
许多一元操作,如求所有元素的和,在
ndarray类的方法中。a = rg.random((2, 3)) a array([[0.82770259, 0.40919914, 0.54959369], [0.02755911, 0.75351311, 0.53814331]]) a.sum() 3.1057109529998157 a.min() 0.027559113243068367 a.max() 0.8277025938204418在默认情况下,对数组的操作可以不管其形状,看做列表即可。但在特殊情况下,可以指定
axis参数,沿着这个轴进行操作。b = np.arange(12).reshape(3, 4) b array([[ 0, 1, 2, 3], [ 4, 5, 6, 7], [ 8, 9, 10, 11]]) >>> b.sum(axis=0) # sum of each column array([12, 15, 18, 21]) >>> b.min(axis=1) # min of each row array([0, 4, 8]) >>> b.cumsum(axis=1) # cumulative sum along each row array([[ 0, 1, 3, 6], [ 4, 9, 15, 22], [ 8, 17, 27, 38]])
通用函数
NumPy 提供一些常见的函数:sin、cos、exp 等,这些函数在 NumPy 中称为通用函数(universal functions” (ufunc))。在 NumPy 中,这些函数在元素上操作,并生成一个新的数组。
B = np.arange(3)
B
array([0, 1, 2])
np.exp(B)
array([1.        , 2.71828183, 7.3890561 ])
np.sqrt(B)
array([0.        , 1.        , 1.41421356])
C = np.array([2., -1., 4.])
np.add(B, C)
array([2., 0., 6.])其他函数all, any, apply_along_axis, argmax, argmin, argsort, average, bincount, ceil, clip, conj, corrcoef, cov, cross, cumprod, cumsum, diff, dot, floor, inner, invert, lexsort, max, maximum, mean, median, min, minimum, nonzero, outer, prod, re, round, sort, std, sum, trace, transpose, var, vdot, vectorize, where
索引、切片和迭代
一维数组与列表一样,可以进行索引、切片和迭代操作。
a = np.arange(10)**3
a  #array([  0,   1,   8,  27,  64, 125, 216, 343, 512, 729])
a[2] #8
a[2:5] #array([ 8, 27, 64])
a[0:6:2] = 100
a #array([100,   1, 100,  27, 100, 125, 216, 343, 512, 729])
a[::-1] #a = np.arange(10)**3
a  #array([  0,   1,   8,  27,  64, 125, 216, 343, 512, 729])
a[2] #8
a[2:5] #array([ 8, 27, 64])
a[0:6:2] = 100
a #array([100,   1, 100,  27, 100, 125, 216, 343, 512, 729])
a[::-1] #array([729, 512, 343, 216, 125, 100,  27, 100,   1, 100])
for i in a:
    print(i**(1/3.))
"""4.641588833612778
1.0
4.641588833612778
3.0
4.641588833612778
4.999999999999999
5.999999999999999
6.999999999999999
7.999999999999999
8.999999999999998"""
多维数组的每个轴都有一个索引。切片操作用过一个元组进行。
def f(x,y):
    return x*10+y

b = np.fromfunction(f,(5,4),dtype = int)
b
"""array([[ 0,  1,  2,  3],
       [10, 11, 12, 13],
       [20, 21, 22, 23],
       [30, 31, 32, 33],
       [40, 41, 42, 43]])"""

b[2,3] #23
b[0:5,1] #array([ 1, 11, 21, 31, 41])
b[:,1] #array([ 1, 11, 21, 31, 41])
b[1:3,:]
"""array([[10, 11, 12, 13],
       [20, 21, 22, 23]])"""
当切片值小于轴的数值时,缺失的切片值默认为取全部
b[-1]   # the last row. Equivalent to b[-1, :]
array([40, 41, 42, 43])当用...时,省略未填写的切片
x[1, 2, ...]is equivalent tox[1, 2, :, :, :],x[..., 3]tox[:, :, :, :, 3]andx[4, ..., 5, :]tox[4, :, :, 5, :]
c = np.array([[[  0,  1,  2],  # a 3D array (two stacked 2D arrays)
               [ 10, 12, 13]],
              [[100, 101, 102],
               [110, 112, 113]]])
c.shape #(2, 2, 3)
c[1, ...]  # same as c[1, :, :] or c[1]
'''array([[100, 101, 102],
       [110, 112, 113]])'''
c[..., 2]  # same as c[:, :, 2]
'''array([[  2,  13],
[102, 113]])'''多维度向量的迭代以第一轴为准。当需要对每个元素操作时,可以使用flat参数,这个参数可以迭代出该向量所有的元素。
for i in b:
    print(i)

"""[0 1 2 3]
[10 11 12 13]
[20 21 22 23]
[30 31 32 33]
[40 41 42 43] """

for a in b.flat:
    print(a)
Indexing on ndarrays, Indexing routines (reference), newaxis, ndenumerate, indices
形状操作
改变向量的形状
以下操作是对原向量的修改,但不会改变原始向量。
a = np.array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
       [7., 2., 4., 9.]])
a.shape #(3, 4)

a.ravel() #array([3., 7., 3., 4., 1., 4., 2., 2., 7., 2., 4., 9.])
a.flat #返回一个可迭代对象
a.reshape(2,6)
"""array([[3., 7., 3., 4., 1., 4.],
       [2., 2., 7., 2., 4., 9.]])
"""
a.T
"""array([[3., 1., 7.],
       [7., 4., 2.],
       [3., 2., 4.],
       [4., 2., 9.]])"""
a.T.shape #(4, 3)
a.shape #(3, 4)ravel操作后元素的顺序为“C-style”,即最右边的索引变化最快,因此a[0, 0]后的元素为a[0, 1]。
如果向量变成其他形状,也满足“C-style”。NumPy创建的数组通常按照这顺序存储,因此ravel通常不会复制这些参数,但如果向量是另一个向量切片生成的,按就需要复制的。函数reval和reshace都可以通过参数进行设置——FORTRAN-style ,最左边的索引变化最快。
reshape函数返回到向量形变后的参数,而dnarray.resize方法则会改变向量本身。
a
array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
       [7., 2., 4., 9.]])
a.resize((2, 6))
a
array([[3., 7., 3., 4., 1., 4.],
       [2., 2., 7., 2., 4., 9.]])
当一个维度的值为-1 时,其值会通过其他参数进行计算。
a.reshape(3, -1)
array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
[7., 2., 4., 9.]])ndarray.shape, reshape, resize, ravel
多个数组堆叠
若干个数组可以以某个轴堆叠在一起。vstack 和 hstack
a = np.array([[9., 7.],
       [5., 2.]])
b = np.array([[1., 9.],
       [5., 1.]])
np.vstack((a,b))
"""array([[9., 7.],
       [5., 2.],
       [1., 9.],
       [5., 1.]])"""

np.hstack((a,b))
"""array([[9., 7., 1., 9.],
[5., 2., 5., 1.]])"""column_stack将一维数组按照列堆叠成一个二维数组,相当于二维数组下的 hstack。
另一方面,row_stack 等同于任意数组的vstack。事实上,row_stack就是vstack。
a = np.array([4., 2.])
b = np.array([3., 8.])
np.column_stack((a,b))
"""array([[4., 3.],
       [2., 8.]])"""
np.hstack((a,b)) #array([4., 2., 3., 8.])
from numpy import newaxis
a[:,newaxis]
"""array([[4.],
       [2.]])"""
np.column_stack((a[:, newaxis], b[:, newaxis]))
"""array([[4., 3.],
       [2., 8.]])"""

np.hstack((a[:, newaxis], b[:, newaxis]))
"""array([[4., 3.],
       [2., 8.]])"""

np.column_stack is np.hstack
False
np.row_stack is np.vstack
True一般来说,对于超过二维的数组,hstack通过第二轴进行堆叠,vstack则是通过第一轴进行堆叠,而 concatenate则科通修改堆叠的轴。
注:在一些复杂情况下, r_ 和 c_ 方法对于通过某一个轴堆叠多个数组去创建数组非常有用。
np.r_[1:4, 0, 4]
array([1, 2, 3, 0, 4])
在参数上, r_ 和 c_ 方法在默认情况下与 vstack 和 hstack 很像,但前者可以改变轴来进行堆叠。
hstack, vstack, column_stack, concatenate, c_, r_
拆分数组
hsplit方法可以再水平轴上拆分数组,是指定要返回的相同形状数组的数量,也可以指定随后应进行分割的列;
vsplit方法在垂直轴进行拆分。
array_split方法可设定特定的轴进行拆分。
a = np.array([[6., 7., 6., 9., 0., 5., 4., 0., 6., 8., 5., 2.],
       [8., 5., 5., 7., 1., 8., 6., 7., 1., 8., 1., 0.]])
np.hsplit(a,3) #返回一个列表,元素是将原来所有元素 flat 后在重新拆成3 个数组
"""[array([[6., 7., 6., 9.],
        [8., 5., 5., 7.]]),
 array([[0., 5., 4., 0.],
        [1., 8., 6., 7.]]),
 array([[6., 8., 5., 2.],
        [1., 8., 1., 0.]])]"""
np.hsplit(a,(3,4)) #split的索引位置
"""
[array([[6., 7., 6.],
        [8., 5., 5.]]),
 array([[9.],
        [7.]]),
 array([[0., 5., 4., 0., 6., 8., 5., 2.],
        [1., 8., 6., 7., 1., 8., 1., 0.]])]"""
副本和视图
在操作数组时,其数据有时候会复制到一个新的数组中,有时则不会。对于初学者来着这很困惑。有以下三总情况
1 完全不复制
a = np.array([[ 0,  1,  2,  3],
              [ 4,  5,  6,  7],
              [ 8,  9, 10, 11]])
b = a            # no new object is created
b is a           # a and b are two names for the same ndarray object
True
Python将可变对象作为引用传递,因此函数调用不进行复制。
def f(x):
    print(id(x))

id(a)  # id is a unique identifier of an object
148293216  # may vary
f(a)
148293216  # may vary
2 视图或者浅拷贝
不同的数组对象有可能有想听的数据,view方法可以创建一个新的数组对象,数据看起来一样。
浅拷贝:当 a 被复制为 b,b 进行修改时,a 也同时修改
c = a.view()
c is a
False
c.base is a            # c is a view of the data owned by a
True
c.flags.owndata
False
>>>
c = c.reshape((2, 6))  # a's shape doesn't change
a.shape
(3, 4)
c[0, 4] = 1234         # a's data changes
a
array([[   0,    1,    2,    3],
       [1234,    5,    6,    7],
       [   8,    9,   10,   11]])
切片返回其视图
s = a[:, 1:3]
s[:] = 10  # s[:] is a view of s. Note the difference between s = 10 and s[:] = 10
a
array([[   0,   10,   10,    3],
       [1234,   10,   10,    7],
       [   8,   10,   10,   11]])
3 深拷贝
深拷贝方法copy就是对数组及其数据进行完全拷贝。
d = a.copy()  # a new array object with new data is created
d is a
False
d.base is a  # d doesn't share anything with a
False
d[0, 0] = 9999
a
array([[   0,   10,   10,    3],
       [1234,   10,   10,    7],
[ 8, 10, 10, 11]])如果原始数组进行切片后不再需要的话,可以对其进行copy。如 a 是一个巨大的居中结果型的数组,而 b 只是包含了一小部分的 a,当通过切片 a 构建 b 的时候要使用深拷贝。(这样删除 a 的时候不会对 b 造成影响)
a = np.arange(int(1e8))
b = a[:100].copy()
del a  # the memory of ``a`` can be rele
函数和方法总览
- 创建数组:
arange,array,copy,empty,empty_like,eye,fromfile,fromfunction,identity,linspace,logspace,mgrid,ogrid,ones,ones_like,r_,zeros,zeros_like - 转换:
ndarray.astype,atleast_1d,atleast_2d,atleast_3d,mat - 处理:
array_split,column_stack,concatenate,diagonal,dsplit,dstack,hsplit,hstack,ndarray.item,newaxis,ravel,repeat,reshape,resize,squeeze,swapaxes,take,transpose,vsplit,vstack - 问题
all,any,nonzero,where - 排序
argmax,argmin,argsort,max,min,ptp,searchsorted,sort - 操作
choose,compress,cumprod,cumsum,inner,ndarray.fill,imag,prod,put,putmask,real,sum - 基本统计
cov,mean,std,var - 基本线性代数
cross,dot,outer,linalg.svd,vdot
广播规则:
广播允许通用函数以一种有意义的方式处理形状不相同的输入。
广播第一条规则:如果所有输入的数组维度不同,较小数组前会用 “1”补齐,直到所有数组的维度一致。
广播第二条规则:某个数组在特定维度值为 1情况下,确保其操作与最大的维度的数组一致。而这些数组的值应该与那些广播数组相应维度的值一样。
根据广播规则,所有数组的形状必须匹配,更新信息见Broadcasting。
高级索引和索引技巧
比起 Python,NumPy提供了更多的索引工具,除了通过整数和切片初音,数组还可以通过整数型的数组和布尔型的数组索引。
数组切片索引
a = np.arange(12)**2 #array([  0,   1,   4,   9,  16,  25,  36,  49,  64,  81, 100, 121])
i = np.array([1,1,3,8,5])
a[i]#array([ 1,  1,  9, 64, 25])
j = np.array([[3,4],[8,6]])
a[j]
"""
array([[ 9, 16],
       [64, 36]])"""
如果被索引的数组是多维的,一个切片的单个索引只能涉及到这个宿主的第一维度。
palette = np.array([[0, 0, 0],         # black
                    [255, 0, 0],       # red
                    [0, 255, 0],       # green
                    [0, 0, 255],       # blue
                    [255, 255, 255]])  # white
image = np.array([[0, 1, 2, 0],  # each value corresponds to a color in the palette
                  [0, 3, 4, 0]])
palette[image]  # the (2, 4, 3) color image
array([[[  0,   0,   0],
        [255,   0,   0],
        [  0, 255,   0],
        [  0,   0,   0]],

       [[  0,   0,   0],
        [  0,   0, 255],
        [255, 255, 255],
        [  0,   0,   0]]])
我们的索引号不仅仅可以是一维的,这些对每个维度的切片数组必须长一样。
a = np.arange(12).reshape(3,4)
a
"""
array([[ 0,  1,  2,  3],
       [ 4,  5,  6,  7],
       [ 8,  9, 10, 11]])"""
i = np.array([[0,1],[1,2]])
j = np.array([[2,1],[3,3]])
a[i,2]
"""
array([[ 2,  6],
       [ 6, 10]])"""
a[:,j]
"""
array([[[ 2,  1],
        [ 3,  3]],

       [[ 6,  5],
        [ 7,  7]],

       [[10,  9],
        [11, 11]]])"""
a[i,j]
"""
array([[ 2,  5],
       [ 7, 11]])"""
在 Python 中,arr[i, j]就是arr[(i, j)],所以我们将 i 和 j 放到一个元组中后进行索引。
l = (i, j)
# equivalent to a[i, j]
a[l]
array([[ 2,  5],
       [ 7, 11]])
但我们不会将 i 和 j 放到一个数组中进行索引,因为数组会默位索引数组的第一维度
s =  np.array([i,j])
a[s]#index 3 is out of bounds for axis 0 with size 3
a[tuple(s)]
"""array([[ 2,  5],
       [ 7, 11]])"""
使用数组索引的另一个常见用途是寻找时间依赖序列的最大值:
time = np.linspace(20,145,5) #20-145之间取5 个数
time #array([ 20.  ,  51.25,  82.5 , 113.75, 145.  ])
data = np.sin(np.arange(20)).reshape(5,4)
data
"""array([[ 0.        ,  0.84147098,  0.90929743,  0.14112001],
       [-0.7568025 , -0.95892427, -0.2794155 ,  0.6569866 ],
       [ 0.98935825,  0.41211849, -0.54402111, -0.99999021],
       [-0.53657292,  0.42016704,  0.99060736,  0.65028784],
       [-0.28790332, -0.96139749, -0.75098725,  0.14987721]])"""
ind = data.argmax(axis=0)#每一列最大值的索引
ind #array([2, 0, 3, 1])
time_max = time[ind]
time_max #array([ 82.5 ,  20.  , 113.75,  51.25])
data_max = data[ind,range(data.shape[1])]
data_max #array([0.98935825, 0.84147098, 0.99060736, 0.6569866 ])
np.all(data_max ==data.max(axis=0))
我们可以根据数组索引重置目标数值:
a = np.arange(5)
a +=1
a
a[[1,3,4]]=999 #索引位置,而不是其中的值
a #array([  1, 999,   3, 999, 999])
当切片列表包含重复值时,赋值会重复操作,但保留最后一个,在本案例中金蒜 0 出现 2 次,第 0 个元素只操作了 1 次。这是因为 a +=1 等同于 a = a+1
a = np.arange(5)
a[[0, 0, 2]] += 1
a #array([1, 1, 3, 3, 4])
布尔数组索引
当我们使用(整型)数组索引数组时,我们需要提供要选择的索引列表。对于布尔索引,方法与数值型不同,在布尔索引中,我们明确数组中想要与不想要的项目。我们可以想到的最自然的方法就是使用与原始数组形状一直的布尔数组,此外我们还可以重置数组中的值。
n = np.arange(12).reshape(3,4)
b = n >4
b
"""array([[False, False, False, False],
       [False,  True,  True,  True],
       [ True,  True,  True,  True]])"""
n[b]#array([ 5,  6,  7,  8,  9, 10, 11]) 选择出所有 True 的值
n[b] = 0
n #n 中所有 True 的值重置为 0
"""array([[0, 1, 2, 3],
       [4, 0, 0, 0],
[0, 0, 0, 0]])"""以下例子可以了解如何使用布尔数组索引去生成曼德尔布罗特集的图像:
import numpy as np
import matplotlib.pyplot as plt
def mandelbrot(h,w,maxit = 20,r = 2):
    x = np.linspace(-2.5,1.5,4*h+1)
    y = np.linspace(-1.5,1.5,3*w+1)
    A,B = np.meshgrid(x,y)
    C = A+B*1j
    z = np.zeros_like(C)
    divtime = maxit +np.zeros(z.shape,dtype= int)

    for i in range(maxit):
        z = z**2+C
        diverge = abs(z)>r
        div_now = diverge&(divtime == maxit)
        divtime[div_now]=i
        z[diverge] = r

    return divtime
plt.imshow(mandelbrot(400,400))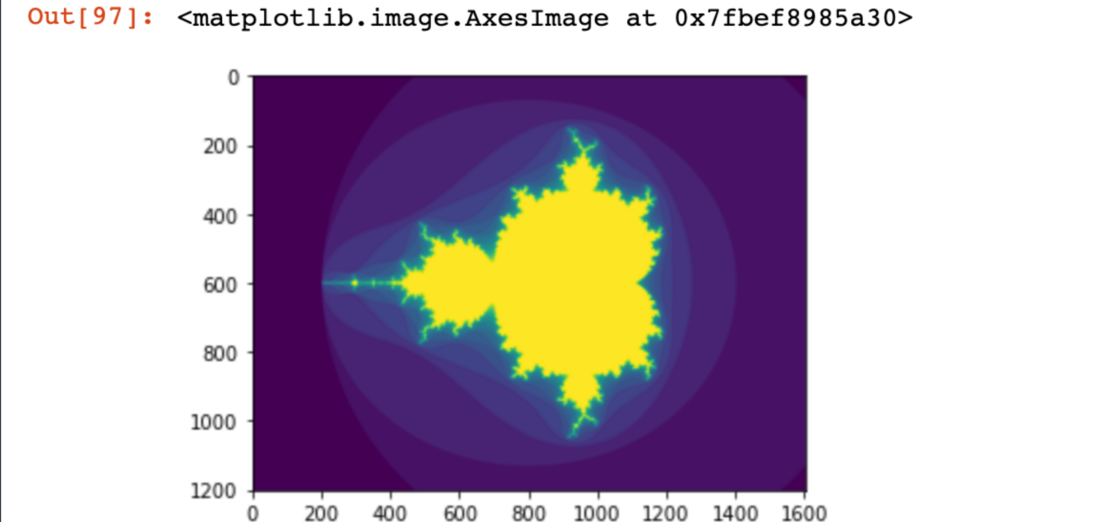
第二种布尔索引方式与整型索引更相似,对于数组的每个维度,我们都可以提供一个一维的布尔数组用于选择我们的目标对象:
a = np.arange(12).reshape(3,4)
b1 = np.array([False,True,True]) #1st
b2 = np.array([True,False,True,False]) #2nd
a[b1,:]
"""array([[ 4,  5,  6,  7],
       [ 8,  9, 10, 11]])"""
a[:,b2]
"""array([[ 0,  2],
       [ 4,  6],
       [ 8, 10]])"""
a[b1,b2] #array([ 4, 10])
注:1μ的布尔数组的长度必须与你期望索引的维度的长度一致。上面实例中,b1 的长度为 3(a 行数为 3),b2 的长度为 4,与第二维的长度一致。
ix_() 函数
ix_() 函数用于组合不同向量,以获得每个n-uplet的结果。例如:如果你想计算所有向量 a、b 和 c 所有triplets 的 a+b*c 的值
a = np.array([2,3,4,5])
b = np.array([8,5,4])
c = np.array([5,4,6,8,3])
ax,bx,cx = np.ix_(a,b,c)
ax #第一维度形成三维数组
"""array([[[2]],

       [[3]],

       [[4]],

       [[5]]])"""
bx# 第二维度形成数组
"""array([[[8],
        [5],
        [4]]])"""
cx# 第三维度形成数组
"""array([[[5, 4, 6, 8, 3]]])"""
ax.shape, bx.shape, cx.shape
"""((4, 1, 1), (1, 3, 1), (1, 1, 5))"""
result = ax+bx*cx
result
"""array([[[42, 34, 50, 66, 26],
        [27, 22, 32, 42, 17],
        [22, 18, 26, 34, 14]],

       [[43, 35, 51, 67, 27],
        [28, 23, 33, 43, 18],
        [23, 19, 27, 35, 15]],

       [[44, 36, 52, 68, 28],
        [29, 24, 34, 44, 19],
        [24, 20, 28, 36, 16]],

       [[45, 37, 53, 69, 29],
        [30, 25, 35, 45, 20],
        [25, 21, 29, 37, 17]]])"""
result[3,2,4] #17
a[3]+b[2]*c[4] #17
也可以将其按照下列方式减少
def ufunc_reduce(ufct,*vectors):
    vs = np.ix_(*vectors)
    r = ufct.identity
    for v in vs:
        r = ufct(r,v)
    return r

ufunc_reduce(np.add,a,b,c)
"""array([[[15, 14, 16, 18, 13],
        [12, 11, 13, 15, 10],
        [11, 10, 12, 14,  9]],

       [[16, 15, 17, 19, 14],
        [13, 12, 14, 16, 11],
        [12, 11, 13, 15, 10]],

       [[17, 16, 18, 20, 15],
        [14, 13, 15, 17, 12],
        [13, 12, 14, 16, 11]],

       [[18, 17, 19, 21, 16],
        [15, 14, 16, 18, 13],
        [14, 13, 15, 17, 12]]])"""
比起 ufunc.reduce,此版本的 reduce 可以利用广播规则去避免创建一个数组相乘后的大小的参数数组。
字符串索引
请参阅结构化数组。
技巧和窍门
“自动”修改形状:一个适量维度的改变,你可以省略一个大小,自动推算(-1么)
a = np.arange(30)
>>> b = a.reshape((2, -1, 3))  # -1 means "whatever is needed"
>>> b.shape
(2, 5, 3)矢量堆叠:我们如何利用一些相同大小的数量构建一个二维数组?在 MATLAB 中:假如xy 两个矢量的长度相同,然后你只需要使用m=[x;y]即可完成。在 NumPy,该功能可以根据需要堆叠的温度,通过 column_stack, dstack, hstack 和 vstack函数完整。
x = np.arange(0, 10, 2)
>>> y = np.arange(5)
>>> m = np.vstack([x, y])
>>> m
array([[0, 2, 4, 6, 8],
       [0, 1, 2, 3, 4]])
>>> xy = np.hstack([x, y])
>>> xy
array([0, 2, 4, 6, 8, 0, 1, 2, 3, 4])其他资料:适用于MATLAB用户的NumPy
直方图
应用于一个数组的直方图函数返回一对向量:数组直方图和图边缘向量。注:matplotlib 也提供直方图函数(hist)与 NumPy 的直方图不同,pylab.hist会自动生产直方图,而 NumPy.histogram 只能生成数据。
import numpy as np
rg = np.random.default_rng(1)
import matplotlib.pyplot as plt
mu, sigma = 2,0.5
v = rg.normal(mu,sigma,1000)
v #一个一维数组,一共 1000 个元素,取值范围在 0.5-2 之间
plt.hist(v,bins = 50,density=True)
(n,bins) = np.histogram(v,bins=50,density=True)
plt.plot(.5*(bins[1:]+bins[:-1]),n)
通用函数
NumPy 提供一些常见的函数:sin、cos、exp 等,这些函数在 NumPy 中称为通用函数(universal functions” (ufunc))。在 NumPy 中,这些函数在元素上操作,并生成一个新的数组。
B = np.arange(3)
B
array([0, 1, 2])
np.exp(B)
array([1.        , 2.71828183, 7.3890561 ])
np.sqrt(B)
array([0.        , 1.        , 1.41421356])
C = np.array([2., -1., 4.])
np.add(B, C)
array([2., 0., 6.])其他函数all, any, apply_along_axis, argmax, argmin, argsort, average, bincount, ceil, clip, conj, corrcoef, cov, cross, cumprod, cumsum, diff, dot, floor, inner, invert, lexsort, max, maximum, mean, median, min, minimum, nonzero, outer, prod, re, round, sort, std, sum, trace, transpose, var, vdot, vectorize, where
索引、切片和迭代
一维数组与列表一样,可以进行索引、切片和迭代操作。
a = np.arange(10)**3
a  #array([  0,   1,   8,  27,  64, 125, 216, 343, 512, 729])
a[2] #8
a[2:5] #array([ 8, 27, 64])
a[0:6:2] = 100
a #array([100,   1, 100,  27, 100, 125, 216, 343, 512, 729])
a[::-1] #a = np.arange(10)**3
a  #array([  0,   1,   8,  27,  64, 125, 216, 343, 512, 729])
a[2] #8
a[2:5] #array([ 8, 27, 64])
a[0:6:2] = 100
a #array([100,   1, 100,  27, 100, 125, 216, 343, 512, 729])
a[::-1] #array([729, 512, 343, 216, 125, 100,  27, 100,   1, 100])
for i in a:
    print(i**(1/3.))
"""4.641588833612778
1.0
4.641588833612778
3.0
4.641588833612778
4.999999999999999
5.999999999999999
6.999999999999999
7.999999999999999
8.999999999999998"""
多维数组的每个轴都有一个索引。切片操作用过一个元组进行。
def f(x,y):
    return x*10+y

b = np.fromfunction(f,(5,4),dtype = int)
b
"""array([[ 0,  1,  2,  3],
       [10, 11, 12, 13],
       [20, 21, 22, 23],
       [30, 31, 32, 33],
       [40, 41, 42, 43]])"""

b[2,3] #23
b[0:5,1] #array([ 1, 11, 21, 31, 41])
b[:,1] #array([ 1, 11, 21, 31, 41])
b[1:3,:]
"""array([[10, 11, 12, 13],
       [20, 21, 22, 23]])"""
当切片值小于轴的数值时,缺失的切片值默认为取全部
b[-1]   # the last row. Equivalent to b[-1, :]
array([40, 41, 42, 43])当用...时,省略未填写的切片
x[1, 2, ...]is equivalent tox[1, 2, :, :, :],x[..., 3]tox[:, :, :, :, 3]andx[4, ..., 5, :]tox[4, :, :, 5, :]
c = np.array([[[  0,  1,  2],  # a 3D array (two stacked 2D arrays)
               [ 10, 12, 13]],
              [[100, 101, 102],
               [110, 112, 113]]])
c.shape #(2, 2, 3)
c[1, ...]  # same as c[1, :, :] or c[1]
'''array([[100, 101, 102],
       [110, 112, 113]])'''
c[..., 2]  # same as c[:, :, 2]
'''array([[  2,  13],
[102, 113]])'''多维度向量的迭代以第一轴为准。当需要对每个元素操作时,可以使用flat参数,这个参数可以迭代出该向量所有的元素。
for i in b:
    print(i)

"""[0 1 2 3]
[10 11 12 13]
[20 21 22 23]
[30 31 32 33]
[40 41 42 43] """

for a in b.flat:
    print(a)
Indexing on ndarrays, Indexing routines (reference), newaxis, ndenumerate, indices
形状操作
改变向量的形状
以下操作是对原向量的修改,但不会改变原始向量。
a = np.array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
       [7., 2., 4., 9.]])
a.shape #(3, 4)

a.ravel() #array([3., 7., 3., 4., 1., 4., 2., 2., 7., 2., 4., 9.])
a.flat #返回一个可迭代对象
a.reshape(2,6)
"""array([[3., 7., 3., 4., 1., 4.],
       [2., 2., 7., 2., 4., 9.]])
"""
a.T
"""array([[3., 1., 7.],
       [7., 4., 2.],
       [3., 2., 4.],
       [4., 2., 9.]])"""
a.T.shape #(4, 3)
a.shape #(3, 4)ravel操作后元素的顺序为“C-style”,即最右边的索引变化最快,因此a[0, 0]后的元素为a[0, 1]。
如果向量变成其他形状,也满足“C-style”。NumPy创建的数组通常按照这顺序存储,因此ravel通常不会复制这些参数,但如果向量是另一个向量切片生成的,按就需要复制的。函数reval和reshace都可以通过参数进行设置——FORTRAN-style ,最左边的索引变化最快。
reshape函数返回到向量形变后的参数,而dnarray.resize方法则会改变向量本身。
a
array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
       [7., 2., 4., 9.]])
a.resize((2, 6))
a
array([[3., 7., 3., 4., 1., 4.],
       [2., 2., 7., 2., 4., 9.]])
当一个维度的值为-1 时,其值会通过其他参数进行计算。
a.reshape(3, -1)
array([[3., 7., 3., 4.],
       [1., 4., 2., 2.],
[7., 2., 4., 9.]])ndarray.shape, reshape, resize, ravel
多个数组堆叠
若干个数组可以以某个轴堆叠在一起。vstack 和 hstack
a = np.array([[9., 7.],
       [5., 2.]])
b = np.array([[1., 9.],
       [5., 1.]])
np.vstack((a,b))
"""array([[9., 7.],
       [5., 2.],
       [1., 9.],
       [5., 1.]])"""

np.hstack((a,b))
"""array([[9., 7., 1., 9.],
[5., 2., 5., 1.]])"""column_stack将一维数组按照列堆叠成一个二维数组,相当于二维数组下的 hstack。
另一方面,row_stack 等同于任意数组的vstack。事实上,row_stack就是vstack。
a = np.array([4., 2.])
b = np.array([3., 8.])
np.column_stack((a,b))
"""array([[4., 3.],
       [2., 8.]])"""
np.hstack((a,b)) #array([4., 2., 3., 8.])
from numpy import newaxis
a[:,newaxis]
"""array([[4.],
       [2.]])"""
np.column_stack((a[:, newaxis], b[:, newaxis]))
"""array([[4., 3.],
       [2., 8.]])"""

np.hstack((a[:, newaxis], b[:, newaxis]))
"""array([[4., 3.],
       [2., 8.]])"""

np.column_stack is np.hstack
False
np.row_stack is np.vstack
True一般来说,对于超过二维的数组,hstack通过第二轴进行堆叠,vstack则是通过第一轴进行堆叠,而 concatenate则科通修改堆叠的轴。
注:在一些复杂情况下, r_ 和 c_ 方法对于通过某一个轴堆叠多个数组去创建数组非常有用。
np.r_[1:4, 0, 4]
array([1, 2, 3, 0, 4])
在参数上, r_ 和 c_ 方法在默认情况下与 vstack 和 hstack 很像,但前者可以改变轴来进行堆叠。
hstack, vstack, column_stack, concatenate, c_, r_
拆分数组
hsplit方法可以再水平轴上拆分数组,是指定要返回的相同形状数组的数量,也可以指定随后应进行分割的列;
vsplit方法在垂直轴进行拆分。
array_split方法可设定特定的轴进行拆分。
a = np.array([[6., 7., 6., 9., 0., 5., 4., 0., 6., 8., 5., 2.],
       [8., 5., 5., 7., 1., 8., 6., 7., 1., 8., 1., 0.]])
np.hsplit(a,3) #返回一个列表,元素是将原来所有元素 flat 后在重新拆成3 个数组
"""[array([[6., 7., 6., 9.],
        [8., 5., 5., 7.]]),
 array([[0., 5., 4., 0.],
        [1., 8., 6., 7.]]),
 array([[6., 8., 5., 2.],
        [1., 8., 1., 0.]])]"""
np.hsplit(a,(3,4)) #split的索引位置
"""
[array([[6., 7., 6.],
        [8., 5., 5.]]),
 array([[9.],
        [7.]]),
 array([[0., 5., 4., 0., 6., 8., 5., 2.],
        [1., 8., 6., 7., 1., 8., 1., 0.]])]"""
副本和视图
在操作数组时,其数据有时候会复制到一个新的数组中,有时则不会。对于初学者来着这很困惑。有以下三总情况
1 完全不复制
a = np.array([[ 0,  1,  2,  3],
              [ 4,  5,  6,  7],
              [ 8,  9, 10, 11]])
b = a            # no new object is created
b is a           # a and b are two names for the same ndarray object
True
Python将可变对象作为引用传递,因此函数调用不进行复制。
def f(x):
    print(id(x))

id(a)  # id is a unique identifier of an object
148293216  # may vary
f(a)
148293216  # may vary
2 视图或者浅拷贝
不同的数组对象有可能有想听的数据,view方法可以创建一个新的数组对象,数据看起来一样。
浅拷贝:当 a 被复制为 b,b 进行修改时,a 也同时修改
c = a.view()
c is a
False
c.base is a            # c is a view of the data owned by a
True
c.flags.owndata
False
>>>
c = c.reshape((2, 6))  # a's shape doesn't change
a.shape
(3, 4)
c[0, 4] = 1234         # a's data changes
a
array([[   0,    1,    2,    3],
       [1234,    5,    6,    7],
       [   8,    9,   10,   11]])
切片返回其视图
s = a[:, 1:3]
s[:] = 10  # s[:] is a view of s. Note the difference between s = 10 and s[:] = 10
a
array([[   0,   10,   10,    3],
       [1234,   10,   10,    7],
       [   8,   10,   10,   11]])
3 深拷贝
深拷贝方法copy就是对数组及其数据进行完全拷贝。
d = a.copy()  # a new array object with new data is created
d is a
False
d.base is a  # d doesn't share anything with a
False
d[0, 0] = 9999
a
array([[   0,   10,   10,    3],
       [1234,   10,   10,    7],
[ 8, 10, 10, 11]])如果原始数组进行切片后不再需要的话,可以对其进行copy。如 a 是一个巨大的居中结果型的数组,而 b 只是包含了一小部分的 a,当通过切片 a 构建 b 的时候要使用深拷贝。(这样删除 a 的时候不会对 b 造成影响)
a = np.arange(int(1e8))
b = a[:100].copy()
del a  # the memory of ``a`` can be rele
函数和方法总览
- 创建数组:
arange,array,copy,empty,empty_like,eye,fromfile,fromfunction,identity,linspace,logspace,mgrid,ogrid,ones,ones_like,r_,zeros,zeros_like - 转换:
ndarray.astype,atleast_1d,atleast_2d,atleast_3d,mat - 处理:
array_split,column_stack,concatenate,diagonal,dsplit,dstack,hsplit,hstack,ndarray.item,newaxis,ravel,repeat,reshape,resize,squeeze,swapaxes,take,transpose,vsplit,vstack - 问题
all,any,nonzero,where - 排序
argmax,argmin,argsort,max,min,ptp,searchsorted,sort - 操作
choose,compress,cumprod,cumsum,inner,ndarray.fill,imag,prod,put,putmask,real,sum - 基本统计
cov,mean,std,var - 基本线性代数
cross,dot,outer,linalg.svd,vdot
广播规则:
广播允许通用函数以一种有意义的方式处理形状不相同的输入。
广播第一条规则:如果所有输入的数组维度不同,较小数组前会用 “1”补齐,直到所有数组的维度一致。
广播第二条规则:某个数组在特定维度值为 1情况下,确保其操作与最大的维度的数组一致。而这些数组的值应该与那些广播数组相应维度的值一样。
根据广播规则,所有数组的形状必须匹配,更新信息见Broadcasting。
高级索引和索引技巧
比起 Python,NumPy提供了更多的索引工具,除了通过整数和切片初音,数组还可以通过整数型的数组和布尔型的数组索引。
数组切片索引
a = np.arange(12)**2 #array([  0,   1,   4,   9,  16,  25,  36,  49,  64,  81, 100, 121])
i = np.array([1,1,3,8,5])
a[i]#array([ 1,  1,  9, 64, 25])
j = np.array([[3,4],[8,6]])
a[j]
"""
array([[ 9, 16],
       [64, 36]])"""
如果被索引的数组是多维的,一个切片的单个索引只能涉及到这个宿主的第一维度。
palette = np.array([[0, 0, 0],         # black
                    [255, 0, 0],       # red
                    [0, 255, 0],       # green
                    [0, 0, 255],       # blue
                    [255, 255, 255]])  # white
image = np.array([[0, 1, 2, 0],  # each value corresponds to a color in the palette
                  [0, 3, 4, 0]])
palette[image]  # the (2, 4, 3) color image
array([[[  0,   0,   0],
        [255,   0,   0],
        [  0, 255,   0],
        [  0,   0,   0]],

       [[  0,   0,   0],
        [  0,   0, 255],
        [255, 255, 255],
        [  0,   0,   0]]])
我们的索引号不仅仅可以是一维的,这些对每个维度的切片数组必须长一样。
a = np.arange(12).reshape(3,4)
a
"""
array([[ 0,  1,  2,  3],
       [ 4,  5,  6,  7],
       [ 8,  9, 10, 11]])"""
i = np.array([[0,1],[1,2]])
j = np.array([[2,1],[3,3]])
a[i,2]
"""
array([[ 2,  6],
       [ 6, 10]])"""
a[:,j]
"""
array([[[ 2,  1],
        [ 3,  3]],

       [[ 6,  5],
        [ 7,  7]],

       [[10,  9],
        [11, 11]]])"""
a[i,j]
"""
array([[ 2,  5],
       [ 7, 11]])"""
在 Python 中,arr[i, j]就是arr[(i, j)],所以我们将 i 和 j 放到一个元组中后进行索引。
l = (i, j)
# equivalent to a[i, j]
a[l]
array([[ 2,  5],
       [ 7, 11]])
但我们不会将 i 和 j 放到一个数组中进行索引,因为数组会默位索引数组的第一维度
s =  np.array([i,j])
a[s]#index 3 is out of bounds for axis 0 with size 3
a[tuple(s)]
"""array([[ 2,  5],
       [ 7, 11]])"""
使用数组索引的另一个常见用途是寻找时间依赖序列的最大值:
time = np.linspace(20,145,5) #20-145之间取5 个数
time #array([ 20.  ,  51.25,  82.5 , 113.75, 145.  ])
data = np.sin(np.arange(20)).reshape(5,4)
data
"""array([[ 0.        ,  0.84147098,  0.90929743,  0.14112001],
       [-0.7568025 , -0.95892427, -0.2794155 ,  0.6569866 ],
       [ 0.98935825,  0.41211849, -0.54402111, -0.99999021],
       [-0.53657292,  0.42016704,  0.99060736,  0.65028784],
       [-0.28790332, -0.96139749, -0.75098725,  0.14987721]])"""
ind = data.argmax(axis=0)#每一列最大值的索引
ind #array([2, 0, 3, 1])
time_max = time[ind]
time_max #array([ 82.5 ,  20.  , 113.75,  51.25])
data_max = data[ind,range(data.shape[1])]
data_max #array([0.98935825, 0.84147098, 0.99060736, 0.6569866 ])
np.all(data_max ==data.max(axis=0))
我们可以根据数组索引重置目标数值:
a = np.arange(5)
a +=1
a
a[[1,3,4]]=999 #索引位置,而不是其中的值
a #array([  1, 999,   3, 999, 999])
当切片列表包含重复值时,赋值会重复操作,但保留最后一个,在本案例中金蒜 0 出现 2 次,第 0 个元素只操作了 1 次。这是因为 a +=1 等同于 a = a+1
a = np.arange(5)
a[[0, 0, 2]] += 1
a #array([1, 1, 3, 3, 4])
布尔数组索引
当我们使用(整型)数组索引数组时,我们需要提供要选择的索引列表。对于布尔索引,方法与数值型不同,在布尔索引中,我们明确数组中想要与不想要的项目。我们可以想到的最自然的方法就是使用与原始数组形状一直的布尔数组,此外我们还可以重置数组中的值。
n = np.arange(12).reshape(3,4)
b = n >4
b
"""array([[False, False, False, False],
       [False,  True,  True,  True],
       [ True,  True,  True,  True]])"""
n[b]#array([ 5,  6,  7,  8,  9, 10, 11]) 选择出所有 True 的值
n[b] = 0
n #n 中所有 True 的值重置为 0
"""array([[0, 1, 2, 3],
       [4, 0, 0, 0],
[0, 0, 0, 0]])"""以下例子可以了解如何使用布尔数组索引去生成曼德尔布罗特集的图像:
import numpy as np
import matplotlib.pyplot as plt
def mandelbrot(h,w,maxit = 20,r = 2):
    x = np.linspace(-2.5,1.5,4*h+1)
    y = np.linspace(-1.5,1.5,3*w+1)
    A,B = np.meshgrid(x,y)
    C = A+B*1j
    z = np.zeros_like(C)
    divtime = maxit +np.zeros(z.shape,dtype= int)

    for i in range(maxit):
        z = z**2+C
        diverge = abs(z)>r
        div_now = diverge&(divtime == maxit)
        divtime[div_now]=i
        z[diverge] = r

    return divtime
plt.imshow(mandelbrot(400,400))
第二种布尔索引方式与整型索引更相似,对于数组的每个维度,我们都可以提供一个一维的布尔数组用于选择我们的目标对象:
a = np.arange(12).reshape(3,4)
b1 = np.array([False,True,True]) #1st
b2 = np.array([True,False,True,False]) #2nd
a[b1,:]
"""array([[ 4,  5,  6,  7],
       [ 8,  9, 10, 11]])"""
a[:,b2]
"""array([[ 0,  2],
       [ 4,  6],
       [ 8, 10]])"""
a[b1,b2] #array([ 4, 10])
注:1μ的布尔数组的长度必须与你期望索引的维度的长度一致。上面实例中,b1 的长度为 3(a 行数为 3),b2 的长度为 4,与第二维的长度一致。
ix_() 函数
ix_() 函数用于组合不同向量,以获得每个n-uplet的结果。例如:如果你想计算所有向量 a、b 和 c 所有triplets 的 a+b*c 的值
a = np.array([2,3,4,5])
b = np.array([8,5,4])
c = np.array([5,4,6,8,3])
ax,bx,cx = np.ix_(a,b,c)
ax #第一维度形成三维数组
"""array([[[2]],

       [[3]],

       [[4]],

       [[5]]])"""
bx# 第二维度形成数组
"""array([[[8],
        [5],
        [4]]])"""
cx# 第三维度形成数组
"""array([[[5, 4, 6, 8, 3]]])"""
ax.shape, bx.shape, cx.shape
"""((4, 1, 1), (1, 3, 1), (1, 1, 5))"""
result = ax+bx*cx
result
"""array([[[42, 34, 50, 66, 26],
        [27, 22, 32, 42, 17],
        [22, 18, 26, 34, 14]],

       [[43, 35, 51, 67, 27],
        [28, 23, 33, 43, 18],
        [23, 19, 27, 35, 15]],

       [[44, 36, 52, 68, 28],
        [29, 24, 34, 44, 19],
        [24, 20, 28, 36, 16]],

       [[45, 37, 53, 69, 29],
        [30, 25, 35, 45, 20],
        [25, 21, 29, 37, 17]]])"""
result[3,2,4] #17
a[3]+b[2]*c[4] #17
也可以将其按照下列方式减少
def ufunc_reduce(ufct,*vectors):
    vs = np.ix_(*vectors)
    r = ufct.identity
    for v in vs:
        r = ufct(r,v)
    return r

ufunc_reduce(np.add,a,b,c)
"""array([[[15, 14, 16, 18, 13],
        [12, 11, 13, 15, 10],
        [11, 10, 12, 14,  9]],

       [[16, 15, 17, 19, 14],
        [13, 12, 14, 16, 11],
        [12, 11, 13, 15, 10]],

       [[17, 16, 18, 20, 15],
        [14, 13, 15, 17, 12],
        [13, 12, 14, 16, 11]],

       [[18, 17, 19, 21, 16],
        [15, 14, 16, 18, 13],
        [14, 13, 15, 17, 12]]])"""
比起 ufunc.reduce,此版本的 reduce 可以利用广播规则去避免创建一个数组相乘后的大小的参数数组。
字符串索引
请参阅结构化数组。
技巧和窍门
“自动”修改形状:一个适量维度的改变,你可以省略一个大小,自动推算(-1么)
a = np.arange(30)
>>> b = a.reshape((2, -1, 3))  # -1 means "whatever is needed"
>>> b.shape
(2, 5, 3)矢量堆叠:我们如何利用一些相同大小的数量构建一个二维数组?在 MATLAB 中:假如xy 两个矢量的长度相同,然后你只需要使用m=[x;y]即可完成。在 NumPy,该功能可以根据需要堆叠的温度,通过 column_stack, dstack, hstack 和 vstack函数完整。
x = np.arange(0, 10, 2)
>>> y = np.arange(5)
>>> m = np.vstack([x, y])
>>> m
array([[0, 2, 4, 6, 8],
       [0, 1, 2, 3, 4]])
>>> xy = np.hstack([x, y])
>>> xy
array([0, 2, 4, 6, 8, 0, 1, 2, 3, 4])其他资料:适用于MATLAB用户的NumPy
直方图
应用于一个数组的直方图函数返回一对向量:数组直方图和图边缘向量。注:matplotlib 也提供直方图函数(hist)与 NumPy 的直方图不同,pylab.hist会自动生产直方图,而 NumPy.histogram 只能生成数据。
import numpy as np
rg = np.random.default_rng(1)
import matplotlib.pyplot as plt
mu, sigma = 2,0.5
v = rg.normal(mu,sigma,1000)
v #一个一维数组,一共 1000 个元素,取值范围在 0.5-2 之间
plt.hist(v,bins = 50,density=True)
(n,bins) = np.histogram(v,bins=50,density=True)
plt.plot(.5*(bins[1:]+bins[:-1]),n)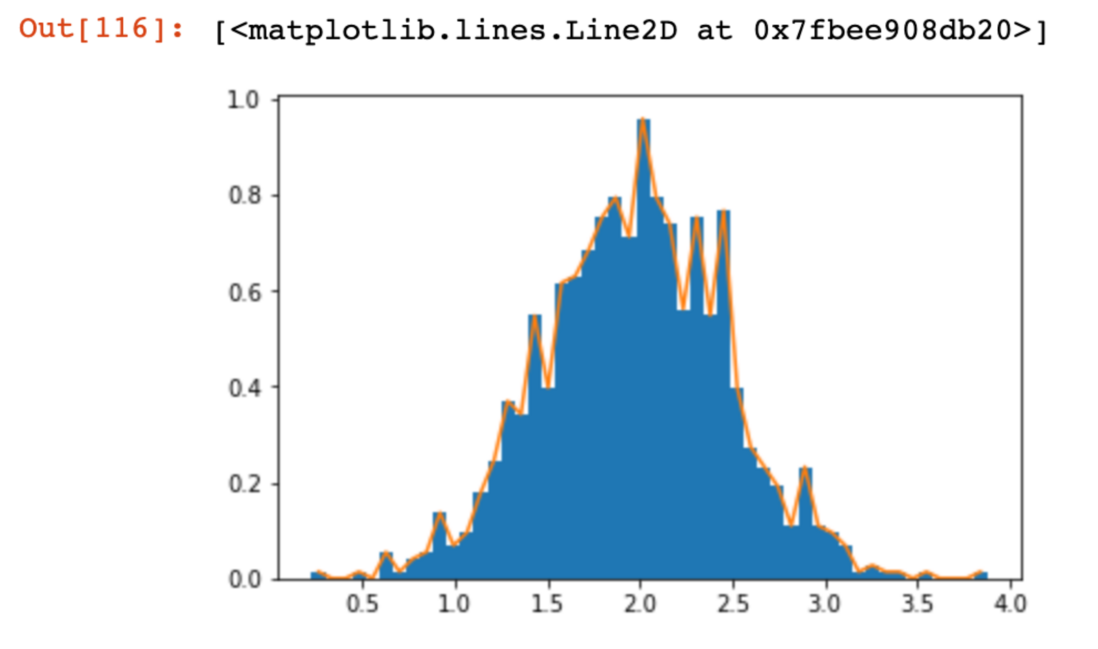
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论